Tutaj opisujemy protokół efektywnej immunoprecypitacji chromatyny (ChIP), a następnie wysokoprzepustowego sekwencjonowania DNA (ChIP-seq) brunatnej tkanki tłuszczowej (BAT) wyizolowanej od myszy. Protokół ten nadaje się zarówno do mapowania modyfikacji histonów, jak i badania lokalizacji w całym genomie białek niehistonowych będących przedmiotem zainteresowania in vivo.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł metodologiczny
Immunoprecypitacja chromatyny mysiej brunatnej tkanki tłuszczowej
W tym artykule
Podsumowanie
Streszczenie
Większość procesów komórkowych jest regulowana przez modulację transkrypcyjną określonych programów genowych. Taką modulację uzyskuje się poprzez połączone działanie szerokiego zakresu czynników transkrypcyjnych (TF) i kofaktorów pośredniczących w aktywacji lub represji transkrypcji poprzez zmiany w strukturze chromatyny. Immunoprecypitacja chromatyny (ChIP) jest użytecznym podejściem biologii molekularnej do mapowania modyfikacji histonów i profilowania czynników transkrypcyjnych/kofaktorów wiążących się z DNA, zapewniając w ten sposób obraz dynamicznych zmian jądrowych zachodzących podczas różnych procesów biologicznych.
Aby badać regulację transkrypcji w tkance tłuszczowej, próbki pochodzące z hodowli komórkowych in vitro unieśmiertelnionych lub pierwotnych linii komórkowych są często preferowane w testach ChIP ze względu na obfitość materiału wyjściowego i zmniejszoną zmienność biologiczną. Jednak modele te reprezentują ograniczoną migawkę rzeczywistego stanu chromatyny w organizmach żywych. W związku z tym istnieje krytyczna potrzeba zoptymalizowanych protokołów do wykonywania ChIP na próbkach tkanki tłuszczowej pochodzących z modeli zwierzęcych.
Tutaj opisujemy protokół skutecznego sekwencjonowania ChIP-zarówno modyfikacji histonów, jak i nie-histonów białek w brunatnej tkance tłuszczowej (BAT) wyizolowanej od myszy. Protokół jest zoptymalizowany pod kątem badania lokalizacji białek będących przedmiotem zainteresowania w całym genomie i markerów epigenetycznych w BAT, który jest morfologicznie i fizjologicznie odrębną tkanką wśród magazynów tłuszczu.
Wprowadzenie
Podczas gdy biała tkanka tłuszczowa (WAT) specjalizuje się w magazynowaniu energii, brązowa tkanka tłuszczowa (BAT) rozprasza energię w postaci ciepła dzięki swojej zdolności do przekształcania węglowodanów i lipidów w energię cieplną poprzez rozprzęganie mitochondriów1. Ze względu na tę wyspecjalizowaną funkcję magazyn BAT jest niezbędny do utrzymania temperatury ciała w warunkach fizjologicznych i w odpowiedzi na ekspozycję na zimno. Podczas gdy zmiany ekspresji genów podczas różnicowania BAT i stresu termogenicznego były szeroko badane in vivo i in vitro, mechanizmy molekularne leżące u podstaw tych zmian zostały w większości przeanalizowane w unieśmiertelnionych liniach komórkowych i pierwotnych preadipocytach, z wyjątkiem kilku badań in vivo2,3,4,5.
Regulacja określonych programów ekspresji genów poprzez regulację transkrypcji jest osiągana poprzez skoordynowane zmiany w strukturze chromatyny poprzez różne czynniki transkrypcyjne i działania kofaktorów. Immunoprecypitacja chromatyny (ChIP) jest cennym podejściem biologii molekularnej do badania rekrutacji tych czynników do DNA i profilowania związanych z tym zmian w krajobrazie chromatyny. Kluczowymi czynnikami decydującymi o powodzeniu eksperymentów ChIP są optymalizacje warunków sieciowania i konsystencji ścinania chromatyny w różnych próbkach, dostępność odpowiedniego materiału wyjściowego oraz, co najważniejsze, jakość przeciwciał. Podczas wykonywania ChIP z całych tkanek ważne jest również, aby wziąć pod uwagę niejednorodność próbek i zoptymalizować protokół w celu poprawy skuteczności izolacji jąder, przy czym ten ostatni jest szczególnie wrażliwym etapem podczas pracy z tkanką tłuszczową ze względu na podwyższoną zawartość lipidów. W rzeczywistości techniki izolacji molekularnej z całych magazynów tłuszczu są skomplikowane ze względu na obecność wysokich poziomów trójglicerydów, a protokoły muszą być zoptymalizowane, aby zwiększyć ilość izolacji chromatyny. Wreszcie, gdy sekwencjonowanie o wysokiej przepustowości jest wykonywane po izolacji ChIP-DNA, głębokość sekwencjonowania ma kluczowe znaczenie dla określenia liczby pików, które są z pewnością wykrywane.
Tutaj odnosimy się do standardów pracy i ogólnych wytycznych dla eksperymentów ChIP-seq zalecanych przez konsorcja ENCODE i modENCODE6 dla najlepszych praktyk i skupiamy się na opisie krok po kroku protokołu zoptymalizowanego pod kątem ChIP-seq z BAT. Opisany protokół pozwala na sprawną izolację chromatyny z tkanki tłuszczowej w celu przeprowadzenia sekwencjonowania całego genomu pod kątem czynników wiążących DNA z dobrze zdefiniowanymi pikami, a także znaczników histonowych z bardziej rozproszonymi sygnałami.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
Etapy postępowania ze zwierzętami w protokole zostały zatwierdzone przez Komitet ds. Opieki nad Zwierzętami i Użytkowania Zwierząt Uniwersytetu Bostońskiego (IACUC).
1. Dzień 1: Sekcja i przygotowanie BAT do immunoprecypitacji chromatyny (ChIP)
- Poddaj myszy eutanazji za pomocą komory na dwutlenek węgla (CO2 ), a następnie natychmiast po niej wykonaj sekcję. Spryskaj futro myszy 70% etanolem przed nacięciem. Umieść mysz tyłem do góry, a następnie rozetnij skórę wzdłuż szyi. Umieść BAT bezpośrednio pod skórą między łopatkami (międzyłopatkowymi; wygląda jak dwa płaty w kształcie motyla, z cienką warstwą białego tłuszczu, którą należy ostrożnie usunąć7).
nuta: W przypadku 3-miesięcznej myszy C57BL/6J, która jest karmiona regularną dietą (masa myszy w tym wieku waha się między 27 a 30 g), każdy płat BAT ma około 1 cm długości. Całkowita masa magazynu BAT wynosi około 0,15 g zarówno u samców, jak i samic myszy. - Użyj 1 podkładki BAT dla 3 ChIP. Wiele pól lutowniczych BAT może być przetwarzanych jednocześnie aż do uzyskania sonikacji.
- Każdą podkładkę BAT należy rozformować w 10 ml soli fizjologicznej buforowanej fosforanami (PBS) zawierającej 1% formaldehydu przez 15 minut, obracając się z prędkością 150 obr./min w temperaturze pokojowej (RT).
- Utwardzanie sieciowania poprzez dodanie 2,5 M glicyny do końcowego stężenia 125 mM przez 5 minut, obracając się z prędkością 150 obr./min przy wilgotności względnej.
- Przenieść elektrod BAT do 500 μl hipotonicznego buforu do lizy (10 mM HEPES, 1,5 mM MgCl2, 10 mM KCl, 0,5 mM naziemnej telewizji cyfrowej, 0,2 mM PMSF) i dodać 2 kulki ze stali nierdzewnej (rozmiar: średnica 3,2 mm, zob. tabela materiałów) dla każdej podkładki BAT. Użyj homogenizatora tkankowego na bazie kulek (patrz Tabela materiałów), aby rozdrobnić tkankę.
- Zacznij od 5 minut przy maksymalnej mocy. W razie potrzeby wydłuż czas do homogenizacji tkanki i oddzielenia pojedynczych komórek. Przenieść próbki do nowej probówki i odwirować w temperaturze 4 °C przy 16 000 x g przez 10 minut.
- Po odwirowaniu przenieść supernatant do nowej probówki i utrzymać osad komórkowy na lodzie. Odwirować supernatant w temperaturze 4 °C przy 16 000 x g przez 10 minut, aby zapobiec utracie pływających komórek. Odrzucić końcowy supernatant i ponownie zawiesić oba osady komórek razem w 300 μl buforu do lizy SDS (SDS 1%; EDTA 10 mM; Tris-HCl pH 8, 50 mM) z 1x inhibitorem proteazy (patrz tabela materiałów). Inkubować na lodzie przez 10 minut.
- Sonikacja lizatów w celu wytworzenia fragmentów DNA o długości 200–500 par zasad. Po sonikacji usunąć zanieczyszczenia przez wirowanie przez 10 minut w temperaturze 16 000 x g w temperaturze 4 °C i sprawdzić powodzenie sonikacji za pomocą elektroforezy DNA na 1% żelu agarozowym. W przypadku żelu średniej wielkości uruchom pod napięciem 120 V; Dobrą separację uzyskuje się po 45 min.
nuta: Optymalizacja sonikacji może być wymagana do uzyskania odpowiedniej wielkości fragmentów. Z wybranym sonikatorem (patrz Tabela Materiałów), wymaga to 2 razy przy mocy wyjściowej 320 W i częstotliwości 20 KHz przez 10 minut, przy cyklach 30 s włączenia/30 s wyłączenia. - Rozcieńczyć frakcję sklarowanego osadu 10-krotnie (końcowa objętość wynosi 3 ml na każdą podkładkę BAT) w buforze rozcieńczającym ChIP (SDS 0,01%; Tryton 1,1%; EDTA 1,2 mM; Tris-HCl pH 8, 16,7 mM; NaCl 167 mM) z 1x inhibitorem proteazy. Odłóż na bok 1% tego roztworu chromatyny (równego 30 μl na 3 ml) jako wejście ChIP. Utrzymuj wejścia przez noc w temperaturze 4 °C (do kroku 2.4).
Uwaga: Powyższa frakcja będzie stanowić odniesienie wejściowe dla względnej kwantyfikacji materiału immunoprecypitowanego w porównaniu z ilością DNA obecnego w każdej próbce przed immunoprecypitacją. - Dodać przeciwciało ChIP (patrz Tabela materiałów dla przeciwciał użytych tutaj jako przykład) do 1 ml roztworu chromatyny i inkubować przez noc w temperaturze 4 °C z rotacją. Przeprowadzić równoległą immunoprecypitację z odpowiednimi przedimmunologicznymi IgG, jeśli są dostępne, lub normalnymi IgG tego samego gatunku (np. zwykłą króliczą IgG, jeśli przeciwciało jest wytwarzane u królika). Alternatywnie, zachowaj 1 ml roztworu chromatyny na kontrolę bez przeciwciał.
nuta: Optymalna ilość przeciwciał powinna być oznaczona doświadczalnie dla każdego nowego przeciwciała, jeśli stężenie przeciwciał nie jest znane. W przeciwnym razie 2-5 μg przeciwciał jest rozsądną ilością wyjściową do użycia. Jeśli to możliwe, należy stosować przeciwciała klasy ChIP lub przeciwciała, które zostały zwalidowane pod kątem immunoprecypitacji.
2. Dzień 2: Zbiór kompleksów immunologicznych
- Dodać 50 μl zawiesiny Protein A Agaroza 50% do kompleksów immunologicznych i inkubować przez 1 godzinę w temperaturze 4 °C z obrotami 150 obr./min.
- Granulki osadzać przez odwirowanie przez 1 minutę przy 100 x g w temperaturze 4 °C. Przeprowadzić sekwencyjne płukanie kulek za pomocą o rosnącej surowości.
- Najpierw przemyć buforem do płukania o niskiej zawartości soli (150 mM NaCl; Tris-HCl pH 8,20 mM; EDTA 2 mM; Tryton-X 1%; SDS 0,1%), a następnie z buforem płuczącym o wysokiej zawartości soli (500 mM NaCl; Tris-HCl pH 8,20 mM; EDTA 2 mM, Triton-X1%; SDS 0,1%), a następnie z płukaniem LiCl (0,25 M LiCl; Tris-HCl pH 8,10 mM; EDTA 1 mM; Igepal 1%; deoksycholan 1%), a na koniec z 1x TE (Tris-HCl pH 8, 10 mM; EDTA).
- Wszystkie płukania należy wykonać na odśrodkowych kolumnach filtracyjnych PVDF o średnicy 0,45 μm (tabela materiałów), przenosząc najpierw kulki w kolumnach za pomocą 500 μl buforu do płukania o niskiej zawartości soli. Granulować kulki w kolumnach przez 3 minuty przy 2,500 x g. Odrzucić przepływ i powtórzyć 1 raz dla wszystkich płuczących wymienionych w kroku 2.2.1.
- Po zakończeniu płukania eluować kompleksy immunologiczne, dodając 300 μl buforu elucyjnego 1% SDS, 0,1 M NaHCO3) do granulowanych kulek w kolumnach. Inkubować w temperaturze pokojowej przez 30 minut na wytrząsarce z prędkością 400 obr./min. Zebrać eluat, obracając kolumny przez 3 minuty przy 2,500 x g w świeżej probówce.
- Odwrócić usieciowania krzyżowe poprzez inkubację eluatu i danych wejściowych zebranych w kroku 1.9 w temperaturze 65 °C przez noc.
3. Dzień 3: Odzyskiwanie DNA za pomocą ekstrakcji fenolu/chloroformu
- Dodać 300 μl fenolu:chloroformu:IAA, 1:1 do eluatu i wejść. Wir przez 10 s.
- Wirować w temperaturze 4 °C przez 15 minut przy 21 000 x g. Przenieść supernatant do świeżej probówki. Dodaj 3 μl glikogenu, 30 μl 3 M octanu sodu i 750 μl zimnego 100% etanolu. Wir przez 10 s. Przechowywać w temperaturze -80 °C przez 2 godziny.
- Wirować w temperaturze 21 000 x g w temperaturze 4 °C przez 20 minut, zachować osad i wyrzucić supernatant. Umyć granulat 1 ml zimnego 70% EtOH, a następnie odwirować w temperaturze 21 000 x g w temperaturze 4 °C przez 5 minut. Wyrzucić supernatant i wysuszyć osad na powietrzu.
- Zawiesić osad w 70 μl wody wolnej od DNAzy.
- Przejdź do kroku 4 w celu zbadania zajętości chromatyny w określonych regionach genomu za pomocą ilościowej reakcji łańcuchowej polimerazy (qPCR) lub do kroku 5 w celu przygotowania próbek do sekwencjonowania.
4. Analiza ChIP za pomocą qPCR (Single/Multiple Genes Readout)
- Rozcieńczyć wejściowy DNA z kroku 3.4, aby wygenerować standardową krzywą odniesienia. Seryjne rozcieńczenia 1/10, 1/100 i 1/1000 są zwykle wystarczające do uchwycenia zakresu liniowego, ale w przypadku bardziej skoncentrowanych próbek mogą być wymagane dalsze rozcieńczenia.
- Dla każdej pary starterów (tutaj użyliśmy starterów ukierunkowanych na promotory NDUFV1 i TOMM20) przygotuj dwa zestawy reakcji qPCR: jeden przy użyciu rozcieńczonych próbek wejściowych z kroku 4.1, a drugi z próbkami DNA wyizolowanymi przez immunoprecypitację z kroku 3.4. Każdą reakcję należy przeprowadzić w trzech egzemplarzach.
nuta: Reakcje można przeprowadzać równolegle dla wielu genów przy użyciu płytek 96- lub 384-dołkowych. - Ustawić objętość reakcji 10 μl na studzienkę z 5 μl mieszaniny 2x PCR (tabela materiałów), 1 μl mieszanki starterów (1 μM startera do przodu i 1 μM startera odwrotnego) i 4 μL DNA z ChIP (lub kontroli wejściowej).
- Krótko odkręć talerz.
- Uruchom reakcje qPCR w systemie PCR w czasie rzeczywistym przy użyciu protokołu zalecanego przez producenta do wykrywania odczynników (Tabela materiałów). Tutaj użyliśmy następujących warunków: 1) 1s w temperaturze 95°C przez 1 cykl; 2) 1 s w temperaturze 95 °C, a następnie 20 s w temperaturze 60 °C przez 45 cykli; 3) 15 s w 95 °C, następnie 60 s w 60 °C, a następnie 15 s w 95 °C przez 1 cykl.
nuta: Sprawdź krzywą dysocjacji: obecność jednego piku na wykresie dysocjacji termicznej sugeruje, że w wyniku reakcji PCR generowany jest pojedynczy amplikon. Jeśli wizualizowany jest więcej niż jeden pik, może to wskazywać na wiele, niespecyficznych amplikonów; W takim przypadku zalecamy zaprojektowanie alternatywnych par podkładów. - Określić liniową fazę wykładniczej amplifikacji reakcji PCR dla każdego zestawu starterów, obliczając krzywą wzorcową przy użyciu serii rozcieńczonego genomowego DNA w kroku 4.1. zgodnie z wartością Ct (próg cyklu).
- Jeżeli wartość Ct DNA z ChIP i kontrola wejściowa mieszczą się w liniowym zakresie wartości Ct, należy obliczyć wzbogacenie DNA z ChIP w stosunku do danych wejściowych, zgodnie ze współczynnikiem rozcieńczenia DNA z ChIP i kontrolą wejściową w kroku 4.1.
5. Amplifikacja DNA z ChIP do sekwencjonowania wysokoprzepustowego (odczyt całego genomu)
UWAGA: Ten krok może być zlecony do głównego ośrodka akademickiego lub komercyjnej firmy zajmującej się sekwencjonowaniem, gdy możliwości sekwencjonowania nie są dostępne we własnym zakresie.
- Przygotuj bibliotekę DNA z wyekstrahowanego DNA za pomocą odpowiedniego zestawu do przygotowania biblioteki ChIP (patrz Spis materiałów) zgodnie z instrukcjami producenta.
- Sekwencjonuj bibliotekę w systemie sekwencjonowania o wysokiej przepustowości, używając 50 bp pojedynczego końca jako odczytu (patrz Tabela materiałów).
nuta: Zgodnie z wytycznymi ChIP-seq sugerowanymi przez ENCODE6, dla genomów ssaków zaleca się co najmniej 10 milionów odczytów.
6. Analiza surowych danych
- Przeprowadzanie kontroli jakości odczytów sekwencjonowania surowego za pomocą FastQC8.
nuta: Typowe metryki jakości sekwencjonowania obejmują jakość sekwencji podstawowej, zawartość sekwencji podstawowej, zawartość GC sekwencji, długość sekwencji i poziomy duplikacji sekwencji. Ogólnie rzecz biorąc, wynik jakości odczytu wynoszący Q > 30 na każdej pozycji podstawowej wskazuje na wysokiej jakości wyniki sekwencjonowania. Rozkład zawartości GC we wszystkich odczytach powinien z grubsza przypominać rozkład normalny, z pikiem wyśrodkowanym wokół rzeczywistego procentowego procentu zawartości GC genomu gatunku. - Usuń wszelkie zanieczyszczenia adaptera sekwencjonowania i odczyty niskiej jakości za pomocą narzędzia do przycinania odczytu Trimmomatic9.
nuta: Zaimplementowane parametry domyślne określają usuwanie adapterów zależnych od platformy, usuwanie wiodących i końcowych baz niskiej jakości oraz użycie 4-bazowego okna przesuwnego do przycinania odczytów, gdy średnia jakość na bazę spadnie poniżej określonego progu. - Wyrównaj przetworzone odczyty do mysiego MM10 reference genome10 z Bowtie2 aligner11 przy użyciu parametrów domyślnych.
- Filtruj wyrównane odczyty, usuwając te z wynikiem jakości mapowania Bowtie2 (MAPQ) mniejszym niż 10 za pomocą Samtools12.
- Określ różne wskaźniki jakości po wyrównaniu, takie jak procent zmapowanych odczytów, korelacja krzyżowa nici, skumulowane pokrycie odczytu i odtwarzalność replikacji próbki.
Uwaga: Do obliczania tych wskaźników jakości dostępne są różne pakiety, w tym SPP13, ChIPqc14 i Deeptools15. - Wykonaj analizę wywołania szczytowego z kontrolką wejściową lub odpowiednią próbką KO przy użyciu algorytmu MACS (MACS2)16 z parametrami domyślnymi.
- Usuń wszystkie wywołane szczyty, które pokrywają się ze znanymi regionami znajdującymi się na czarnej liście17 z adnotacji mm10 za pomocą Bedtools18.
nuta: Regiony znajdujące się na czarnej liście to obszary genomu, w przypadku których, jak wykazano, mają wysoką liczbę sygnałów lub odczytów, niezależnie od linii komórkowej lub techniki sekwencjonowania. Regiony te wykazują sztucznie zawyżone sygnały artefaktów w niektórych regionach genomu, które można odfiltrować z eksperymentów funkcjonalnego sekwencjonowania genomu. Wszystkie powtórzenia powinny być przetwarzane niezależnie przez potok, a następnie mogą być używane do pomiaru współczynnika wykrywania nieodtwarzalności (IDR). IDR służy do pomiaru odtwarzalności wyników między powtórzeniami za pomocą metody opisanej przez Li, Browna, Huanga i Bickela19,20. Metoda IDR ilościowo ocenia spójność między powtórzeniami i jest zalecana przez ENCODE i modENCODE jako część ich wytycznych dotyczących sekwencji ChIP. - Używaj statystycznie istotnych pików do różnych dalszych analiz, takich jak ontologia genów21,22, wzbogacenie lub analiza motywu23.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
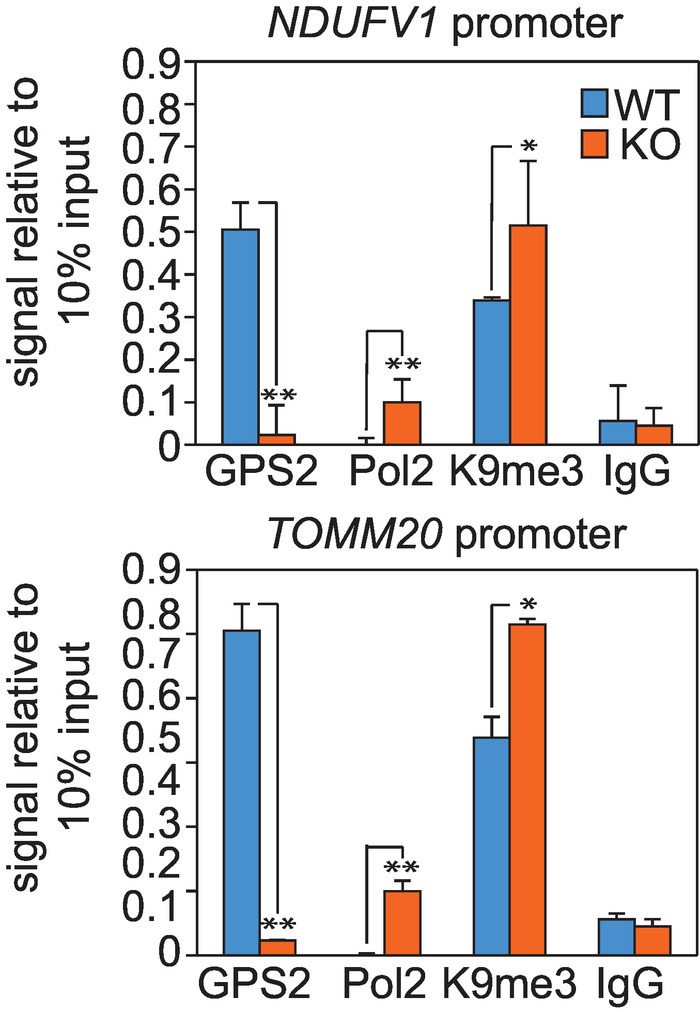
Rysunek 1: Walidacja ChIP metodą qPCR. Analiza ChIP-qPCR reprezentatywnych genów docelowych GPS2: NDUFV1 (lewo) oraz TOMM20 (prawo) w BAT myszy WT i GPS2-AKO, pokazująca względne zmiany poziomu metylacji H3K9 oraz w...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
Opisany tutaj protokół stanowi cenne narzędzie do wykonywania ChIP z tkanek mysich, specjalnie zoptymalizowane pod kątem brunatnej tkanki tłuszczowej. Jednym z większych wyzwań w przeprowadzaniu ChIP z tkanek jest odzyskanie wystarczającej liczby komórek podczas przygotowywania próbki. Strzyżenie BAT za pomocą mieszalnika do homogenizacji tkanek w połączeniu z kulkami ze stali nierdzewnej zamiast kanonicznego szklanego tłuczka znacznie zmniejsza liczbę komórek utraconych z powodu nieuszkodzonej tkanki. Co więcej, homogen...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Homogenizator tkankowy Bullet Blender | Następna przygoda | BBX24 | |
| Koraliki ze stali nierdzewnej o średnicy 3,2 mm Następna | Advence | SSB32 | |
| Bioruptor Sonicator | Diagenode | ||
| 1,5 ml Mikrorurka TPX Plastik | Diagenode | C30010010-5 | |
| Kompletny inhibitor proteazy | Roche | ||
| Białko A Zawiesina agarozy | Invitrogen | ||
| Przeciwciało GPS2 | W domu | Królik poliklonalny, przeciwciało Ct (Cardamone i wsp., Mol Cell 2018) | |
| Przeciwciało Pol2 | Diagenode | C15100055 | |
| przeciwciało h3K9me3 | Millipore | 05-1242 | |
| Fast Syber Green Master Mix | Aplied Biosytem | 4385612 | |
| ViiA7 | Aplied Biosytem | ||
| TruSeq ChIP Zestaw do przygotowania biblioteki | Illumina | IP-202-1012 | |
| HiSeq 2000 | Iluminacja |
Bibliografia
- Cannon, B., Nedergaard, J. Brown adipose tissue: function and physiological significance. Physiological Reviews. , (2004).
- Cardamone, M. D., et al. Mitochondrial Retrograde Signaling in Mammals Is Mediated by the Transcriptional Cofactor GPS2 via Direct Mitochondria-to-Nucleus Translocation. Molecular Cell. 69, (2018).
- Emmett, M. J., et al. Histone deacetylase 3 prepares brown adipose tissue for acute thermogenic challenge. Nature. , (2017).
- Harms, M. J., et al. PRDM16 binds MED1 and controls chromatin architecture to determine a brown fat transcriptional program. Genes & Development. , (2015).
- Shapira, S. N., et al. EBF2 transcriptionally regulates brown adipogenesis via the histone reader DPF3 and the BAF chromatin remodeling complex. Genes & Development. , (2017).
- Landt, S. G., et al. ChIP-seq guidelines and practices of the ENCODE and modENCODE consortia. Genome Research. 22, 1813-1831 (2012).
- Liisberg Aune, U., Ruiz, L., Kajimura, S. Isolation and Differentiation of Stromal Vascular Cells to Beige/Brite Cells. Journal of Visualized Experiments. , e50191(2013).
- Andrews, S. FastQC: a quality control tool for high throughput sequence data. , Available from: http://www.bioinformatics.babraham.ac.uk/projects/fastqc (2010).
- Bolger, A. M., Lohse, M., Usadel, B. Trimmomatic: a flexible trimmer for Illumina sequence data. Bioinformatics. 30, 2114-2120 (2014).
- Genome Browser Gateway. , Available from: https://genome.ucsc.edu/cgi-bin/hgGateway?db=mm10 (2018).
- Langmead, B., Salzberg, S. L. Fast gapped-read alignment with Bowtie 2. Nature Methods. , 357-359 (2012).
- Li, H., et al. The Sequence alignment/map (SAM) format and SAMtools. Bioinformatics. 25 (16), 2078-2079 (2009).
- Kharchenko, P. V., Tolstorukov, M. Y., Park, P. J. Design and analysis of ChIP-seq experiments for DNA-binding proteins. Nature Biotechnology. 26, 1351-1359 (2008).
- Carroll, T. S., Liang, Z., Salama, R., Stark, R., de Santiago, I. Impact of artifact removal on ChIP quality metrics in ChIP-seq and ChIP-exo data. Frontiers in Genetics. 5, 75(2014).
- Ramírez, F., et al. deepTools2: A next Generation Web Server for Deep-Sequencing Data Analysis. Nucleic Acids Research. , (2016).
- Zhang, Y., et al. Model-based Analysis of ChIP-Seq (MACS). Genome Biology. 9, R137(2008).
- ENCODE Project Consortium. An integrated encyclopedia of DNA elements in the human genome. Nature. 489 (7414), 57-74 (2012).
- Quinlan, A. R., Hall, I. M. BEDTools: a flexible suite of utilities for comparing genomic features. Bioinformatics. 26, 841-842 (2010).
- Li, Q., Brown, J. B., Huang, H., Bickel, P. J. Measuring reproducibility of high-throughput experiments. Annals of Applied Statistics. 5 (3), 1752-1779 (2011).
- Irreproducible Discovery Rate (IDR). , Available from: https://github.com/nboley/idr (2018).
- The Gene Ontology Consortium. Expansion of the Gene Ontology Knowledgebase and Resources. Nucleic Acids Research. 45, D331-D338 (2017).
- Ashburner, M., et al. Gene Ontology: tool for the unification of biology. Nature Genetics. 25, 25-29 (2000).
- Boeva, V. Analysis of Genomic Sequence Motifs for Deciphering Transcription Factor Binding and Transcriptional Regulation in Eukaryotic Cells. Frontiers in Genetics. 7, 24(2016).
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Przedruki i uprawnienia
