Tutaj opisujemy protokoły analizy i wizualizacji struktury i budowy całego repertuaru przeciwciał. Wiąże się to z pozyskiwaniem ogromnych sekwencji RNA przeciwciał za pomocą sekwencjonowania nowej generacji.
Artykuł metodologiczny
Identyfikacja repertuaru przeciwciał mysich i ludzkich za pomocą sekwencjonowania nowej generacji
W tym artykule
Podsumowanie
Streszczenie
Ogromna zdolność adaptacyjna rozpoznawania antygenu przez przeciwciała jest podstawą nabytego układu odpornościowego. Pomimo naszego zrozumienia mechanizmów molekularnych leżących u podstaw wytwarzania szerokiego repertuaru przeciwciał przez nabyty układ odpornościowy, nie udało nam się jeszcze uzyskać globalnego obrazu pełnego repertuaru przeciwciał. W szczególności repertuar limfocytów B został uznany za czarną skrzynkę ze względu na astronomiczną liczbę klonów przeciwciał. Jednak technologie sekwencjonowania nowej generacji umożliwiają przełomowe odkrycia, które pozwalają nam lepiej zrozumieć repertuar limfocytów B. W tym raporcie opisujemy prostą i skuteczną metodę wizualizacji i analizy całego repertuaru przeciwciał mysich i ludzkich. Z narządów odpornościowych, reprezentatywnie dla śledziony u myszy i komórek jednojądrzastych krwi obwodowej u ludzi, przygotowano całkowite RNA, dokonano odwrotnej transkrypcji i amplifikacji metodą 5'-RACE. Stosując uniwersalny starter do przodu i startery antysensowne dla domen stałych specyficznych dla klasy przeciwciał, mRNA przeciwciał były jednolicie amplifikowane w proporcjach odzwierciedlających ich częstość w populacjach przeciwciał. Amplikony sekwencjonowano za pomocą sekwencjonowania nowej generacji (NGS), uzyskując ponad 105 sekwencji przeciwciał na próbkę immunologiczną. Opisujemy protokoły analiz sekwencji przeciwciał, w tym adnotację segmentu genu V(D)J, widok z lotu ptaka na repertuar przeciwciał oraz nasze metody obliczeniowe.
Wprowadzenie
System przeciwciał jest jednym z fundamentów nabytego układu odpornościowego. Jest bardzo silny przeciwko inwazyjnym patogenom ze względu na swoją ogromną różnorodność, delikatną specyficzność rozpoznawania antygenu i klonalną ekspansję komórek B specyficznych dla antygenu. Szacuje się, że repertuar limfocytów B wytwarzających przeciwciała wynosi więcej niż 1015 u jednej osoby1. Ta ogromna różnorodność jest generowana za pomocą rekombinacji genu VDJ w loci2. Opisanie całego repertuaru limfocytów B i ich dynamicznych zmian w odpowiedzi na immunizację antygenową jest zatem trudne, ale niezbędne do pełnego zrozumienia odpowiedzi przeciwciał przeciwko atakującym patogenom.
Ze względu na ich astronomiczną różnorodność, repertuar komórek B był uważany za czarną skrzynkę; jednak pojawienie się technologii NGS umożliwiło przełomowe odkrycia w lepszym zrozumieniu ich złożoności3,4. Z powodzeniem przeanalizowano cały repertuar przeciwciał, najpierw u danio pręgowanego5, następnie myszy6 i ludzi6,7. Chociaż NGS stał się obecnie potężnym narzędziem w badaniach nad adaptacyjną odpowiedzią immunologiczną, brakuje podstawowych analiz podobieństw i różnic w repertuarze przeciwciał u poszczególnych zwierząt.
U myszy stwierdzono, że repertuar IgM jest prawie identyczny u poszczególnych osób, podczas gdy repertuary IgG1 i IgG2c znacznie różnią się między osobami8. Oprócz profilu użycia genu V, obserwowana częstość występowania profilu VDJ w naiwnych obwodowych komórkach B jest bardzo podobna u różnych osób8. Analiza sekwencji aminokwasów regionu VDJ wykazała również występowanie tych samych sekwencji połączeniowych u różnych myszy znacznie częściej niż wcześniej sądzono8. Wyniki te wskazują, że mechanizmy powstawania repertuaru przeciwciał mogą być deterministyczne, a nie stochastyczne5,8,9. Proces rozwoju repertuaru przeciwciał u myszy został również z powodzeniem przeanalizowany przy użyciu NGS, aby jeszcze bardziej podkreślić potencjał NGS do szczegółowego odkrycia układu odpornościowego przeciwciał10.
W tym raporcie opisujemy prostą i skuteczną metodę wizualizacji i analizy repertuaru przeciwciał na poziomie globalnym.
Protokół
Wszystkie eksperymenty na zwierzętach zostały przeprowadzone zgodnie z wytycznymi instytucji i za zgodą Komitetu ds. Opieki i Użytkowania Zwierząt Narodowego Instytutu Chorób Zakaźnych. Pobieranie próbek PBMC od zdrowych dorosłych ochotników, wykorzystanych jako reprezentatywny wynik w niniejszym raporcie, zostało przeprowadzone za zgodą Komisji Etycznej Narodowego Instytutu Chorób Zakaźnych w Tokio w Japonii, a od każdego uczestnika uzyskano pisemną świadomą zgodę przy użyciu formularza zatwierdzonego przez komisję etyczną.
1. Projekt podkładu
- Zaprojektuj uniwersalny starter do przodu do cDNA w celu amplifikacji mRNA immunoglobuliny bez odchylenia od starterów PCR, stosowanych w technikach 5'-RACE11,12 i SMART-PCR13.
- W przypadku amplifikacji genu immunoglobuliny VH zaprojektuj sekwencje specyficzne dla klasy immunoglobulin w obszarze stałym jako startery odwrotne8,14 (Rysunek 1A).
UWAGA: Sekwencje znaczników multipleksowych można dodać do dowolnego z tych starterów, aby oznaczyć cząsteczki biblioteki z różnych źródeł próbek. Można również dodać sekwencje dla zagnieżdżonego PCR, zgodnie z instrukcją używanego zestawu15.
| Uniwersalny podkład do przodu | 5'- AAGCAGTGGTATCAACGCAGAGT-3' |
| Odwrócone startery dla mysich immunoglobulin (Ref.8) | |
| IgM_CH1: | 5'- CACCAGATTCTTATCAGAGAGGGGGCTCTC -3' |
| IgG1_CH1: | 5'- CATCCCAGGGTCACCATGGAGTTAGTTTGG -3' |
| IgG2c_CH1: | 5'- GTACCTCCACACACAGGGGAGTGGATAG -3' |
| IgG3_CH1: | 5'-ATGTGTCACTGCAGCCAGGGAAGGAGGA-3' |
| IgA_CH1: | 5'-GAATCAGGCAGCCGATTATCACGGGATCAC-3' |
| Igκ_CH1: | 5'- GCTCACTGGATGGTGGGAAGATGGATACAG -3' |
| Igλ_CH1: | 5'- CTBGAGCTCYTCAGRGGAAGGTGGAAACA -3' |
| Odwrócone startery dla ludzkich immunoglobulin (Ref.14) | |
| IgM_CH1: | 5'- GGGAATTCTCACAGGAGACG -3' |
| IgG_CH1: | 5'- AAGACCGATGGGCCCTTG -3' |
| IgD_CH1: | 5'- GGGTGTCTGCACCCTGATA -3' |
| IgA_CH1: | 5'- GAAGACCTTGGGGCTGGT -3' |
| IgE1_CH1: | 5'- GAAGACGGATGGGCTCTGT -3' |
| IgE2_CH1: | 5'- TTGCAGCAGCGGGTCAAGGG -3' |
| Igκ_CH1: | 5'- TGCTCATCAGATGGCGGGAAGAT -3' |
| Igλ_CH1: | 5'- AGAGGAGGGCGGGAACAGAGTGA -3' |
Tabela 1: Sekwencje starterów do amplifikacji immunoglobulin metodą PCR
2. Izolacja kwasów nukleinowych z komórek i tkanek odpornościowych
UWAGA: Poniższa procedura służy do ekstrakcji kwasów nukleinowych ze śledziony myszy. Ma jednak zastosowanie do innych tkanek odpornościowych i komórek ludzkich, takich jak węzły chłonne lub komórki jednojądrzaste krwi obwodowej (PBMC) (Rysunek 1B).
- Wypreparować tkankę, np. śledzionę od 8-tygodniowej myszy C57BL/6 i przepuścić ją przez siatkę ze stali nierdzewnej (200 do 400 μm) z 2 ml buforu PBS w celu uzyskania rozproszonych komórek. Przenieść zawiesinę komórek do probówki mikrowirówkowej o pojemności 2,0 ml i wirować przez 5 minut w temperaturze 600 × g i temperaturze 4 °C. Odrzucić supernatant.
- Dodać 800 μl buforu lizującego ACK (150 mM NH4Cl, 1 mM KHCO3, 0,1 mM Na2EDTA, pH 7,2) do osadu i inkubować na lodzie przez 2 minuty w celu lizy czerwonych krwinek w tkance.
- Przemyć komórki tkanek 2 ml PBS 3x, a następnie odwirować przez 5 minut w temperaturze 600 × g i temperaturze 4 °C.
- Dodać 800 μl odczynnika izotiocyjanianu fenolu/guanidyny do osadu, dokładnie wymieszać i inkubować w temperaturze około 25 °C przez 5 minut.
- Dodać chloroform (200 μl), wstrząsać ręcznie przez 15 s, a następnie inkubować przez 2 minuty w temperaturze około 25 °C.
- Rozdzielić fazy przez odwirowanie przez 15 minut w temperaturze 12 000 × g i temperaturze 25 °C i przenieść górną fazę wodną do świeżej probówki.
- Dodać jedną objętość 70% etanolu, krótko odwirować i nałożyć na kolumnę wirową z krzemionki.
- Wypłucz RNA za pomocą 30–100 μl wody.
- Określić ilościowo początkowe stężenie RNA za pomocą fluorometru (tabela materiałów).
- Oczyszczony RNA należy przechowywać w temperaturze -80 °C.
3. Synteza cDNA i amplifikacja PCR
UWAGA: Opisana poniżej metoda opiera się na 5'-RACE11,12 i technikach SMART-PCR13. Szczegóły i optymalizacja reakcji są opisane w instrukcji zestawu 15. Materiałem wyjściowym dla immunoglobuliny myszy jest próbka z kroku 2.10. Materiałem wyjściowym dla immunoglobuliny ludzkiej jest próbka z tkanek ludzkich, np. PBMC, traktowana zgodnie z opisem w krokach 2.3–2.10.
- Zsyntetyzuj pierwszą nić cDNA od 2 do 10 μg całkowitej matrycy RNA przy użyciu startera 5'-RACE CDS (zawierającego oligo-dT) i oligonukleotydu SMART-PCR (tabela materiałów) zgodnie z instrukcjami producenta15.
- W przypadku immunoglobuliny mysiej amplifikacja cDNA metodą PCR za pomocą polimerazy DNA o wysokiej wierności przy użyciu uniwersalnego startera do przodu i starterów odwrotnych specyficznych dla klasy immunoglobulin (Tabela 1). Ustaw warunki cykli termicznych jako: 94 °C przez 2 minuty, następnie 40 cykli po 94 °C przez 30 s, 59 °C przez 30 s i 72 °C przez 30 s, a następnie ostatni krok przedłużania w 72 °C przez 5 minut
UWAGA: Typowe eksperymenty wzmacniają klasy immunoglobulin IgM, IgG1, IgG2c, Igk i Igl, aby przyjrzeć się naiwnym, zależnym od Th1 i Th2-zależnym limfocytom B (Figura 3). - W przypadku immunoglobuliny ludzkiej należy przeprowadzić 1. PCR przy użyciu uniwersalnego startera do przodu i specyficznych dla klasy immunoglobulin starterów odwrotnych (Tabela 1) z sekwencjami znaczników. Dołączyć sekwencje indeksowe dla każdej próbki za pomocą 2ndPCR przy użyciu starterów sekwencji indeksowej. Stosować następujące warunki PCR i polimerazę Taq: 94 °C przez 2 min, 21 cykli (1st PCR) lub 32 cykle (2nd PCR) w temperaturze 94 °C przez 30 s, 59 °C przez 30 s, 72 °C przez 30 s.
UWAGA: Typowe eksperymenty wzmacniają klasy immunoglobulin IgM, IgD, IgG (IgG1, IgG2, IgG3 i IgG4), IgA (IgA1 i IgA2), IgE, Igk i Igl, aby przyjrzeć się wszystkim populacjom komórek B (Figura 4).
- W przypadku immunoglobuliny mysiej amplifikacja cDNA metodą PCR za pomocą polimerazy DNA o wysokiej wierności przy użyciu uniwersalnego startera do przodu i starterów odwrotnych specyficznych dla klasy immunoglobulin (Tabela 1). Ustaw warunki cykli termicznych jako: 94 °C przez 2 minuty, następnie 40 cykli po 94 °C przez 30 s, 59 °C przez 30 s i 72 °C przez 30 s, a następnie ostatni krok przedłużania w 72 °C przez 5 minut
- Poddać produkty PCR elektroforezie w żelu agarozowym i oczyścić fragmenty o objętości od 600 do 800 pz za pomocą kolumny wirowej z membraną krzemionkową.
- Elektroforezę próbki z ppkt 3.2.1 lub 3.2.2 na 2% żelu agarozowym.
- Zobrazuj prążki DNA na transiluminatorze UV i wytnij plasterek żelu zawierający szerokie pasmo od 600 do 800 pz.
- Dodać 10 μl roztworu wiążącego błonę na 10 mg plastra żelu. Wymieszać i inkubować w temperaturze 50–65 °C, aż do całkowitego rozpuszczenia żelu.
- Przenieść roztwór żelu na kolumnę wirową z membraną krzemionkową. Przemyć raz buforem płuczącym i wymyć DNA 50 μl wody wolnej od nukleaz (tabela materiałów).
- Oznacz ilościowo oczyszczone amplikony za pomocą fluorometru i puluj amplikony z każdej klasy immunoglobulin w równych ilościach do sekwencjonowania NGS.
UWAGA: Zazwyczaj odzyskiwano DNA amplikonu o wielkości 2-10 μg dla każdej klasy immunoglobulin. Wymieszać każdy roztwór próbki równomiernie w ilości DNA, aby uzyskać 50 μl roztworu zawierającego 10-20 ng DNA/μl. - Określ rozmiar i koncentrację bibliotek za pomocą elektroforezy opartej na mikrokapilarnach z chipem do wymiarowania DNA (tabela materiałów). Przechowywać biblioteki w temperaturze -20 °C.
4. Sekwencjonowanie bibliotek NGS
- Wygeneruj plik SampleSheet.cvs dla przebiegu sekwencjonowania, określając nazwę próbki, informacje o indeksie i instrukcję, aby uzyskać tylko pliki .fastq.
- Rozmrozić kasetę z odczynnikiem (Tabela materiałów) i biblioteki.
- Zrobić 0,2 N NaOH i rozcieńczyć biblioteki, aby uzyskać pożądane stężenie molowe.
- Wypłucz i osusz komorę przepływową. Dodać 600 μl rozcieńczonego i zdenaturowanego roztworu bibliotecznego do studzienki wkładu z odczynnikiem.
- Rozpocznij sekwencjonowanie.
5. Kontrola jakości danych NGS
- Przeprowadź kontrolę jakości danych FASTQ za pomocą "FASTX-Toolkit"16.
UWAGA: Podstawowy przykład używanych ustawień parametrów jest następujący:
fastq_quality_trimmer -v -t 20 -l 200 -i [nazwa_pliku.fastq] -o [nazwa_pliku.fastq]
fastq_quality_filter -v -q 20 -p 80 -i [nazwa_pliku.fastq] -o [nazwa_pliku.fastq]
fastx_reverse_complement -v -i [nazwa_pliku.fastq] -o [nazwa_pliku.fastq] - Sformatuj pliki wyjściowe do "fasta nucleic acid (.fna)" za pomocą następującego polecenia:
fastq_to_fasta -v -n -i [nazwa_pliku.fastq] -o [nazwa_pliku.fna]
6. Ekstrakcja i analiza sekwencji immunoglobulin z danych .fna
UWAGA: Przykładowe programy zostały zaimplementowane w środowisku UNIX. Użyj ich jako przykładowych odniesień, ponieważ wydajność może zależeć od systemu operacyjnego i środowiska sprzętowego. Autorzy nie ponoszą odpowiedzialności za błędy lub pominięcia. Języki programowania, Perl17, R18 oraz wymagane moduły muszą być zainstalowane zgodnie z instrukcjami na cytowanych stronach internetowych. program IgBLAST należy zainstalować zgodnie z instrukcją na odpowiedniej stronie internetowej19,20.
- Pobierz poniższe przykłady wewnętrznych programów do analiz repertuarowych ze strony https://github.com/KzPipeLine/KzPipeLine:
03_PipeLine_Mouse.zip; Zestaw przykładowych programów do analiz sekwencji przeciwciał myszy.
05_PipeLine_Human.zip; Zestaw przykładowych programów do analiz sekwencji ludzkich przeciwciał. - Wyodrębnij odczyty przeciwciał w danych sekwencji: Wyodrębnij sekwencje immunoglobuliny (Ig) każdej klasy Ig z danych (.fna ) za pomocą programu Perl, który przeszukuje sekwencje sygnatur w każdym stałym regionie immunoglobuliny (Tabela 2).
- W przypadku genów łańcucha ciężkiego (IgH) immunoglobuliny myszy wyodrębnij odczyty za pomocą następującego polecenia:
$ perl 01_KzMFTIgCmgggaNtdVer3_Kz160607.pl [Nazwa pliku wejściowego] [Nazwa pliku wyjściowego (sufiks)] - W przypadku genów łańcucha lekkiego immunoglobuliny myszy (IgL) wyodrębnia się odczyty za pomocą następującego polecenia:
$ perl 01_KzMFTCkltNtdVer1_170810.pl [Nazwa pliku wejściowego] [Nazwa pliku wyjściowego (sufiks)] - W przypadku genów łańcucha ciężkiego ludzkiej immunoglobuliny (IgH) wyodrębnij odczyty za pomocą następującego polecenia:
$ perl 01_KzMfHuIgHCmgadeNtdVer1_Kz180312.pl [Nazwa pliku wejściowego] [Nazwa pliku wyjściowego (sufiks)] - W przypadku genów łańcucha lekkiego ludzkiej immunoglobuliny (IgL) wyodrębnij odczyty za pomocą następującego polecenia:
$ perl 01_KzMfHuIgCkltNtd_180316.pl [Nazwa pliku wejściowego] [Nazwa pliku wyjściowego (sufiks)]
- W przypadku genów łańcucha ciężkiego (IgH) immunoglobuliny myszy wyodrębnij odczyty za pomocą następującego polecenia:
- Opisz i sprawdź produktywność rekombinacji genu V(D)J:
UWAGA: Metoda opisana poniżej wykorzystuje autonomiczną klasę IgBLAST19 do adnotacji segmentów genu V(D)J w sekwencji. Ustaw bazę danych dla genów V(D)J i ustawienia parametrów dla IgBLAST zgodnie z opisem20.- Opisz geny łańcucha ciężkiego (IgH) immunoglobuliny myszy za pomocą następującego polecenia:
$ igblastn -germline_db_V $IGDATA/ImtgMouseIghV_NtdDb.txt -germline_db_J $IGDATA/ImtgMouseIghJ_NtdDb.txt -germline_db_D $IGDATA/ImtgMouseIghD_NtdDb.txt -organism mouse -domain_system imgt -query ./$InFile -auxiliary_data $IGDATA/optional_file/mouse_gl.aux -show_translation -outfmt 7 >> ./$OutName - Opisz geny łańcucha lekkiego immunoglobuliny myszy (IgL) za pomocą następującego polecenia:
$ igblastn -germline_db_V $IGDATA/ImtgMouseIgkV_NtdDb.txt -germline_db_J $IGDATA/ImtgMouseIgkJ_NtdDb.txt -germline_db_D $IGDATA/ImtgMouseIghD_NtdDb.txt -organism mouse -domain_system imgt -query ./$InFile -auxiliary_data $IGDATA/optional_file/mouse_gl.aux -show_translation -outfmt 7 >> ./$OutName - Opisz geny ludzkiego łańcucha ciężkiego immunoglobuliny (IgH) za pomocą następującego polecenia:
$ igblastn -germline_db_V $IGDATA/ImtgHumanIghV_NtdDb.txt -germline_db_J $IGDATA/ImtgHumanIghJ_NtdDb.txt -germline_db_D $IGDATA/ImtgHumanIghD_NtdDb.txt -organism human -domain_system imgt -query ./$InFile -auxiliary_data $IGDATA/optional_file/Human_gl.aux -show_translation -outfmt 7 >> ./$OutName - Opisz geny ludzkiego łańcucha lekkiego immunoglobuliny (IgL) za pomocą następującego polecenia:
$ igblastn -germline_db_V $IGDATA/ImtgHumanIgkV_NtdDb.txt -germline_db_J $IGDATA/ImtgHumanIgkJ_NtdDb.txt -germline_db_D $IGDATA/ImtgHumanIghD_NtdDb.txt -organism human -domain_system imgt -query ./$InFile -auxiliary_data $IGDATA/optional_file/human_gl.aux -show_translation -outfmt 7 >> ./$OutName
- Opisz geny łańcucha ciężkiego (IgH) immunoglobuliny myszy za pomocą następującego polecenia:
- Wizualizacja globalnej cechy repertuaru przeciwciał.
- Wizualizuj repertuar IgH myszy za pomocą następującego polecenia:
$ . 00a1_3DView_MoIgH_Kz180406.sh
UWAGA: Plik wejściowy to nazwa_pliku.fna (dane sekwencji), najlepiej plik wyjściowy z wersji 6.2.1. Plik ten należy umieścić w niższym katalogu (folderze) o nazwie "nazwa_pliku". W wierszu 50 skryptu powłoki przypisz "nazwę pliku" dla Para_4. - Wizualizuj ludzki repertuar IgH za pomocą następującego polecenia:
$ . 00a1_3DView_HuIgH_Kz180411.sh
UWAGA: Plik wejściowy to dane sekwencji filename.fna, najlepiej plik wyjściowy 6.2.3. Ten plik należy umieścić w dolnym katalogu (folderze) o nazwie "nazwa_pliku". W wierszu 46 skryptu powłoki przypisz "nazwę pliku" dla Para_4. - Wizualizuj repertuar IgL myszy za pomocą następującego polecenia:
$ . 00_2DViewS_MoIgL_Kz180406.sh
UWAGA: W tym rurociągu Igk i Igl są przetwarzane jednocześnie. Plik wejściowy to nazwa_pliku.fna (dane sekwencji), najlepiej plik wyjściowy z 6.2.2. Plik ten należy umieścić w dolnym katalogu (folderze) o nazwie "nazwa_pliku". W wierszu 53 skryptu powłoki przypisz "nazwę pliku" dla Para_4. Nazwa pliku wyjściowego, kończąca się na "_IgKlCount.txtDim2Rpm.txt", podaje współrzędne dwuwymiarowego wykresu słupkowego (Rysunek 3, IgL). - Wizualizuj ludzki repertuar IgL za pomocą następującego polecenia:
$ . 00_2DView_HuIgL_Kz180319.sh
UWAGA: W tym rurociągu Igk i Igl są przetwarzane jednocześnie. Plikiem wejściowym są dane sekwencji nazwa_pliku.fna, najlepiej plik wyjściowy 6.2.4. Plik ten należy umieścić w niższym katalogu (folderze) o nazwie "nazwa_pliku". W wierszu 53 skryptu powłoki przypisz "filename" dla Para_4. Nazwa pliku wyjściowego kończąca się na "_IgKlCount.txtDim2Rpm.txt" podaje współrzędne dwuwymiarowego wykresu słupkowego (Rysunek 4, IgL).
- Wizualizuj repertuar IgH myszy za pomocą następującego polecenia:
Wyniki
Repertuaria przeciwciał myszy
Perspektywę całego repertuaru przeciwciał mysich można uzyskać z komórek lub tkanek, takich jak śledziona, szpik kostny, węzeł chłonny lub krew. Rycina 3 przedstawia reprezentatywne wyniki dla repertuarów IgM, IgG1, IgG2c oraz lekkich łańcuchów immunoglobulin (IgL) z milzy naiwnej myszy. Podsumowanie liczby odczytów przedstawiono w Tabela 3Na przykład 16 175/475 14 odczytów zawierało sekwencję sygnaturową specyficzną dla IgM (Tabela 2) oraz 133 371/166 175 odczytów uznano za produktywne VDJ na podstawie analizy IgBLAST19.
Rysunek 3 przedstawia profil repertuaru przebudowy VDJ za pomocą wykresu 3D-VDJ-plot, w którym wielkość każdej kuli reprezentuje względną liczbę odczytów; innymi słowy, liczbę cząsteczek mRNA przeciwciał w całych limfocytach B. Trójwymiarowa siatka składa się ze 10 fragmentów IGHV, 12 IGHD i 4 IGHJ, które są wyrównane tak, aby odzwierciedlać ich kolejność na chromosomie. Dodatkowo geny jednoznacznie przypisane przez program IgBLAST zostały zgromadzone osobno na ostatniej pozycji dla każdej linii IGHV, IGHD i IGHJ, co dało łącznie 7 215 węzłów w prostopadłościanie.
Ponadto na Rysunku 3 przedstawiono wykres 2D-VJ obrazujący profil reorganizacji VJ w repertuarze IgL. Długość każdego słupka na tym wykresie reprezentuje względną liczbę odczytów. Oś X reprezentuje 101 genów IGLVκ oraz 3 geny IGLVλ, a oś Y reprezentuje 4 geny IGLJκ oraz 3 geny IGLJλ. Nieadnotowane geny V i J zostały przedstawione na prawej krawędzi.
Sekwencje regionu 3 determinującego komplementarność (CDR3) tych produktywnych odczytów, które odpowiadają za większość swoistości wiązania antygenu, są zawarte w wynikach programu IgBLAST. Sekwencje CDR3 mogą być analizowane statystycznie, z uwzględnieniem powtórzeń biologicznych lub technicznych, zgodnie z wcześniejszym opisem8,10.
Ludzkie repertoria przeciwciał
Perspektywę całego ludzkiego repertuaru przeciwciał można analizować w różnych tkankach, w tym w mononuklearnych komórkach krwi obwodowej (PBMC) lub tkankach patologicznych. Rysunek 4 przedstawia reprezentatywne wyniki repertuarów IgM, całkowitego IgG (IgG1, IgG2, IgG3 i IgG4), całkowitego IgA (IgA1 i IgA2), IgD, IgE i IgL z prawidłowych PBMC. Podsumowanie liczby odczytów przedstawiono w Tabeli 3. Na przykład 90 238/1 582 754 odczytów zawierało sekwencję sygnaturową specyficzną dla IgM, a 67 896/90 238 odczytów było VDJ-produktywnych.
Profil repertuaru rearanżacji VDJ przedstawiono na wykresie 3D-VDJ, w którym rozmiar każdej kuli reprezentuje względną liczbę odczytów; innymi słowy, liczbę mRNA przeciwciał z całkowitej populacji PBMC (Rycina 4). Siatka 3D składa się z 56 genów IGHV, 27 IGHD i 6 IGHJ, ustawionych w kolejności, w jakiej występują na chromosomie. Dodatkowo geny jednoznacznie nieprzypisane przez program IgBLAST są reprezentowane osobno w ostatniej pozycji dla każdej linii IGHV, IGHD i IGHJ, co daje łącznie 1 172 węzły w prostopadłościanie.
Profil rearanżacji VJ w repertuarze IgL przedstawiono na dwuwymiarowym wykresie VJ, w którym długość każdego słupka reprezentuje względną liczbę odczytów (Rysunek 4). Oś X reprezentuje 41 genów IGLVκ i 32 geny IGLVλ, a oś Y reprezentuje 5 genów IGLJκ i 5 genów IGLJλ. Nieopisane geny V i J znajdują się na prawej krawędzi wykresu.
Sekwencje ludzkiego regionu CDR3 są przedstawione w wynikach programu IgBLAST i mogą być analizowane statystycznie zgodnie z wcześniejszym opisem8,10.
| Klasa immunoglobulin | Zmysł | Antysensowny |
| Łańcuchy ciężkie immunoglobulin mysich (C57BL/6) | ||
| IgM | AGTCAGTCCTTCCCAAATGTC | GACATTTGGGAAGGACTGACT |
| IgG1 | AAAACGACCCCCATCTGTC | GACAGATGGGTGTCGTT |
| (wariant IgG1) | AAAACAACCCCCATCAGTC | GACTGATGGGGGTGTTGTT |
| IgG2c | AAAACAACAGCCCCATCGGTC | GACCGATGGCTGTTGTT |
| IgG3 | GTGATCCCGTGATAATCGGCT | AGCCGATTATCACGGGATCAC |
| IgA | TCCCTTGGTCCCTGGCTGCAG | TCCCTTGGTCCCTGGCTGCAG |
| Łańcuchy lekkie immunoglobulin mysich (C57BL/6) | ||
| Igκ | CTGTATCCATCTTCCCACCATCCAGTGAGC | GCTCACTGGATGGTGGGAAGATGGATACAG |
| Igλ1 | TGTTTCCACCTTCCTCTGAAGCTCGAG | CTCGAGCTTCAGGAAGGTGGAAACA |
| Igλ2 | TGTTTCCACCTTCCTCTGAGGAGCTCAAG | CTTGAGCTCCTCAGGAAGGTGGAAACA |
| Igλ3 | TGTTTCCACCTTCCCCTGAGGAGCTCCAG | CTGGAGCTCCTCAGGGGAAGGTGGAAACA |
| Igλ4 | TGTTCCCACCTTCCTGAAGCTCAAG | CTTGAGCTCTTCAGAGGAAGGTGGGAACA |
| Ludzkie łańcuchy ciężkie immunoglobulin | ||
| IgM | GGGAGTGCATCCGCCCCAAC | GTTGGGGCGGATGCACTCCC |
| IgG | GCTTCCACCAAGGGCCCATC | GATGGGCCCTTGGTGGAAGC |
| IgA | GCATCCCCGACCAGCCCCAA | GACCGATGGCTGTTGTT |
| IgD | GCACCCACCAAGGCTCCGGA | TCCGGAGCCTTGGTGGGTGC |
| IgE | GCCTCCACAGCCCATC | GATGGGCTCTGTGTGGAGGC |
| Ludzkie lekkie łańcuchy immunoglobulin | ||
| Igκ | ACTGTGGCTGCACCATCTGC | GCAGATGGTGCAGCCACAGT |
| Igλ1,2,6 | GTCACTCTGTTCCCGCCCTC | GAGGGCGGGAACAGTGAC |
| Igλ3,7 | GTCACTCTGTTCCCACCCTC | GAGGGTGGGAACAGTGAC |
Tabela 2: Podsumowanie sekwencji sygnaturowych immunoglobulin
| Mysi IgH | Całkowita liczba odczytów | IgM | IgG1 | IgG2c | ||
| Input | 475,14 | |||||
| Zawierające IgC | 16,175 | 29,671 | 36,628 | |||
| Produktywne VDJ | 13,371 | 196,583 | 31,46 | |||
| Mysi IgL | Całkowita liczba odczytów | IgKappa | IgLambda | |||
| Input | 527,68 | |||||
| Zawierające IgC | 178,948 | 21,46 | ||||
| Produktywne VJ | 160,924 | 16,98 | ||||
| Ludzki IgH | Całkowita liczba odczytów | IgM | IgG | IgA | IgD | IgE |
| Input | 1,582,754 | |||||
| Zawierające IgC | 90,238 | 5,298 | 94,061 | 75,549 | 2,932 | |
| Produktywne VDJ | 67,896 | 2,75 | 78,203 | 56,495 | 3 | |
| Ludzki IgL | Całkowita liczba odczytów | IgKappa | IgLambda | |||
| Input | 1,582,754 | |||||
| Zawierające IgC | 120,316 | 64,148 | ||||
| Produktywne VJ | 97,169 | 52,324 |
Tabela 3: Podsumowanie liczby odczytów w eksperymentach

Rysunek 1: Schematyczne przedstawienie strategii sekwencjonowania do analizy repertuarów przeciwciał u poszczególnych myszy. (A) Całkowite RNA z komórek odpornościowych lub tkanek poddano odwrotnej transkrypcji, a następnie amplifikacji metodą PCR z wykorzystaniem uniwersalnego prawego primeru oraz klasowo specyficznych lewych primerów dla immunoglobulin. Amplikony z każdej klasy immunoglobulin połączono i przekazano do sekwencjonowania nowej generacji.(B) Replikaty biologiczne, takie jak śledziony myszy C57BL/6, poddano następującej procedurze: z próbek śledziony oczyszczono całkowite RNA, a następnie cDNA namnożono metodą 5'-RACE, stosując primer uniwersalny oraz primer specyficzny dla klasy przeciwciał. Następnie materiał przygotowano do sekwencjonowania następnej generacji (NGS), wykorzystując primery znakujące dla poszczególnych osobników. Fragmenty rysunku zostały zaadaptowane z8 za zgodą. Prosimy kliknąć tutaj, aby wyświetlić powiększoną wersję tej ryciny.
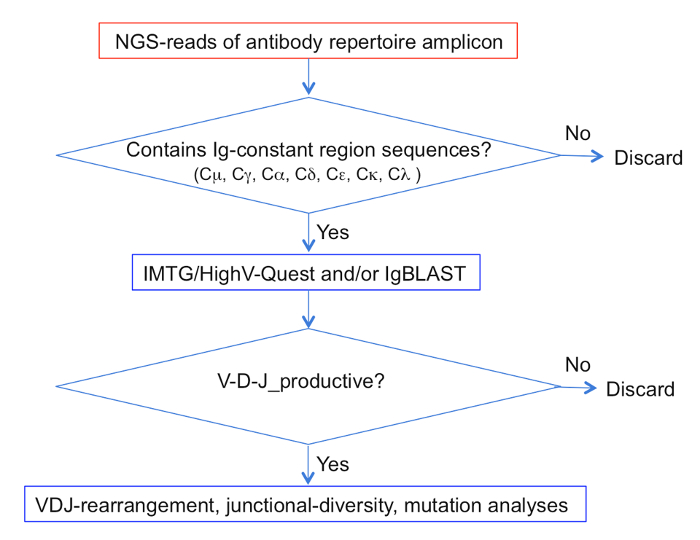
Rysunek 2: Schemat przepływu przetwarzania danych służący do analizy repertuarów przeciwciał u poszczególnych myszy. Odczyty amplikonów uzyskane po sekwencjonowaniu nowej generacji przetworzono w następujący sposób: (1) sprawdzono sekwencje odczytów pod kątem obecności sekwencji sygnaturowych specyficznych dla klasy przeciwciał; (2) zbadano sekwencje pod kątem fragmentów genów V, D i J przy użyciu IMGT/HighV-Quest i/lub IgBLAST; (3) zebrano sekwencje zawierające produktywne połączenie VDJ; oraz (4) sekwencje te wykorzystano do analizy ogólnych cech repertuaru, regionu CDR3 itd. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.

Rycina 3: Globalna wizualizacja danych dla repertuarów przeciwciał mysich. Ogólne profile repertuaru każdej klasy przeciwciał przedstawiono za pomocą wykresu 3D-VDJ. Oś x reprezentuje 10 genów IGHV uporządkowanych zgodnie z ich rozmieszczeniem na chromosomie. Oś y i z reprezentują odpowiednio 12 genów IGHD oraz 4 geny IGHJ. Objętość sfer w każdym węźle odpowiada liczbie odczytów. Czerwone sfery: nieadnotowane geny V, D i J. Rozkłady odczytów IgL przedstawiono na wykresie 2D-VJ, w którym długość każdego słupka reprezentuje względną liczbę odczytów. Oś x reprezentuje 101 genów IGLVκ i 3 geny IGLVλ, a oś y reprezentuje 4 geny IGLJκ i 3 geny IGLJλ. Nieadnotowane geny V i J przedstawiono na prawej krawędzi wykresu. Proszę kliknąć tutaj, aby wyświetlić powiększoną wersję tej ryciny.
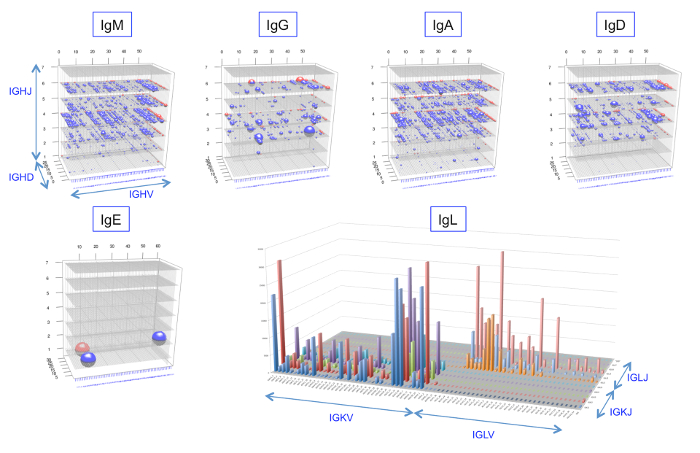
Rysunek 4: Globalna wizualizacja danych dla repertuarów przeciwciał u ludzi. Ogólne profile repertuarów każdej klasy przeciwciał zwizualizowano za pomocą wykresu 3D-VDJ-plot. Oś x przedstawia 56 genów IGHV ułożonych zgodnie z ich rozmieszczeniem na chromosomie. Osie y i z przedstawiają odpowiednio 27 genów IGHD oraz 6 genów IGHJ. Objętość sfer w każdym węźle odpowiada liczbie odczytów. Czerwone sfery oznaczają nieadnotowane geny V, D i J. Odczyty IgL rozmieszczono na wykresie 2D-VJ-plot, w którym długość każdego słupka reprezentuje względną liczbę odczytów. Oś x przedstawia 41 genów IGLVκ i 32 geny IGLVλ, a oś y przedstawia 5 genów IGLJκ i 5 genów IGLJλ. Nieadnotowane geny V i J zaznaczono na prawej krawędzi wykresu. Prosimy kliknąć tutaj, aby wyświetlić powiększoną wersję tego rysunku.
Dyskusja
Opisana tutaj metoda wykorzystuje NGS do RNA przeciwciał amplifikowanych metodą 5'-RACE. W przeciwieństwie do metod wykorzystujących zdegenerowane startery genu 5'-VH, mRNA każdej klasy przeciwciał są równomiernie amplifikowane przy użyciu uniwersalnych starterów do przodu. Ponadto zastosowanie starterów antysensownych specyficznych dla regionu stałego 1 (CH1) genu przeciwciała umożliwia profilowanie repertuarowe specyficznych klas immunoglobulin. Jest to bardzo korzystne dla analizy odpowiedzi przeciwciał specyficznej dla danej klasy, a także dla porównania repertuaru naiwnych i uodpornionych 8,9.
Najbardziej prawdopodobną pułapką tej metody jest niedostatek amplifikowanych wiadomości immunoglobulinowych. Głębokość repertuaru przeciwciał uzyskana za pomocą tego protokołu zasadniczo zależy od amplifikacji PCR opisanej w krokach 3.1 i 3.2. Jeśli głębokość repertuaru nie zostanie uzyskana prawidłowo, zdecydowanie zaleca się zmianę proporcji matrycowego cDNA i starterów w krokach 3.2.1 lub 3.2.2.
Ogólnie rzecz biorąc, około 20% odczytów przeciwciał wytwarzanych przez NGS to sekwencje niejednoznaczne21. Nawet przy ustalonych "metodach korekcyjnych" 5-10% pozostaje niejednoznacznych3. W związku z tym przeanalizowaliśmy sekwencję i przefiltrowaliśmy surowe odczyty zawierające sekwencje sygnatur odpowiadające stałym regionom immunoglobulin (CμH1, Cγ1H1, Cγ2cH1 itp.). W związku z tym analiza hipermutacji somatycznych wymaga dokładnych badań.
Jednym z ograniczeń tej metody jest to, że nie można wywnioskować pary łańcuchów ciężkich i lekkich immunoglobulin. Stąd spojrzenie repertuarowe uzyskane tą metodą nie jest holistyczne. Możliwe jest jednak przybliżenie par o najwyższej pozycji w rankingu poprzez analizę statystyczną danych10. Niedawno doniesiono również o nowej metodzie sekwencjonowania par immunoglobulin 3,4.
Sekwencje immunoglobulin w danych wyjściowych .fna zostały wyekstrahowane na podstawie obecności sekwencji sygnatur genów immunoglobulin. Segmenty genów V, D i J zostały następnie oznaczone i oceniono produktywność rearanżacji V(D)J. Opisano również sekwencje regionu 3 determinującego komplementarność (CDR3). Te systematyczne badania sekwencji immunoglobulin w danych .fna zostały z pożytkiem dostarczone przez serwer IMGT/HighV-QUEST 22,23,24. Jednak zbudowanie zautomatyzowanego potoku przetwarzania ma tę zaletę, że można analizować duże dane eksperymentalne. Rurociąg dostosowany do każdego celu jest możliwy do skonfigurowania przy użyciu autonomicznego protokołu IgBLAST19. Takie podejście wymaga podstawowych umiejętności programowania, ale jest bardzo przydatne do szczegółowych analiz układu immunoglobulin. Opisane potoki są przykładami dostosowanego protokołu (rysunek 2).
Liczba odczytanych przeciwciał jest proporcjonalna do ilości RNA przeciwciał w próbce, odzwierciedlając składniki przeciwciał układu przeciwciał w danych punktach czasowych 5,8,25. Opisana tutaj metoda daje widok z lotu ptaka na konstytucję V(D)J repertuaru przeciwciał przy użyciu programów R 8,18,26.
Globalny wgląd w repertuar przeciwciał IgM u poszczególnych nieleczonych myszy ujawnił wysoce konserwatywny profil VDJ w porównaniu z profilami IgG1 lub IgG2c8. Doniesiono, że kombinacje VDJ niedojrzałych danio pręgowanego są wysoce stereotypowe9. W przeciwieństwie do tego, ludzkie kombinacje VDJ są zgłaszane jako wysoce skośne6. Wysoce konserwatywne deterministyczne profile VDJ w naiwnych komórkach B są prawdopodobnie generowane albo przez skośne rearanżacje VDJ, albo negatywną selekcję z autoantygenami obecnymi w organizmie. Na przykład IGHV11-2 ulega ekspresji preferencyjnie w repertuarze płodowych IgM27 , a tę dominację przypisuje się autoreaktywności IGHV11-2 wobec starzejących się erytrocytów27. Co ciekawe, IGHV11-2 był również najczęstszym głównym repertuarem w naszej wcześniej opublikowanej analizie naiwnej IgM8.
Opisana tutaj metoda jest przydatna do rozszyfrowywania repertuarów przeciwciał reagujących na antygen poprzez kompleksową analizę przestrzeni repertuaru przeciwciał generowanej w poszczególnych ciałach, unikając przypadkowego pominięcia kluczowych repertuarów przeciwciał 8,10. Metoda ta pozwala również na szczegółowe badanie dynamiki sieci przeciwciał, co ułatwiłoby przyspieszone odkrywanie przeciwciał ochronnych przeciwko nowo pojawiającym się patogenom.
Oświadczenia
Autorzy nie mają do ujawnienia żadnych konfliktów interesów.
Podziękowania
Ta praca była wspierana przez grant od AMED w ramach grantu o numerze JP18fk0108011 (KO i SI) i JP18fm0208002 (TS, KO, i YO), oraz dotację z Ministerstwa Edukacji, Kultury, Sportu, Nauki i Technologii (15K15159) dla KO. Dziękujemy Sayuri Yamaguchi i Satoko Sasaki za cenną pomoc techniczną. Serdecznie dziękujemy firmie Editage (www.editage.jp) za redakcję w języku angielskim.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Probówki paskowe 0,2 ml | Thermo Fisher Scientific | AB0452 | 120 pasków |
| 100 pz Drabinka DNA | TOYOBO | DNA-035 | 0,5 ml |
| 2100 Systemy bioanalizatorów | Agilent Technologies | G2939BA /2100 | |
| Kwas octowy | Wako | 017-00256 | 500 ml |
| Agaroza, NuSieve GTG | Lonza | 50084 | |
| Amon Chlorek | Wako | 017-02995 | 500 g |
| Chloroform | Wako | 038-02606 | 500 ml |
| Dulbecco's PBS (-)" Nissui" | NISSUI | 08192 | |
| Kwas etylenodiamino-N,N,N',N'-tetraoctowy sól disodowa dwuwodna (2NA) | Wako | 345-01865 | 500 g |
| Falcon 40 µ m Sitko do komórek | Falcon | 352340 | 50/Case |
| rurka zamka 1,7 | mL SPRZĘT BM | BM-15 | |
| rurka blokująca 2,0 mL | SPRZĘT BM | BM-20 | |
| MiSeq Reagent Kit v2 | illumina | MS-102-2003 | 500 cykli |
| MiSeq System | illumina | SY-410-1003 | |
| Spektrofotometr NanoDrop 2000c | Thermo Fisher Scientific | ||
| Wodorowęglan potasu | Wako | 166-03275 | 500 g |
| PureLink RNA Mini | Kit technologie życia | 12183018A | |
| Fluorometr Qubit 3.0 | Thermo Fisher Scientific | Q33216 | |
| Zestaw testowy Qubit dsDNA HS | Testy | ||
| Thermo Fisher Scientific Q32854 500SMARTer WYŚCIG 5'/3' Zestaw | Klonat | ||
| Wersja gorącego startu TaKaRa Ex Taq | Takara Bio Inc. | Karabin Jądrowy RR006A | |
| Baza Trizma | Sigma | T6066 | 1 kg |
| Odczynnik TRIzol | AmbionThermo Fisher Scientific | 15596026 | 100 ml |
| Ultra Clear qPCR Caps | Thermo Fisher Scientific | AB0866 | 120 pasków |
| UltraPure Ethidium Bromek | Thermo Fisher Scientific | 15585011 | |
| Wizard SV Żel i system czyszczenia PCR | Promega | A9282 |
Bibliografia
- Schroeder, H. W. Jr Similarity and divergence in the development and expression of the mouse and human antibody repertoires. Developmental & Comparative Immunology. 30 (1-2), 119-135 (2006).
- Tonegawa, S. Somatic generation of antibody diversity. Nature. 302 (5909), 575-581 (1983).
- Georgiou, G., et al. The promise and challenge of high-throughput sequencing of the antibody repertoire. Nature Biotechnology. 32 (2), 158-168 (2014).
- Lees, W. D., Shepherd, A. J. Studying Antibody Repertoires with Next-Generation Sequencing. Methods in Molecular Biology. 1526, 257-270 (2017).
- Weinstein, J. A., Jiang, N., White, R. A. 3rd, Fisher, D. S., Quake, S. R. High-throughput sequencing of the zebrafish antibody repertoire. Science. 324 (5928), 807-810 (2009).
- Arnaout, R., et al. High-resolution description of antibody heavy-chain repertoires in humans. PLoS One. 6 (8), e22365(2011).
- Boyd, S. D., et al. Individual variation in the germline Ig gene repertoire inferred from variable region gene rearrangements. Journal of Immunology. 184 (12), 6986-6992 (2010).
- Kono, N., et al. Deciphering antigen-responding antibody repertoires by using next-generation sequencing and confirming them through antibody-gene synthesis. Biochemical and Biophysical Research Communications. 487 (2), 300-306 (2017).
- Jiang, N., et al. Determinism and stochasticity during maturation of the zebrafish antibody repertoire. Proceedings of the National Academy of Sciences of the United States of America. 108 (13), 5348-5353 (2011).
- Sun, L., et al. Distorted antibody repertoire developed in the absence of pre-B cell receptor formation. Biochemical and Biophysical Research Communications. 495 (1), 1411-1417 (2018).
- Olivarius, S., Plessy, C., Carninci, P. High-throughput verification of transcriptional starting sites by Deep-RACE. Biotechniques. 46 (2), 130-132 (2009).
- Yeku, O., Frohman, M. A. Rapid amplification of cDNA ends (RACE). Methods in Molecular Biology. 703, 107-122 (2011).
- Zhu, Y. Y., Machleder, E. M., Chenchik, A., Li, R., Siebert, P. D. Reverse transcriptase template switching: a SMART approach for full-length cDNA library construction. Biotechniques. 30 (4), 892-897 (2001).
- Vollmers, C., Sit, R. V., Weinstein, J. A., Dekker, C. L., Quake, S. R. Genetic measurement of memory B-cell recall using antibody repertoire sequencing. Proceedings of the National Academy of Sciences of the United States of America. 110 (33), 13463-13468 (2013).
- SMARTer RACE 5’/3’ Kit User Manual (634858, 634859). , (2018).
- FASTX-Toolkit. , Available from: http://hannonlab.cshl.edu/fastx_toolkit/ (2018).
- Perl. , Available from: https://perldoc.perl.org/ (2018).
- R: A language and environment for statistical computing. , R Foundation for Statistical Computing. Vienna, Austria. (2016).
- Ye, J., Ma, N., Madden, T. L., Ostell, J. M. IgBLAST: an immunoglobulin variable domain sequence analysis tool. Nucleic Acids Research. 41 (Web Server issue), W34-W40 (2013).
- IgBLAST. , Available from: https://www.ncbi.nlm.nih.gov/igblast/faq.html (2018).
- Prabakaran, P., Streaker, E., Chen, W., Dimitrov, D. S. 454 antibody sequencing - error characterization and correction. BMC Research Notes. 4, 404(2011).
- Lefranc, M. P., et al. IMGT, the international ImMunoGeneTics information system. Nucleic Acids Research. 37 (Database issue), D1006-D1012 (2009).
- Alamyar, E., Duroux, P., Lefranc, M. P., Giudicelli, V. IMGT((R)) tools for the nucleotide analysis of immunoglobulin (IG) and T cell receptor (TR) V-(D)-J repertoires, polymorphisms, and IG mutations: IMGT/V-QUEST and IMGT/HighV-QUEST for NGS. Methods in Molecular Biology. 882, 569-604 (2012).
- IMGT/HighV-QUEST. , Available from: http://www.imgt.org/HighV-QUEST/login.action (2018).
- Glanville, J., et al. Precise determination of the diversity of a combinatorial antibody library gives insight into the human immunoglobulin repertoire. Proceedings of the National Academy of Sciences of the United States of America. 106 (48), 20216-20221 (2009).
- rgl: 3D Visualization Using OpenGL. , R package version 0.95.1247 (2015).
- Hardy, R. R., Wei, C. J., Hayakawa, K. Selection during development of VH11+ B cells: a model for natural autoantibody-producing CD5+ B cells. Immunological Reviews. , 60-74 (2004).
Przedruki i uprawnienia
