Ten protokół opisuje opracowanie i ocenę interpretowalnego modelu uczenia maszynowego opartego na zbiorze drzew z wykorzystaniem rutynowo zbieranych danych klinicznych w celu przewidywania ryzyka osteoporozy u pacjentów z cukrzycą.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł badawczy
Multimodalne interpretowalne uczenie maszynowe w przewidywaniu osteoporozy u osób z cukrzycą z wykorzystaniem dużej bazy danych elektronikowych rejestrów opieki krytycznej
W tym artykule
Podsumowanie
Streszczenie
Cukrzyca jest związana ze zwiększoną kruchością szkieletu i podwyższonym ryzykiem złamań; jednakże, wczesne identyfikowanie osteoporozy (OP) w populacjach diabetyków pozostaje wyzwaniem. Niniejsze badanie miało na celu opracowanie i porównanie wielu modeli uczenia maszynowego (ML) dla przewidywania OP wśród pacjentów z cukrzycą, jednocześnie ewaluując ich przydatność kliniczną i poprawiając przezroczystość modelu za pomocą SHapley Additive exPlanations (SHAP). Wykorzystując rutynowo zebrane dane demograficzne i laboratoryjne z bazy danych MIMIC-IV, wiele algorytmów ML, w tym zespoły drzew, gradient boosting i liniowe bazy, zostało wytrenowanych i zweryfikowanych. Wykonanie modelu zostało kompleksowo ocenione przy użyciu metryk dyskryminacji, w tym powierzchni pod krzywą ROC (AUC) i analizy precyzji-odzysku, jak również krzywych kalibracji prawdopodobieństwa i analizy krzywej decyzji (DCA), aby ocenić netto korzyść kliniczną. Najlepszy model został dalej interpretowany za pomocą SHAP, aby sprecyzować i wizualizować wkład cech na poziomie globalnym i indywidualnym. Wśród wszystkich oceniarych modeli, metody oparte na zespołach drzew wykazały poprawę wydajności. Klasyfikator ExtraTrees osiągnął najwyższą wydajność walidacji (AUC = 0,862; średnia precyzja = 0,866). Co więcej, wybrany model wykazał doskonałą kalibracje prawdopodobieństwa (punktacja Brier = 0,154) i wykazał znaczny netto korzyść kliniczny w szerokim zakresie progów ryzyka w DCA. Analiza SHAP zidentyfikowała płeć i wiek jako najbardziej wpływowe predyktory, za którymi podążały rutynowe wskaźniki laboratoryjne hematologiczne i metaboliczne. Lokalne wyjaśnienia dostarczyły klinicznie interpretowalnych wglądów w indywidualne przewidywania. Interpretowalny model oparty na zespołach drzew efektywnie przewiduje ryzyko OP u pacjentów z cukrzycą przy użyciu rutynowo dostępnych zmiennych klinicznych. Integracja SHAP poprawia przezroczystość kliniczna, a mocna kalibracja w połączeniu z pozytywnym netto korzyścią kliniczną wspiera jego potencjalne wdrożenie jako niezawodnego narzędzia wsparcia decyzji dla wczesnej stratyfikacji ryzyka OP w populacjach diabetyków.
Wprowadzenie
Cukrzyca i osteoporoza (OP) to bardzo powszechne przewlekłe choroby, które coraz częściej występują jednocześnie, powodując znaczne obciążenie poprzez łamliwe złamania, niepełnosprawność i koszty opieki zdrowotnej. U pacjentów z cukrzycą typu 2 (T2D) ryzyko złamania jest paradoksalnie podwyższone nawet wtedy, gdy stężenie mineralne kości mierzone metodą absorptometrii rentgenowskiej dwóch energii (DXA) jest zachowane lub wyższe niż oczekiwano, co podkreśla, że jakość kości “jakościowa” oraz czynniki metaboliczne mają istotny wpływ na delikatność szkieletu1,2. Mimo że DXA jest klinicznym standardem w diagnozowaniu OP, jej dostępność i stosowanie pozostają ograniczone w wielu środowiskach, a ocena oparta na DXA może nie wychwytywać całkowicie ryzyka szkieletu związanego z cukrzycą. Na poziomie populacji, metaanalityczne dowody sugerują, że OP jest powszechna wśród osób z cukrzycą, choć szacunki dotyczące częstości występowania różnią się w różnych kohortach i kontekstach klinicznych3. Dlatego istnieje krytyczna potrzeba kliniczna i silna motywacja do opracowania praktycznych, skalowalnych narzędzi przewidywania ryzyka, które wykorzystują rutynowo zbierane dane kliniczne do wcześniejszego identyfikowania pacjentów z wysokim ryzykiem, a tym samym kierowania ukierunkowanym przesiewaniem i indywidualnymi strategiami prewencji.
W ostatnich latach, metody uczenia maszynowego (ML) były coraz częściej wykorzystywane do modelowania złożonych, nieliniowych relacji w danych klinicznych i do budowania predykcji ryzyka OP dla pacjentów z cukrzycą. Poprzednie badania wykazały obiecującą dyskryminację przy użyciu algorytmów takich jak gradient boosting, maszyny wektorów nośnych, sieci neuronowe i narzędzia w stylu nomogramu. Szczególnie, ostatnie osiągnięcia eksplorowały innowacyjne strategie modelowania, takie jak fuzja ML z logiką rozmytą, aby przewidywać ryzyko OP i związane z cukrzycą na podstawie czynników modyfikowalnych4,5,6. Jednakże, istnieje znacząca luka w badaniach: wiele istniejących modeli zostało opracowane w ograniczonych podgrupach (np. wyłącznie u kobiet po menopauzie lub u starszych pacjentów z T2D) i ocenionych w ograniczonym zestawie algorytmów kandydujących, pozostawiając niepewność co do tego, które wybory modelowania są optymalne dla szerszych populacji diabetycznych i zróżnicowane danych EHR (Electronic Health Record). Ponadto, krytyczną przeszkodą dla klinicznego wdrożenia tych wysoko wydajnych modeli ML jest ich “czarno-skrzynkowa” natura, która ogranicza zaufanie klinicystów i utrudnia przełożenie na rozwiązania wspomagające decyzje. SHapley Additive exPlanations (SHAP) oferuje rozwiązanie, oferując wyjaśnienia na poziomie przypadku, przypisując każde przewidywanie do indywidualnych cech za pomocą wartości Shapleya, umożliwiając lekarzom zweryfikowanie, czy rozumowanie modelu jest zgodne z prawdopodobienstwem klinicznym.
Aby zaatakować te luki, opracowaliśmy i zweryfikowaliśmy ramy przewidywania ryzyka OP dla pacjentów z cukrzycą, korzystając z bazy danych EHR z Critical Care Medical Information Mart for Intensive Care IV (MIMIC-IV)7. Nowość tego badania polega na kompleksowej ocenie porównawczej wielu rodzin modeli ML w połączeniu z przejrzystą interpretacją opartą na SHAP w dużej, klinicznie złożonej kohorcie diabetycznej. W przeciwieństwie do badań skoncentrowanych na pojedynczym algorytmie, nasze podejście end-to-end systematycznie wybiera najlepiej działający model na podstawie rygorystycznej walidacji i zapewnia przejrzyste, pacjentowe wyjaśnienia. Ten framework ma na celu zapewnienie zarówno solidnej wydajności predykcyjnej, jak i klinicznie działalnych wniosków, wspierając wcześniejszą stratyfikację ryzyka OP wśród pacjentów z cukrzycą.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
Źródło danych i oświadczenie etyczne
Niniejsze retrospektywne badanie wykorzystało dane z MIMIC-IV (wersja 3.1), publicznie dostępnej, anonimizowanej bazy danych EHR dotyczącej opieki krytycznej, hostowanej na PhysioNet. Baza danych zawiera informacje demograficzne, objawy życiowe, wyniki badań laboratoryjnych, diagnozy, zabiegi i leki.
Dostęp do MIMIC-IV wymaga autoryzacji i przestrzegania umowy o użytkowaniu danych PhysioNet oraz wymagań szkoleniowych. Badacze ukończyli wymagane szkolenia i otrzymali dostęp (numer certyfikatu: 68351548). Ponieważ baza danych jest anonimizowana, w niniejszym badaniu przeanalizowano anonimowe dane i nie miało to wpływu na bezpośredni kontakt z pacjentami; dlatego nie była wymagana zgoda pacjenta. Pełen, krokowy, wykonywalny przepływ modelowania jest przedstawiony na Rysunku 1.
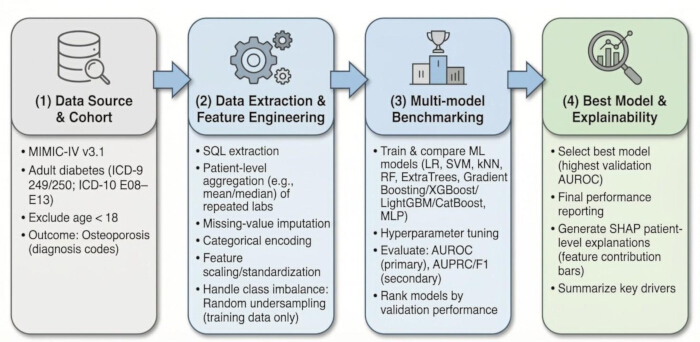
Rysunek 1. Ogólny przepływ modelowania dla predykcji ryzyka osteoporozy (OP) u pacjentów z cukrzycą. Schematyczne przedstawienie przebiegu badania, w tym identyfikacji kohorty, wyodrębniania danych, inżynierii cech, porównywania wielu modeli, wyboru modelu na podstawie wydajności walidacji oraz interpretacji modelu na podstawie SHAP. Prosimy kliknąć tutaj, aby zobaczyć większą wersję tego rysunku.
Populacja badawcza i wyodrębnienie danych
Dane zostały wyodrębnione z bazy danych Medical Information Mart for Intensive Care IV (MIMIC-IV) za pomocą narzędzia do zarządzania bazami danych. Aby zapewnić możliwość powtórzenia, dokładne zapytania SQL, w tym nazwy tabel i logika filtrowania użyta do pobierania kohorty, są dostępne w Pliku uzupełniającym 1. Dorośli pacjenci (≥18 lat) z rozpoznaniem cukrzycy wykryto za pomocą kodów ICD-9 (249, 250) i kodów ICD-10 (E08–E13). Główny wynik, OP, zdefiniowano za pomocą kodów ICD-9 (733.x) i kodów ICD-10 (M80, M81, M82). W początkowej kwalifikującej się kohorcie pacjentów z cukrzycą (n = 46 226) zidentyfikowano 3 672 pozytywne zdarzenia (pacjenci z OP) i 42 554 negatywne zdarzenia (pacjenci bez OP). Szczegółowy schemat selekcji pacjentów i ubytków przedstawiono na Rysunku 2.
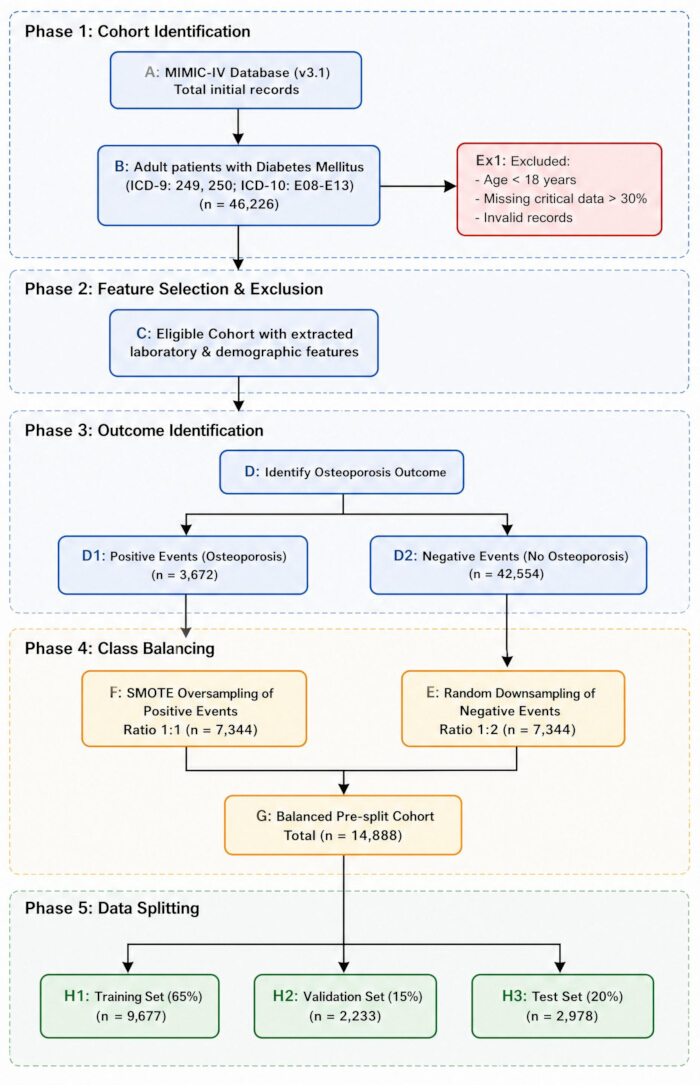
Rysunek 2. Schemat selekcji pacjentów i budowy kohorty. Schemat ilustruje stopniowe uzyskiwanie kohorty z bazy danych MIMIC-IV (v3.1). Dorośli pacjenci z cukrzycą zostali zidentyfikowani za pomocą kodów ICD, następnie wykluczono pacjentów w wieku <18 lat, brakujące dane krytyczne >30% lub nieważne rekordy. Ostateczna kohorta została podzielona na OP (pozytywne zdarzenia) i nie-OP (negatywne zdarzenia). Równowaga klas została rozwiązana za pomocą losowego podpróbkowania i SMOTE zastosowanego do danych treningowych przed podziałem zestawu danych na warstwy. Prosimy kliknąć tutaj, aby zobaczyć większą wersję tego rysunku.
Inżynieria cech
Aby zapewnić sprawiedliwe porównanie między wieloma algorytmami ML i dokładne powtarzanie, zastosowano identyczną sekwencję kroków przetwarzania wstępnego: wybór cech, uzupełnienie brakujących wartości, skalowanie ciągłych cech, zbilansowanie klas i podział zestawu danych. Pełna lista cech wejściowych, w tym nazwy zmiennych, jednostki i źródła danych, jest szczegółowo opisana w Tabeli 1.
| Cecha | Łącznie (n = 14 688) | Zestaw treningowy (n = 9 546) | Zestaw walidacji (n = 2 204) | Zestaw testowy (n = 2 938) | Wartość P |
| Płeć | 0,345 | ||||
| Mężczyzna | 6222 (42,36%) | 4045 (42,37%) | 935 (42,42%) | 1242 (42,27%) | |
| Kobieta | 8466 (57,64%) | 5501 (57,63%) | 1269 (57,58%) | 1696 (57,73%) | |
| Wiek | 0,28 (–0,40, 0,94) | 0,28 (–0,43, 0,94) | 0,23 (–0,46, 0,89) |
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
Porównanie wydajności modelu
Aby zidentyfikować optymalne podejście predykcyjne dla OP u pacjentów z cukrzycą, porównano systematycznie wiele modeli ML. W celu porównania wykorzystano zregularyzowany liniowy klasyfikator (regresja logistyczna) jako bazowy model kontrolny. Ogólne porównanie wydajności zostało podsumowane w Rysunkach 3–6. We wszystkich ocenianych modelach metody oparte na drzewach zespołowych przewyższyły liniową bazę w zakresie wydajności dyskryminacyjnej.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
W niniejszym badaniu wiele algorytmów uczenia maszynowego zostało systematycznie porównanych w celu zidentyfikowania optymalnego modelu predykcyjnego OP u pacjentów z cukrzycą. Metody oparte na drzewach zespołowych, szczególnie model ExtraTrees, wykazały lepszą dygrescję, wiarygodną kalibrację prawdopodobieństwa oraz większą czystą korzyść kliniczną w porównaniu z liniowymi wartościami bazowymi i innymi rodzinami algorytmów. Te wyniki wskazują, że nieliniowe interakcje i skomplikowane relacje cech są istotne dla dokładne...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
Autorzy deklarują, że badania przeprowadzono bez jakichkolwiek komercyjnych lub finansowych relacji, które mogłyby być uznane za potencjalny konflikt interesów.
Podziękowania
Autorzy z wdzięcznością dziękują za wsparcie finansowe ze strony Nantong Municipal Science and Technology Project (Grant No. JC2023039) oraz Social Development Guidance Program of Nantong Science and Technology Bureau (Grant No. MSZ2023054).
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| CatBoost | Yandex | v1.2 (lub stosowne) | Algorytm gradientowego wzmacniania zoptymalizowany dla cech kategorialnych |
| imbalanced-learn (SMOTE) | Scikit-learn Contrib | v0.11 (lub stosowne) | Biblioteka używana do wykonywania Syntetycznej Techniki Przepróbkowania Mniejszości dla równoważenia klas |
| LightGBM | Microsoft Corporation | v4.0 (lub stosowne) | Framework wzmacniania gradientowego opartego na drzewach decyzyjnych |
| Matplotlib | Matplotlib Development Team | v3.7 (lub stosowne) | Biblioteka wizualizacyjna używana do tworzenia wykresów i krzywych wydajności |
| MIMIC-IV Clinical Database | PhysioNet | v3.1 | Publicznie dostępny zestaw danych elektronicznych rejestrów zdrowotnych z opieki intensywnej używany jako źródło danych |
| Navicat Premium | PremiumSoft CyberTech Ltd. | v17.0 | Narzędzie do zarządzania bazami danych używane do ekstrakcji danych opartej na SQL |
| NumPy | NumPy Developers | v1.24 (lub stosowne) | Biblioteka obliczeń numerycznych używana do operacji na tablicach i przetwarzania danych |
| OpenPyXL | Eric Gazoni, Charlie Clark | v3.1 (lub stosowne) | Biblioteka używana do odczytywania i zapisywania plików Excel |
| Pandas | Pandas Development Team | v2.0 (lub stosowne) | Biblioteka do manipulacji i analizy danych dla strukturalizowanych zestawów danych |
| PostgreSQL | PostgreSQL Global Development Group | v14 (lub stosowne) | System bazy danych relacyjnej używany do wykonywania zapytań i zarządzania danymi MIMIC-IV |
| Python | Python Software Foundation | v3.8+ (lub stosowne) | Język programowania używany do przetwarzania, modelowania i analizy danych |
| Scikit-learn | Scikit-learn Developers | v1.3 (lub stosowne) | Biblioteka uczenia maszynowego używana do rozwoju modeli, przetwarzania wstępnego i ewaluacji |
| SciPy | SciPy Developers | v1.10 (lub stosowne) | Biblioteka do obliczeń naukowych używana do analizy statystycznej |
| Seaborn | Michael Waskom | v0.12 (lub stosowne) | Biblioteka wizualizacji danych statystycznych dla ulepszonych wyników graficznych |
| SHAP (SHapley Additive exPlanations) | Scott Lundberg | v0.42 (lub stosowne) | Framework używany do interpretacji predykcji modelu za pomocą wartości przypisywania cech |
| XGBoost | DMLC (Distributed Machine Learning Community) | v2.0 (lub stosowne) | Algorytm gradientowego wzmacniania szeroko stosowany do modelowania danych strukturalizowanych |