Niniejszy protokół przedstawia Trójstrumienną Sieć Rozplątaną (TDE-Net), framework do rekonstrukcji obrazów z sygnału EEG, który łączy komplementarne reprezentacje EEG, wyrównanie wizualne w podwójnej przestrzeni oraz dekodowanie dyfuzyjne.
Artykuł metodologiczny
Trzystrumienna sieć rozplątana z adaptacyjną fuzją w podwójnej przestrzeni do rekonstrukcji obrazów na podstawie elektroencefalografii w zbiorze THINGS-EEG2
W tym artykule
Podsumowanie
Streszczenie
Rekonstrukcja bodźców wzrokowych na podstawie nieinwazyjnej elektroencefalografii (EEG) wymaga odwzorowania krótkich, zaszumionych odpowiedzi neuronalnych na znaczące reprezentacje wizualne, mimo ograniczonego próbkowania przestrzennego. Istniejące podejścia do konwersji EEG na obrazy wykorzystują zróżnicowane reprezentacje neuronalne i strategie generatywne, co wymaga odtwarzalnych procesów roboczych oddzielających wkłady strukturalne i semantyczne. Niniejszy protokół przedstawia Tri-stream Disentangled Network (TDE-Net), ramy obliczeniowe służące do rekonstrukcji obrazów na podstawie EEG. Protokół wykorzystuje wstępnie przetworzone zapisy THINGS-EEG2 i organizuje informacje EEG w postaci surowej kotwicy EEG, specyficznego dla próbki strumienia grafu funkcjonalnego oraz wieloskalowego temporalnego strumienia semantycznego. Strumień grafu rejestruje relacje w dziedzinie częstotliwości między kanałami EEG za pomocą splotu grafowego i kontrastowego uczenia między próbami, podczas gdy strumień semantyczny wyodrębnia cechy istotne dla zadania za pomocą adaptacyjnego ważenia przestrzennego i wieloskalowych splotów temporalnych. Cechy strukturalne i semantyczne są mapowane osobno na przestrzenie latentne wariacyjnego autoenkodera (VAE) oraz modelu Contrastive Language-Image Pre-training (CLIP), łączone przy użyciu wag fuzji wybranych na zbiorze rozwojowym, a następnie dekodowane za pomocą Stable UnCLIP. W badaniu z udziałem 10 uczestników model TDE-Net osiągnął średnią dokładność identyfikacji parowej CLIP na poziomie 0,8135, a uzupełniające metryki wykazały zgodność w przestrzeni strukturalnej i cech. Analizy ablacyjne i na poziomie reprezentacji pozwoliły na dalszą charakterystykę wkładów poszczególnych strumieni. Protokół ten dostarcza odtwarzalnych ram do badania komplementarnych reprezentacji EEG oraz wizualnej rekonstrukcji opartej na modelach dyfuzyjnych.
Wprowadzenie
Dekodowanie percepcji wzrokowej to interdyscyplinarny obszar badań w zakresie interfejsów mózg-komputer (BCI) i neuronauki poznawczej. Funkcjonalny rezonans magnetyczny (fMRI) umożliwił realistyczną rekonstrukcję obrazów1,2,3,4, jednak jego koszt, ograniczona mobilność oraz opóźnienie hemodynamiczne ograniczają niektóre zastosowania. Elektroencefalografia (EEG) zapewnia pomiary czasowe w skali milisekund przy użyciu stosunkowo dostępnej aparatury, lecz niski stosunek sygnału do szumu oraz ograniczone próbkowanie przestrzenne utrudniają rekonstrukcję obrazu z sygnału EEG.
Złożoność metody należy interpretować w świetle ogólnego kompromisu między obciążeniem a wariancją (bias-variance trade-off)5. Wczesne metody dekodowania wizualnego wykorzystywały reprezentacje płytkie lub liniowe, podczas gdy w późniejszych badaniach wprowadzono kompaktowe kodery splotowe, oparte na grafach oraz mechanizmach uwagi6,7,8,9,10,11. Dopasowanie międzymodalne ewoluowało również od multimodalnego uczenia cech12,13 w stronę latentnych modeli dyfuzyjnych i dużych koderów wizyjnych14,15,16. Podejścia te ustanawiają przydatne wartości bazowe, jednak różnią się one pod względem reprezentacji wejściowych, celów latentnych oraz dekoderów, zatem wyniki należy interpretować w kontekście ich odpowiednich ustawień eksperymentalnych.
Celem TDE-Net jest dostarczenie modułowej struktury rekonstrukcji obrazów z sygnału EEG, która oddziela strukturalne i semantyczne reprezentacje EEG, dopasowuje je do komplementarnych latentnych przestrzeni wizualnych i integruje te predykcje w celu rekonstrukcji obrazu opartej na dyfuzji. Niedawne badania nad dekodowaniem wizualnym EEG wprowadziły sterowaną sygnałem EEG generację opartą na transformerach w EEG-CLIP17, dopasowanie świadome pierwszego planu z dynamicznymi sieciami mózgowymi w FSDBN18, adaptacyjne rozmycie sterowane poznawczo z dopasowaniem ograniczonym informacyjnie19 oraz wielopoziomowe dwukierunkowe uczenie biomimetyczne20. Powiązane potoki przetwarzania EEG-do-obrazu, w tym Perceptogram oraz dyfuzja sterowana osadzeniami EEG, stanowią dodatkowe punkty odniesienia dla predykcji latentnej21,22. TDE-Net różni się organizacją modelu: w sposób jawny oddziela surowy punkt odniesienia EEG, specyficzną dla próbki funkcjonalną reprezentację grafu oraz temporalną reprezentację semantyczną, a następnie wykonuje asymetryczne dopasowanie do przestrzeni VAE i CLIP przed fuzją. Taka organizacja umożliwia oddzielne badanie wkładu strukturalnego i semantycznego poprzez analizy w przestrzeni latentnej i na poziomie obrazu. W porównaniu z podejściami EEG-do-obrazu opartymi na pojedynczej reprezentacji lub bezpośrednim dopasowaniu, ta modułowa konstrukcja zapewnia oddzielne ścieżki strukturalne i semantyczne, zachowuje liniowy punkt odniesienia EEG podczas predykcji latentnej oraz umożliwia niezależną ocenę wkładu każdej reprezentacji poprzez analizy ablacyjne i analizy przestrzeni latentnej.
TDE-Net został zaprojektowany do eksperymentów z sparowanymi odpowiedziami EEG i bodźcami wizualnymi, przy zapewnieniu odpowiednich warunków treningowych oraz krótkiego okna po wystąpieniu bodźca, w którym głównym celem jest rekonstrukcja semantyczna. Jego etapowa organizacja umożliwia oddzielną analizę ekstrakcji cech, dopasowania ukrytego, fuzji oraz dekodowania dyfuzyjnego. Mapowania liniowe pozostają odpowiednie dla bardzo małych zbiorów danych lub w konfiguracjach priorytetyzujących minimalną złożoność modelu, natomiast dekodery neuronowe typu end-to-end mogą być preferowane w przypadku dostępności dużych, specyficznych dla zadania zbiorów danych oraz możliwości wdrożenia w czasie rzeczywistym.
Niniejszy protokół ocenia proponowaną konfigurację w ustawieniach szybkiej sekwencyjnej prezentacji wizualnej (RSVP) zbioru THINGS-EEG2. Główne wkładki obejmują schemat reprezentacji EEG w trzech strumieniach, składający się z surowej kotwicy liniowej, specyficznego dla próbki strumienia grafu funkcjonalnego oraz wieloskalowego strumienia semantyki czasowej. Te komplementarne reprezentacje są mapowane na przestrzenie utajone VAE i CLIP, a odpowiadające im predykcje są łączone przed dekodowaniem dyfuzyjnym. Rama została oceniona u wszystkich 10 badanych z THINGS-EEG2 przy użyciu miar rekonstrukcji na poziomie badanego, analiz ablacyjnych i okien czasowych oraz wizualizacji na poziomie reprezentacji, przy czym mapy uwagi przestrzennej zinterpretowano jako analizy kanałów skalpu (topograficzne).
Protokół
Protokół składa się z sześciu następujących po sobie etapów: przygotowania prób EEG i latentów obrazu; konstrukcji strumienia strukturalnego grafu; trenowania semantycznego koderu EEG; dopasowania odwzorowań CLIP/VAE; fuzji predykcji latentnych, a następnie dekodowania obrazu; oraz oceny wyników na poziomie obrazu i na poziomie reprezentacji (Rysunek 1).
1. Przygotowanie prób EEG i osadzeń obrazów
- Udokumentuj kohortę źródłową oraz protokół pozyskiwania danych.
UWAGA: Kohorta źródłowa składała się z 10 zdrowych osób dorosłych (średni wiek 28,5 lat, SD 4,0; osiem kobiet i dwóch mężczyzn) z normalnym lub skorygowanym do normy wzrokiem. Uczestnicy wyrazili pisemną świadomą zgodę, otrzymali rekompensatę finansową i przeszli oryginalny protokół zatwierdzony przez komisję etyczną Wydziału Edukacji i Psychologii na Freie Universität Berlin, zgodnie z Deklaracją Helsińską23.- Wykorzystaj publicznie dostępny zbiór danych THINGS-EEG2 jako zasób do analizy wtórnej.
- Użyj podziału źródłowego obejmującego 1 654 pojęcia treningowe i 200 niepokrywających się pojęć testowych zaczerpniętych z THINGS, z proporcjami 27 kategorii wyższego poziomu zrównoważonymi między podziałami. Wybierz dziesięć obrazów z naturalnym tłem dla każdego pojęcia treningowego i jeden obraz dla każdego pojęcia testowego, aby uzyskać 16 540 warunków treningowych i 200 wydzielonych warunków testowych.
UWAGA: W niniejszym badaniu w zadaniu detekcji celu wykorzystano oddzielne obrazy „przynęty” z Buzzem Lightyear'em, które zostały wykluczone z obecnej analizy rekonstrukcyjnej23. - Przy interpretacji epok przestrzegaj ram czasowych oryginalnego protokołu szybkiej seryjnej prezentacji wizualnej (RSVP).
UWAGA: Każda sekwencja rozpoczynała się od 750 ms przerwy pustej, po której następowało 20 obrazów prezentowanych centralnie. Każdy obraz zajmował 7 stopni kąta widzenia, pozostawał na ekranie przez 100 ms i posiadał 200 ms asynchronii początku bodźca (SOA), co odpowiadało 5 obrazom/s. Druga przerwa pusta trwająca 750 ms poprzedzała okres odpowiedzi trwający do 2 s, podczas którego uczestnicy najpierw mrugali, a następnie zgłaszali, czy pojawił się obraz celu. Centralny punkt fiksacyjny w kształcie tarczy pozostawał widoczny przez całą sekwencję23. - Przy organizacji zbioru danych uwzględnij strukturę oryginalnych sesji nagraniowych. Wykorzystaj dane z czterech sesji nagraniowych przeprowadzonych przez każdego uczestnika, gdzie każda sesja składała się z czterech serii testowych i 15 serii treningowych trwających około 5 min każda. Zachowaj cztery powtórzenia dla każdego warunku treningowego i 80 powtórzeń dla każdego warunku testowego, co odpowiada 82 160 analizowanym próbom z obrazami nietarczowymi na uczestnika23.
- Użyj danych EEG pozyskanych z oryginalną konfiguracją nagraniową THINGS-EEG2. Nagrania te zostały wykonane z częstotliwością 1 000 Hz przy użyciu 64-elektrodowej czepek EASYCAP rozmieszczonej zgodnie z międzynarodowym systemem 10-10 oraz wzmacniacza BrainVision actiCHamp, z elektrodą Fz jako referencją online i online filtrem pasmowo-przepustowym 0,1–100 Hz.
- Użyj udostępnionych danych wstępnie przetworzonych, które zostały podzielone na epoki od -200 do 800 ms względem początku obrazu, skorygowane względem linii bazowej z wykorzystaniem przedziału przedbodźcowego, podpróbkowane do 100 Hz, ograniczone do 17 kanałów ciemieniowo-potylicznych, oczyszczone z prób z obrazami celu i poddane wielowymiarowej normalizacji szumu niezależnie w każdej sesji nagraniowej23.
- Przygotuj tensory prób EEG
- Wczytaj udostępnione wstępnie przetworzone tensory THINGS-EEG2 dla wszystkich 10 uczestników. Z każdej epoki źródłowej wybierz przedział 0–800 ms po bodźcu i 17 kanałów ciemieniowo-potylicznych, zachowując częstotliwość próbkowania 100 Hz, aby uzyskać 80 punktów czasowych na próbę. Zachowaj podział źródłowy na 16 540 warunków obrazów treningowych i 200 wydzielonych warunków obrazów testowych dla każdego uczestnika23 (Rysunek 2).
- W przypadku wstępnego trenowania strumienia grafowego zachowaj cztery niezależne powtórzenia treningowe dla każdego warunku obrazu i wylosuj dwa powtórzenia w celu utworzenia pary pozytywnej. Dla strumieni surowych i semantycznych oblicz średnią z czterech powtórzeń treningowych oraz średnią z 80 dostępnych powtórzeń testowych dla każdego warunku.
- Użyj wstępnie przetworzonych tensorów THINGS-EEG2 wygenerowanych przez oryginalny potok MVNN; w każdym zaimplementowanym ekstraktorze cech zastosuj udokumentowane skalowanie Z na poziomie pliku przed obliczeniem cech.
UWAGA: To asymetryczne wykorzystanie powtórzeń jest zamierzone: powtórzone próby dostarczają par pozytywnych dla kontrastowego wstępnego trenowania strumienia grafowego, natomiast strumienie surowe i semantyczne wykorzystują średnie na poziomie warunku do mapowania nadzorowanego. Wynikowa konstrukcja łączy naukę niezmienności na poziomie powtórzeń w strumieniu strukturalnym z predykcją latentną na poziomie warunku w strumieniach surowych i semantycznych.
- Przygotuj sparowane latenty obrazów
- Użyj 1 024-wymiarowego koder wizyjny CLIP oraz kodera VAE powiązanego z sd2-community/stable-diffusion-2-1-unclip, aby wyekstrahować sparowane cele obrazów. Zmień rozmiar obrazów wejściowych VAE na 768 x 768 pikseli, zapisz tryb posterior VAE jako wektor 36 864-wymiarowy (4 x 96 x 96) i zachowaj kolejność obraz-warunek.
- Zapisz trzy formy wejściowe: tensory powtórzonych prób dla kontrastowego uczenia grafowego, uśrednione tensory EEG dla strumieni surowych i semantycznych oraz sparowane latenty obrazów CLIP/VAE dla mapowania nadzorowanego.
- Znormalizuj i zapamiętaj wejścia w pamięci podręcznej
- Zapisz w pamięci podręcznej wstępnie przetworzone tensory EEG, wyekstrahowane cechy grafowe i semantyczne oraz sparowane latenty obrazów z ustalonym porządkiem warunków.
- Podczas mapowania grzbietowego (ridge mapping) oszacuj parametry standaryzacji dla poszczególnych cech na podstawie wejść treningowych i zastosuj te parametry do wejść rozwojowych i testowych.
2. Konstrukcja strukturalnego strumienia grafu
- Skonstruuj strumień grafów z powtarzanych prób treningowych i wyeksportuj cechy na poziomie węzłów po kontrastowym wstępnym trenowaniu. Zastosuj tę samą regułę konstrukcji grafu do ekstrakcji cech testowych, nie używając latentów obrazów testowych podczas obliczania cech.
- Przekształć próby EEG w wejścia grafowe w dziedzinie częstotliwości
- Przekształć każdą próbę za pomocą 80-punktowej szybkiej transformaty Fouriera (FFT) i zachowaj pierwsze 40 koszyków częstotliwości nieujemnych, obejmujących zakres 0 Hz–48.75 Hz przy częstotliwości próbkowania 100 Hz. Użyj widma logarytmicznej amplitudy jako macierzy cech węzłów X o wymiarach 17 x 40. Dla każdej próbki EEG oblicz C_ij = |corr(X_i, X_j)| pomiędzy każdą parą 17 wektorów cech kanałów.
- W każdym wierszu zachowaj diagonalną autokorelację oraz trzy najsilniejsze korelacje pozadiagonalne (k = 4 zachowanych wpisów łącznie z autokorelacją), a następnie zsymetryzuj zachowaną macierz, aby zdefiniować specyficzną dla próbki ważoną macierz sąsiedztwa funkcjonalnego A. Zastosuj symetryczną normalizację stopnia przed splotem grafowym.
- Stosuj tę konstrukcję podczas trenowania i testowania; fizyczne współrzędne elektrod nie są używane do definiowania stałego grafu.
UWAGA: Zachowanie autopołączeń pozwala na zachowanie sygnału każdego węzła, natomiast ograniczenie połączeń międzykanałowych do 3 na wiersz kontroluje gęstość grafu przed symetryzacją. Reprezentacja w dziedzinie częstotliwości zapewnia kompaktowy opis oparty na amplitudzie do konstrukcji grafu, ale nie zachowuje fazy ani wszystkich szczegółowych czasów ERP zablokowanych fazowo; te aspekty czasowe pozostają dostępne w surowych strumieniach czasowych kotwicowych i semantycznych.
- Agreguj topologię elektrod za pomocą spektralnego splotu grafowego
- Zastosuj pięciowarstwową grafową sieć splotową (GCN)24 z 80 jednostkami ukrytymi na warstwę, aktywacjami ReLU, dropoutem 0.3, symetryczną normalizacją stopnia oraz średnim poolingiem grafowym.
- Użyj 80-wymiarowej dwuwarstwowej głowicy projekcyjnej dla celu kontrastowego i wyeksportuj reprezentację na poziomie węzłów 17 x 80 do fuzji strukturalnej. Zastosuj spektralny splot grafowy do macierzy sąsiedztwa zależnej od wejścia; nie wprowadzaj oddzielnego dynamicznego operatora splotu.
- Trenuj strumień grafowy za pomocą międzypróbkowego uczenia kontrastowego
- W obrębie partycji treningowej wybierz losowo dwie powtórzenia z tego samego warunku obrazu jako parę pozytywną i traktuj reprezentacje z innych warunków w partii jako negatywne. Optymalizuj kontrastowy cel InfoNCE25 z temperaturą τ = 0.5, rozmiarem partii 32, optymalizatorem Adam z szybkością uczenia 5 x 10⁻⁴, 20 epokami, wygaszaniem cosinusoidalnym do eta_min = 10–6 i losowym ziarnem 42.
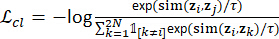 (1)
- Zdefiniuj podobieństwo cosinusowe w celu kontrastowym i użyj funkcji wskaźnikowej do identyfikacji sparowanych powtórzeń. Utrzymaj wymiar projekcji na poziomie 80 i zastosuj tę samą temperaturę do obu kierunków straty kontrastowej.
- W obrębie partycji treningowej wybierz losowo dwie powtórzenia z tego samego warunku obrazu jako parę pozytywną i traktuj reprezentacje z innych warunków w partii jako negatywne. Optymalizuj kontrastowy cel InfoNCE25 z temperaturą τ = 0.5, rozmiarem partii 32, optymalizatorem Adam z szybkością uczenia 5 x 10⁻⁴, 20 epokami, wygaszaniem cosinusoidalnym do eta_min = 10–6 i losowym ziarnem 42.
- Wyeksportuj cechy grafowe na poziomie węzłów do wczesnej fuzji
- Zamroź koder grafowy po wstępnym trenowaniu i wyeksportuj cechy węzłów 17 kanałów z 80 wymiarami na węzeł. Połącz te cechy ze uśrednionym surowym EEG wzdłuż wymiaru cech, aby uzyskać strukturalne wejście surowe-plus-grafowe do mapowania VAE.
- Zapisz wynikowy tensor cech surowych-plus-grafowych i używaj go wyłącznie jako wejścia strukturalnego do gałęzi regresji VAE.
3. Trenowanie semantycznego koder EEG
- Wytrenuj semantyczny koder EEG na uśrednionych tensorach EEG o 17 kanałach i 80 punktach.
- Zoptymalizuj stratę osadzenia cosinusowego (cosine embedding loss) za pomocą AdamW (learning rate 5 x 10⁻⁴; weight decay 0.01), wielkością partii (batch size) 64, przez 50 epok, z wyżarzaniem cosinusowym (cosine annealing) do eta_min = 10–6, losowym ziarnem (random seed) 42 oraz wyjściem 1,024-wymiarowym.
- Zastosuj sterowane danymi adaptacyjne filtrowanie przestrzenne
- Zastosuj uczenia się operację ważenia kanałów produktem tensorowym do wejściowego tensora EEG i rozszerz reprezentację do głębokości 9. Potraktuj tę operację jako warstwę ważenia kanałów sterowaną danymi, a nie jako implementację klasycznego filtra przestrzennego Common Spatial Pattern (CSP)26.
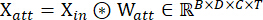 (2)
- Użyj wyuczonej operacji ważenia kanałów do wygenerowania dziewięciu map cech, a następnie przekaż je do bloku wieloskalowej konwolucji czasowej.
- Zastosuj uczenia się operację ważenia kanałów produktem tensorowym do wejściowego tensora EEG i rozszerz reprezentację do głębokości 9. Potraktuj tę operację jako warstwę ważenia kanałów sterowaną danymi, a nie jako implementację klasycznego filtra przestrzennego Common Spatial Pattern (CSP)26.
- Modeluj czasowe pola recepcyjne w wielu skalach
- Zastosuj trzy równoległe konwolucje czasowe z rozmiarami jądra 5, 15 i 31 próbek, stosując dopełnienie (padding) o tej samej długości. Połącz trzy wyjścia, aby uzyskać 24 czasowe kanały cech, a następnie zastosuj normalizację partii (batch normalization) i aktywację GELU.
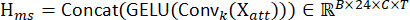 (3)
UWAGA: Konwolucje zapewniają wieloskalowe czasowe pola recepcyjne w ramach szerszego modelu konwolucji czasowej27. - Wykorzystaj trzy rozmiary jądra jako wieloskalowe filtry czasowe; interpretuj ich wyjście jako wyuczone reprezentacje sygnału, a nie jako bezpośrednie przypisania do konkretnych komponentów ERP.
- Zastosuj trzy równoległe konwolucje czasowe z rozmiarami jądra 5, 15 i 31 próbek, stosując dopełnienie (padding) o tej samej długości. Połącz trzy wyjścia, aby uzyskać 24 czasowe kanały cech, a następnie zastosuj normalizację partii (batch normalization) i aktywację GELU.
- Rekalibruj kanały cech istotne dla zadania
- Zastosuj mechanizm uwagi głębokościowej (depth attention) z adaptacyjnym uśrednianiem (average pooling) w wymiarze czasowym oraz konwolucję o jądrze 7, a następnie normalizację Softmax, zgodnie z zasadami rekalibracji kanałów28. Pomnóż wynikowe wagi uwagi element po elemencie z wieloskalowym tensorem cech.
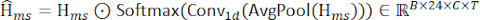 (4)
- Użyj wyjścia mechanizmu uwagi jako wejścia do bloku konwolucji przestrzennej i nie interpretuj wyuczonych wag jako przyczynowej lokalizacji neuronalnej.
- Zastosuj mechanizm uwagi głębokościowej (depth attention) z adaptacyjnym uśrednianiem (average pooling) w wymiarze czasowym oraz konwolucję o jądrze 7, a następnie normalizację Softmax, zgodnie z zasadami rekalibracji kanałów28. Pomnóż wynikowe wagi uwagi element po elemencie z wieloskalowym tensorem cech.
- Eksportuj globalną semantyczną cechę EEG
- Zastosuj konwolucję 1 x 1, a następnie konwolucję głębokościową (depthwise convolution) obejmującą 17 kanałów elektrod, normalizację partii, aktywację GELU, uśrednianie (average pooling) z czynnikiem 2 oraz dropout p = 0.5. Spłaszcz (flatten) wynik i rzutuj go na 1,024-wymiarowy semantyczny wektor cech.
- Zapisz jeden 1,024-wymiarowy semantyczny wektor cech dla każdej uśrednionej próbki EEG.
4. Mapowanie cech EEG na przestrzenie latentne CLIP i VAE
- Sparuj każdy tensor cech EEG z latentem obrazu o tym samym indeksie warunku. Dopasuj oddzielne odwzorowania dla celów CLIP i VAE, dbając o to, aby wszystkie warunki obrazów w partycji treningowej były rozłączne z tymi w wydzielonej partycji testowej.
- Zastosuj regresję grzbietową (ridge regression)29 z wyrazem wolnym i maksymalną liczbą 50 000 iteracji. Użyj λCLIP = 1 000 dla odwzorowań raw-to-CLIP i semantic-to-CLIP, λVAE = 0 dla kotwicy raw-to-VAE oraz λVAE, struct = 1 000 dla odwzorowania structural-stream-to-VAE. Znormalizuj dane wejściowe odwzorowań, korzystając ze statystyk partycji dopasowującej.
UWAGA: Strumień strukturalny (structural stream) stanowi konkatenację surowego EEG i cech grafowych; strumień semantyczny zawiera wyjście koderem semantycznym bez konkatenacji z cechami surowymi. - Odwzoruj cechy strukturalne na przestrzeń latentną VAE
- Dopasuj odwzorowanie grzbietowe structural-stream-to-VAE z λVAE,struct = 1 000 i przewiduj 36 864-wymiarowy latent VAE. Gałąź ta przyjmuje skonkatenowane reprezentacje surowego EEG i grafów; jest to jedyna nieliniowa gałąź, która jawnie konkatenuje cechy surowe.
- Odwzoruj cechy semantyczne na przestrzeń latentną CLIP
- Dopasuj odwzorowanie grzbietowe semantic-stream-to-CLIP z λCLIP = 1 000 i przewiduj 1 024-wymiarową reprezentację CLIP. Wejście semantyczne nie jest konkatenowane z surowym EEG.
UWAGA: W niniejszym artykule λ oznacza regularyzację grzbietową, a α oznacza wagę fuzji latentnej. - Oceń wyrównanie przestrzeni latentnych za pomocą współczynnika korelacji Pearsona (PCC) obliczanego dla poszczególnych próbek. Użyj warunków rozwojowych do wyboru wag fuzji, a ocenę 200 wydzielonych warunków testowych przeprowadź dopiero po zamrożeniu odwzorowań i wag fuzji.
- Dopasuj odwzorowanie grzbietowe semantic-stream-to-CLIP z λCLIP = 1 000 i przewiduj 1 024-wymiarową reprezentację CLIP. Wejście semantyczne nie jest konkatenowane z surowym EEG.
5. Połącz latentne predykcje i przeprowadź rekonstrukcję dyfuzyjną
- Wybierz αVAE oraz αCLIP, korzystając z podziału rozwojowego na poziomie warunków, pochodzącego wyłącznie z 16 540 warunków treningowych. Przy losowym ziarnie (seed) 42 zastosuj te same wskaźniki dopasowania (fit indices) 90% i wskaźniki rozwojowe 10% dla wszystkich 10 badanych; 200 wydzielonych warunków testowych pozostaje poza tą procedurą.
UWAGA: Kary ridge oraz współczynnik zachowania struktury zostały ustalone jako wartości konfiguracyjne przed końcową ewaluacją zbioru wydzielonego i nie były dostrajane w odniesieniu do 200 warunków testowych. - Dla każdego badanego i każdego kandydata α z zestawu {0.00, 0.05, ..., 1.00} dopasuj enkoder nadzorowany przez cel oraz mapowania ridge na podzbiorze dopasowującym i oblicz średnią próbkową latentną wartość PCC na podzbiorze rozwojowym.
- Oblicz średnią z wartości PCC na poziomie badanego z równą wagą dla wszystkich 10 osób, a następnie niezależnie wybierz wagi dla przestrzeni CLIP i VAE na podstawie maksymalnej średniej międzybadanymi. Zamroź obie wartości przed ponownym dopasowaniem końcowych modeli treningowych i ewaluacją wydzielonych warunków testowych.
UWAGA: Procedura ta pozwoliła wybrać αCLIP = 0.55 oraz αVAE = 0.65. - Dla przestrzeni VAE zdefiniuj fuzję predykcji jako sumę ważoną kotwicy raw-to-VAE oraz predykcji VAE ze strumienia strukturalnego:
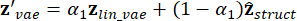 (5)
- Ustaw αVAE = 0.65, tak aby kotwica raw-to-VAE wnosiła 0.65, a predykcja ze strumienia strukturalnego 0.35. Zachowaj tę wartość jako stałą dla każdego badanego i warunku testowego.
- Dla przestrzeni CLIP zdefiniuj fuzję predykcji jako sumę ważoną kotwicy raw-to-CLIP oraz predykcji CLIP ze strumienia semantycznego:
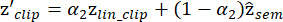 (6)
- Ustaw αCLIP = 0.55, tak aby kotwica raw-to-CLIP wnosiła 0.55, a predykcja ze strumienia semantycznego 0.45. Zachowaj tę wartość jako stałą dla każdego badanego i warunku testowego.
UWAGA: Operację fuzji należy interpretować jako stały ważony zespół predykcji latentnych w ogólnym znaczeniu kombinacji zespołowej (ensemble combination)30. Nie należy opisywać jej jako gwarantowanej redukcji przeuczenia ani jako rozwiązania optymalnego w sposób jednolity dla wszystkich metryk. - Wczytaj zamrożony potok obraz-na-obraz Stable UnCLIP z sd2-community/stable-diffusion-2-1-unclip z wagami wariacji fp16. Użyj fuzji embeddingów CLIP jako warunku semantycznego i fuzji latentów VAE jako inicjalizacji strukturalnej.
UWAGA: Dekoder opiera się na zasadach dyfuzji odszumiającej oraz prowadzenia bezklasyfikatorowego (classifier-free guidance)31,32. - Zastosuj zaszumioną inicjalizację strukturalną do latentów dyfuzyjnych. Zmień kształt każdej 36 864-wymiarowej predykcji VAE na 4 x 96 x 96, zgodnie z sformułowaniem latentów wariacyjnego autoenkodera33, i dodaj szum Gaussa po pomnożeniu latentu strukturalnego przez skalę strukturalną gamma = 0.02. W raportowanej procedurze rekonstrukcji użyj kroków czasowych treningu dyfuzji T_diff = 1 000 oraz stałego ziarna dyfuzji 0.
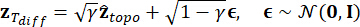 (7)
- Ustaw współczynnik zachowania struktury gamma na 0.02 w zaszumionej inicjalizacji i zachowaj tę wartość jako stałą dla wszystkich warunków testowych. Przekaż wynikający latent do dekodera bez użycia informacji z obrazu rzeczywistego (ground-truth).
- Zastosuj prowadzenie za pomocą mechanizmu cross-attention i zdekoduj latent obrazu. Połącz zfuzowany 1 024-wymiarowy wektor CLIP z 1 024-wymiarowym rozszerzeniem warunkującym używanym przez potok, dodaj na początku zerowy wektor warunku negatywnego dla prowadzenia bezklasyfikatorowego (CFG) i zdekoduj przy skali prowadzenia 7.5. Użyj domyślnej dla potoku liczby 20 kroków odszumiania i zapisz jeden obraz PNG dla każdego warunku testowego.
- Zapisz zrekonstruowany obraz z oryginalnym indeksem warunku testowego i zachowaj ten sam indeks dla wszystkich kolejnych obliczeń metryk.
UWAGA: Tabela 1 podsumowuje podział danych, przetwarzanie wstępne, konstrukcję grafu, trening modelu, mapowanie latentne, fuzję oraz ustawienia dekodowania użyte w raportowanym przepływie pracy. Dołączony arkusz zawiera to samo podsumowanie parametrów w formacie czytelnym dla maszyn.
6. Ocena rekonstrukcji i dopasowania na poziomie reprezentacji
- Oblicz wierność na niskim poziomie za pomocą korelacji pikseli (PixCorr) oraz podobieństwa strukturalnego (SSIM). Oblicz dokładność identyfikacji parowej dla warstwy 2 AlexNet, warstwy 5 AlexNet, Inception-v3 oraz OpenAI CLIP ViT-L/14; oblicz odległości korelacyjne dla EfficientNet (EffNet) i SwAV, gdzie niższe wartości wskazują na bliższe reprezentacje cech.
- W analizie CLIP stwórz macierz korelacji między cechami wyekstrahowanymi z 200 zrekonstruowanych obrazów a odpowiadającymi im 200 obrazami referencyjnymi (ground-truth). Dla każdej rekonstrukcji porównaj korelację z poprawnym obrazem z korelacjami z pozostałymi 199 obrazami, a następnie wyciągnij średnią z wynikowych 200 x 199 porównań binarnych, aby uzyskać dokładność identyfikacji parowej CLIP.
- Dla rozszerzających się okien kończących się w punktach czasowych 8, 16, ..., 80, dopasuj mapowania ridge dla surowego sygnału EEG i oblicz średni próbkowy współczynnik PCC pomiędzy przewidywanymi a referencyjnymi latentami CLIP i VAE dla 200 warunków testowych sub-01. Wykorzystaj predykcje CLIP i VAE dla pełnego okna (wyłącznie strumień semantyczny) jako przerywane poziomy referencyjne.
- Zbuduj macierze podobieństwa reprezentacji (RSM) z cech CLIP znormalizowanych w normie L2, wykorzystując podobieństwo cosinusowe. Uporządkuj obie macierze za pomocą hierarchicznej klasteryzacji metodą Warda dla referencyjnych osadzeń (embeddings) CLIP przy użyciu odległości euklidesowej.
- Do wizualizacji dwuwymiarowej wyznacz pięć klastrów k-średnich z referencyjnych osadzeń i zastosuj jedną wspólną projekcję PCA-50 oraz t-distributed stochastic neighbor embedding (t-SNE) do cech referencyjnych i przewidywanych; t-SNE wykorzystaj wyłącznie do wizualizacji jakościowej.
- Wizualizuj wybielone wzorce EEG oraz wagi modelu dla kanałów skalpu z etykietami kanałów, wyraźnymi skalami kolorystycznymi i reprodukowalnymi regułami szeregowania. Interpretuj te wykresy jako analizy pomocnicze zmierzonych sygnałów skalpu i parametrów modelu, a nie jako dowód na lokalizację źródeł korowych, aktywację anatomiczną lub przyczynowość.
Wyniki
Sieć TDE-Net została oceniona z sześciu komplementarnych perspektyw: wydajności rekonstrukcji, reprezentatywnych wyników wizualnych, wkładu poszczególnych komponentów, zależności czasowej, semantycznej struktury reprezentacji oraz uwagi kanałów skóry głowy. Wierność na niskim poziomie oceniano za pomocą wskaźników PixCorr i SSIM, dopasowanie w przestrzeni cech przy użyciu miar AlexNet, Inception-v3, CLIP, EffNet i SwAV, a wydajność na poziomie podmiotu na podstawie wyników wszystkich 10 podmiotów z zestawu THINGS-EEG2. Chyba że zaznaczono inaczej, każda rycina jakościowa określa odpowiadającego jej podmiotu oraz podzbiór warunków testowych.
Wydajność rekonstrukcji i reprezentatywne wyniki
Jako wewnętrzny model referencyjny zaimplementowaliśmy dodatkowo lekki bazowy enkoder EEG oparty na konwolucyjnej uwadze. Model ten wyodrębnia pojedynczą 1024-wymiarową reprezentację EEG z każdego próbowania i mapuje ją niezależnie na przestrzenie latentne CLIP oraz VAE, stosując ten sam protokół regresji grzbietowej i dekodowania dyfuzyjnego, co w proponowanej metodzie. W kolejnych sekcjach model ten jest oznaczany jako Baseline. Enkoder stanowi referencja semantyczna z konwolucyjną uwagą w stylu LMDA, wykorzystywana w implementacji lokalnej, posiadająca 373 950 trenowalnych parametrów i wyjście 1 024-wymiarowe.
Tabela 2 porównuje TDE-Net z wewnętrznym baseline'em opartym na splotowej uwadze (convolutional-attention) oraz reprezentatywnymi metodami rekonstrukcji obrazów na podstawie EEG w odniesieniu do zgłoszonych metryk. Dla zapewnienia spójnej oceny metody zostały zaimplementowane w ujednoliconym środowisku eksperymentalnym, przy użyciu tego samego podziału zbioru THINGS-EEG2, 17-kanałowego wejścia, obróbki wstępnej, warunków testowych na zbiorze wydzielonym oraz definicji metryk, przy jednoczesnym zachowaniu specyficznych dla danej metody architektur. W podsumowaniu dla dziesięciu ochotników TDE-Net osiągnął wartości średnia ± SD wynoszące 0,2531 ± 0,0138 dla PixCorr, 0,3388 ± 0,0025 dla SSIM, 0,8777 ± 0,0115 dla AlexNet Layer 2, 0,9153 ± 0,0116 dla AlexNet Layer 5, 0,7606 ± 0,0213 dla Inception-v3, 0,8135 ± 0,0074 dla dokładności identyfikacji parzystej CLIP, 0,8285 ± 0,0122 dla dystansu EffNet oraz 0,5085 ± 0,0101 dla dystansu SwAV. Podsumowanie na poziomie poszczególnych ochotników uzupełnia jakościowe przykłady dla pojedynczych osób.
Wartość CLIP oznacza dokładność identyfikacji parzystej, a nie podobieństwo cosinusowe czy ogólny wynik cech CLIP. Ponieważ strumień semantyczny jest trenowany w kierunku celu w przestrzeni CLIP, miara ta odzwierciedla zarówno rekonstrukcję semantyczną, jak i wyrównanie z celem jednej z gałęzi. Jest ona zatem rozpatrywana łącznie z PixCorr, SSIM, AlexNet, Inception-v3, EffNet i SwAV, które charakteryzują komplementarne aspekty wierności na niskim poziomie oraz zgodności w przestrzeni cech.
Aby scharakteryzować wydajność na poziomie poszczególnych osób badanych, zastosowaliśmy pełną procedurę testową TDE-Net dla osób od sub-01 do sub-10, wykorzystując te same 200 wydzielonych warunków obrazowych dla każdego badanego. Tabela 3 przedstawia wszystkie osiem miar oceny dla każdego badanego, wraz ze średnią międzyosobniczą i odchyleniem standardowym (SD) próby. Średnia dokładność identyfikacji parowej CLIP wyniosła 0,8135 (SD, 0,0074). Średnie wartości PixCorr i SSIM wyniosły odpowiednio 0,2531 i 0,3388. Dokładność dla warstwy 2 i warstwy 5 sieci AlexNet wyniosła średnio 0,8777 i 0,9153, a dokładność sieci Inception-v3 średnio 0,7606. Średnie odległości dla EffNet i SwAV, w których niższa wartość oznacza lepszy wynik, wyniosły odpowiednio 0,8285 i 0,5085. Ograniczona dyspersja na poziomie osób badanych w obrębie tych miar wskazuje na porównywalne ilościowe zachowanie rekonstrukcji u 10 badanych w zbiorze THINGS-EEG2.
Rysunek 3 przedstawia rekonstrukcje dla tych samych siedmiu indeksów warunków pominiętych (1, 32, 62, 86, 87, 108 oraz 175; numeracja plików od zera) dla wszystkich 10 badanych. Górny rząd pokazuje bodźce rzeczywiste (ground-truth), a kolejne rzędy odpowiadające im rekonstrukcje dla osób od sub-01 do sub-10. Rekonstrukcje zachowują wspólne kategorie semantyczne i charakterystyczne atrybuty wizualne bodźców, podczas gdy szczegółowa tożsamość obiektu, kształt i lokalna tekstura różnią się między badanymi. Taki układ stanowi jakościowy odpowiednik wyników międzyosobniczych podsumowanych w Tabeli 3.
Rysunek 4 przedstawia jakościowe rekonstrukcje dla sześciu określonych warunków testowych sub-01. Wiersze pokazują bodziec rzeczywisty (ground-truth), komparator Perceptogram wygenerowany przez naszą lokalną implementację21 oraz rekonstrukcję TDE-Net. Przykłady te podkreślają zachowanie kategorii obiektu, kształtu, koloru i cech tła, podczas gdy szczegółowa tożsamość i detale tła różnią się w zależności od metody.
Rysunek uzupełniający 1 przedstawia grupy najlepszej, średniej i najgorszej rekonstrukcji wybranych z 200 warunków testowych sub-01 w zbiorze THINGS-EEG223. Warunki zostały uszeregowane według zgodności cosinusowej między zamrożonym, połączonym osadzeniem CLIP przewidzianym na podstawie EEG a odpowiadającym mu osadzeniem CLIP obrazu referencyjnego. Wyświetlone grupy ilustrują zakres zgodności semantycznej zaobserwowany u tego badanego.
Wkład komponentów i zachowanie podczas fuzji
Tabela 4 przedstawia stopniową ablację strumieni strukturalnych i semantycznych w oparciu o średnie wartości dla wszystkich badanych, uzyskane w ramach tej samej procedury ewaluacji. Liniowy Punkt Odniesienia (Linear Anchor) bezpośrednio przewiduje latenty CLIP i VAE z wstępnie przetworzonych danych EEG przy użyciu regresji grzbietowej i służy jako kontrolowany punkt wyjścia dla badania ablacyjnego. Jest on zgodny z ogólną zasadą liniowego mapowania latentnego stosowaną w poprzednich badaniach nad konwersją EEG na obrazy, w tym w Perceptogram21, przy jednoczesnym zastosowaniu ustawień wstępnego przetwarzania, regularyzacji, dekodowania i ewaluacji obowiązujących w niniejszym schemacie. Taka konstrukcja pozwala na zbadanie strumienia strukturalnego, strumienia semantycznego oraz fuzji podwójnej przestrzeni w odniesieniu do wspólnego punktu odniesienia liniowego.
Wychodząc od modelu Linear Anchor, dodanie strumienia strukturalnego zwiększyło wartość SSIM z 0.331 do 0.339 oraz dokładność AlexNet Layer 5 z 0.913 do 0.932, choć dokładność AlexNet Layer 2 nieznacznie spadła z 0.889 do 0.886. Z kolei dodanie strumienia semantycznego pozwoliło uzyskać najwyższą wartość PixCorr (0.237), przy zachowaniu wysokiej dokładności AlexNet Layer 2 (0.888) i zredukowaniu dystansów EffNet oraz SwAV odpowiednio do 0.865 i 0.531. Po włączeniu obu strumieni poprzez fuzję w podwójnej przestrzeni (dual-space fusion), model TDE-Net osiągnął najwyższą dokładność identyfikacji parowej dla Inception-v3 (0.761) i CLIP (0.814), wraz z najniższymi dystansami EffNet (0.829) i SwAV (0.509). Jego dokładność AlexNet Layer 2 (0.878) pozostała niższa niż w przypadku Linear Anchor, a wartość SSIM (0.339) była nieco niższa niż w konfiguracji ze strumieniem strukturalnym. Ogólnie wyniki ablacji międzyosobniczej wykazują, że strumienie strukturalny i semantyczny wpływają na różne aspekty rekonstrukcji, podczas gdy ich fuzja przede wszystkim wzmacnia identyfikację semantyczną i spójność w głębokiej przestrzeni cech.
Rysunek 5 przedstawia czułość zbioru rozwojowego na dwie wagi fuzji w zakresie α = 0.00–1.00 w przyrostach 0.05. Krzywa dla przestrzeni CLIP osiąga maksimum przy αCLIP = 0.55, podczas gdy krzywa dla przestrzeni VAE osiąga maksimum przy αVAE = 0.65. Podobne wartości PCC zaobserwowano dla sąsiednich kandydatów, natomiast maksima wystąpiły przy różnych wagach dla obu przestrzeni latentnych.
Wkład czasowy sygnałów EEG
Rysunek 6 przedstawia średni dla każdego warunku latentny PCC dla surowych okien EEG kończących się w punktach czasowych 8, 16, ..., 80 w podmiocie sub-01 (n = 200 warunków testowych). Krzywe CLIP i VAE rosną wraz z rozszerzaniem okna analizy i osiągają plateau w późniejszych oknach. Linie przerywane wskazują odpowiadające im referencyjne wartości dla samego strumienia semantycznego w pełnym oknie. Analiza ta charakteryzuje zależność od okna czasowego w ramach opisanego protokołu mapowania.
Wyrównanie semantyczne i analiza na poziomie reprezentacji
Rysunek 7 porównuje wartości PCC dla latentnych reprezentacji CLIP dla poszczególnych próbek w odniesieniu do surowego punktu odniesienia (anchor) CLIP oraz zamrożonej fuzji predykcji CLIP w 200 warunkach testowych sub-01. Estymacje gęstości jądrowej Gaussa wykorzystują szerokość pasma według reguły Scotta, a pionowe linie przerywane wskazują średnie z próbek. Rozkład fuzji wykazuje średni wzrost PCC o około 0,013 w stosunku do surowego punktu odniesienia. Dokładność identyfikacji parzystej CLIP na poziomie obrazu raportowana jest oddzielnie w Tabela 2.
Rysunek 8 porównuje macierze podobieństwa reprezentacyjnego (RSM) oparte na podobieństwie cosinusowym dla osadzeń CLIP obrazów rzeczywistych oraz dla fuzji osadzeń CLIP przewidzianych na podstawie EEG. Obie macierze mają wspólny zakres danych i porządkowanie metodą Warda wyprowadzone z odległości euklidesowych między rzeczywistymi osadzeniami CLIP. Panel reszt przedstawia różnicę między przewidzianą macierzą RSM a macierzą RSM rzeczywistą w symetrycznej skali zdefiniowanej przez maksymalną wartość bezwzględną reszty, co umożliwia wizualizację zgodności reprezentacji.
Rycina uzupełniająca 2 przedstawia wspólną projekcję 200 osadzeń CLIP będących wartościami rzeczywistymi (ground-truth) oraz 200 osadzeń przewidzianych na podstawie EEG. Pięć etykiet uzyskano poprzez klasteryzację k-średnich znormalizowanych w normie L2 osadzeń rzeczywistych (n_init = 50; seed = 7). Połączone cechy rzeczywiste i przewidziane zostały zredukowane do 50 wymiarów za pomocą PCA, a następnie wspólnie rzutowane metodą t-SNE z perpleksyjnością 28, odległością euklidesową i seed = 12. Projekcja ta zapewnia jakościowy wgląd w organizację dwóch zestawów reprezentacji.
Wzorce EEG i interpretowalność uwagi przestrzennej
Rycina uzupełniająca 3 grupuje testowane pojęcia na Zwierzęta, pojęcia związane z żywnością/roślinami oraz Inne obiekty, stosując jawne mapowanie etykiet pojęć. W obrębie każdej grupy wiersze są uporządkowane według klastrowania metodą Warda wybielonych osadzeń CLIP (ground-truth) i próbkowane jednostajnie do maksymalnie 30 pojęć w celu zapewnienia czytelności. Mapa cieplna przedstawia przycięte, znormalizowane wybielone amplitudy EEG w skali od -1 do 1; osadzenia CLIP służą wyłącznie do ustalenia kolejności wewnątrz grup.
Rysunek uzupełniający 4 przedstawia standardową topografię skalpu 10–20 zunormalizowanych bezwzględnych wag kanałów strumienia semantycznego dla wybranych 17 elektrod. Mapa podsumowuje względne ważenie modelu w pomiarowych kanałach skalpu i jest interpretowana jako wizualizacja wag modelu na poziomie kanału.
Niniejsza praca stanowi wtórną analizę obliczeniową zanonimizowanego zbioru danych THINGS-EEG2. Oryginalne zapisy EEG, wstępnie przetworzone macierze EEG, metadane i obrazy bodźców oraz pliki stanu spoczynkowego są dostępne za pośrednictwem projektu THINGS-EEG2 pod adresem https://osf.io/3jk45/ oraz w serwisie Figshare+ (https://doi.org/10.25452/figshare.plus.18470912). Oryginalne oprogramowanie do akwizycji i wstępnego przetwarzania danych jest dostępne pod adresem https://github.com/gifale95/eeg_encoding. Dostęp do danych EEG i obrazów bodźców oraz ich ponowne wykorzystanie regulują licencje i wymogi dotyczące przypisania autorstwa określone przez repozytoria źródłowe.
Implementacja TDE-Net, zawierająca skrypty do wyrównania, fuzji, rekonstrukcji, ewaluacji i wizualizacji, jest dostępna pod adresem https://github.com/Yuan-ui198/TDE-Net. Wersja odpowiadająca niniejszemu manuskryptowi została ustalona na commit c99325d7f9e090ddd7cd5816aeabda7a9b9364da (https://github.com/Yuan-ui198/TDE-Net/tree/c99325d7f9e090ddd7cd5816aeabda7a9b9364da). Na potrzeby niniejszego badania nie gromadzono nowych danych umożliwiających identyfikację uczestników.
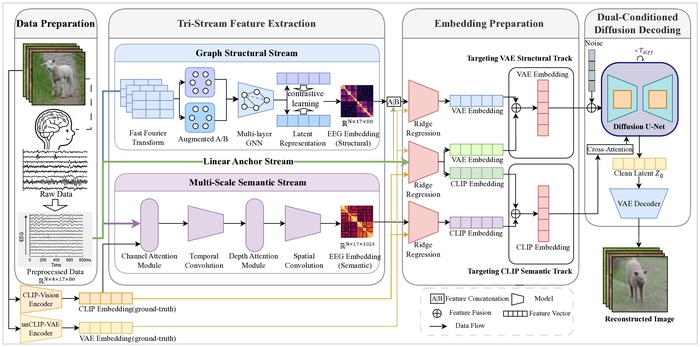
Rycina 1: Schemat TDE-Net. Diagram przedstawia surowy kotwiczący sygnał EEG, strumień grafów funkcjonalnych specyficznych dla próbki, strumień temporalny semantyczny, mapowanie w podwójnej przestrzeni do VAE i CLIP, fuzję ważoną oraz dekodowanie Stable UnCLIP z podwójnym warunkowaniem. Wymiary tensorów są zaznaczone tam, gdzie jest to właściwe. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
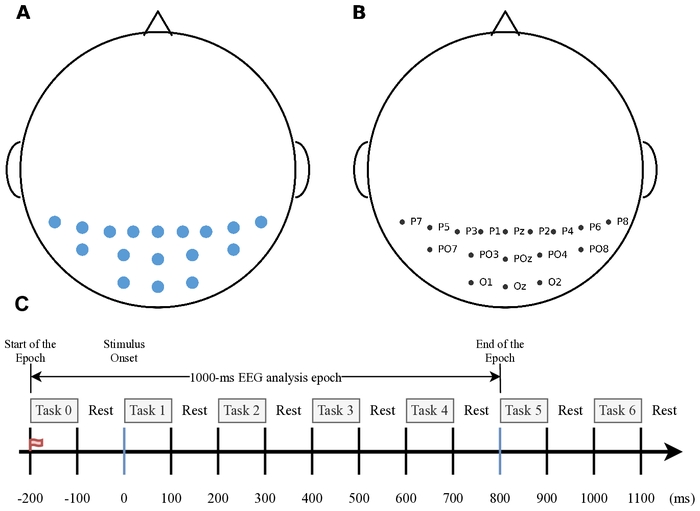
Rycina 2: Wybór elektrod EEG i harmonogram eksperymentu. (A) Rozkład przestrzenny wybranych 17 elektrod ciemieniowo-potylicznych z oryginalnego zapisu 64-kanałowego. (B) Oznaczenia elektrod: Pz, P3, P7, O1, Oz, O2, P4, P8, P1, P5, PO7, PO3, POz, PO4, PO8, P6 oraz P2. (C) Schemat czasu trwania RSVP i definicja epoki EEG. Na schemacie „Task” oznacza przedział prezentacji obrazu, natomiast „Rest” oznacza przedział między obrazami; ponumerowane bloki Task wskazują kolejne przedziały prezentacji, a nie różne warunki eksperymentalne. Każdy obraz był prezentowany przez 100 ms z asynchronią początku bodźca wynoszącą 200 ms. Epoka EEG obejmowała zakres od -200 do 800 ms względem początku bodźca, co odpowiada 1000-ms epokowi analizy EEG. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
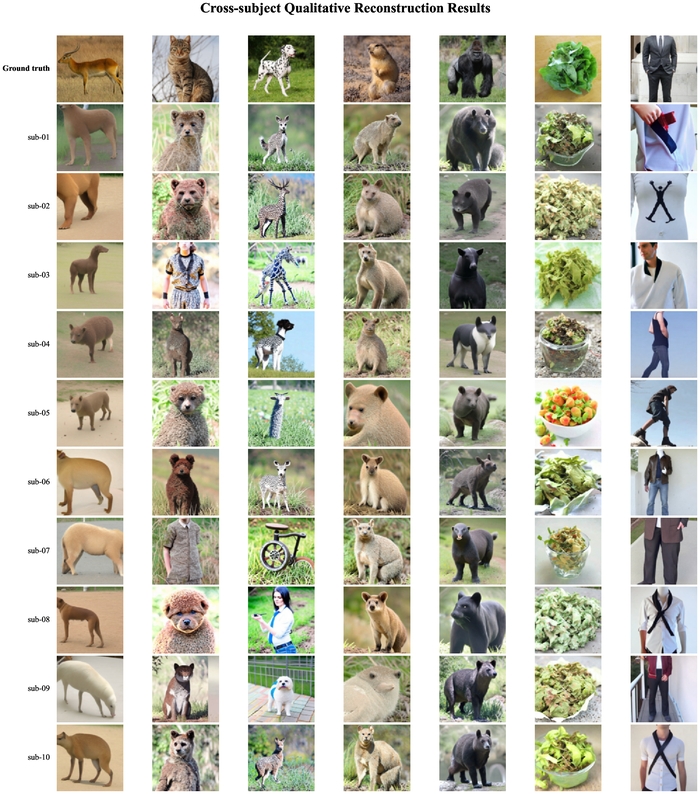
Rycina 3: Międzyosobnicze jakościowe wyniki rekonstrukcji dla siedmiu wykluczonych warunków obrazu. Te same indeksy warunków oparte na zerowej numeracji (1, 32, 62, 86, 87, 108 i 175) zostały zastosowane dla osób od sub-01 do sub-10. Górny rząd przedstawia odpowiadające im próbki obrazów referencyjnych (ground-truth) ze zbioru testowego THINGS-EEG2, których obrazy pochodzą z bazy obrazów THINGS34, natomiast pozostałe rzędy przedstawiają rekonstrukcje TDE-Net dla każdego badanego. Rycina ilustruje wspólną treść semantyczną oraz zmienność na poziomie osobniczym; ilościowe wyniki międzyosobnicze przedstawiono w Tabeli 3. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
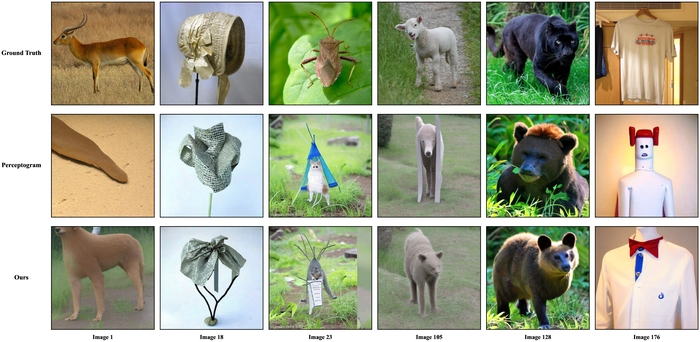
Rysunek 4: Porównanie jakościowej rekonstrukcji dla sześciu określonych warunków testowych sub-01. Wiersze przedstawiają bodziec prawdziwy (ground-truth), rekonstrukcję porównawczą wygenerowaną przez lokalną implementację oraz rekonstrukcję TDE-Net; kolumny odpowiadają poszczególnym indeksom warunków. Próbki obrazów prawdziwych zostały pobrane z bazy danych obrazów THINGS34. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
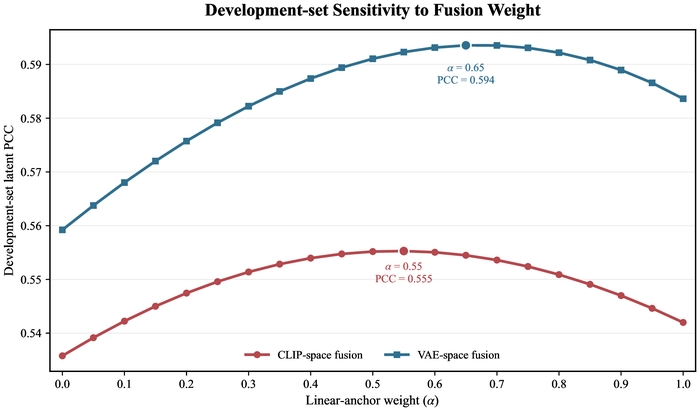
Rycina 5: Czułość wag fuzji latentnej w zbiorze rozwojowym. Oś pozioma oznacza wagę kotwicy liniowej α, waga strumienia komplementarnego wynosi 1 - α, a oś pionowa oznacza latentny współczynnik PCC w zbiorze rozwojowym. Wartości kandydackie mieszczą się w zakresie od 0,00 do 1,00 z krokiem 0,05. Wagi dla przestrzeni CLIP i VAE są wybierane niezależnie na podstawie maksymalnej, równoważnie ważonej średniej PCC na poziomie badanego dla 10 osób, co daje wartości αCLIP = 0,55 i αVAE = 0,65. PCC, współczynnik korelacji Pearsona. Kliknij tutaj, aby wyświetlić większą wersję tej ryciny.
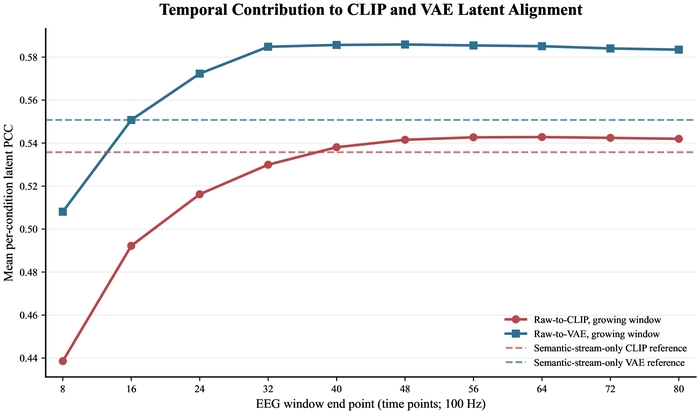
Rysunek 6: Analiza okna czasowego utajonego dopasowania w sub-01 (n = 200 warunków wykluczonych). Linie ciągłe przedstawiają średni PCC dla próbek w predykcjach ridge dla relacji raw-to-CLIP oraz raw-to-VAE, gdy koniec okna EEG rozszerza się od 8 do 80 punktów czasowych przy 100 Hz. Linie przerywane wskazują wartości referencyjne dla CLIP i VAE wyłącznie dla strumienia semantycznego przy pełnym oknie. PCC, współczynnik korelacji Pearsona. Aby zobaczyć powiększoną wersję tego rysunku, kliknij tutaj.
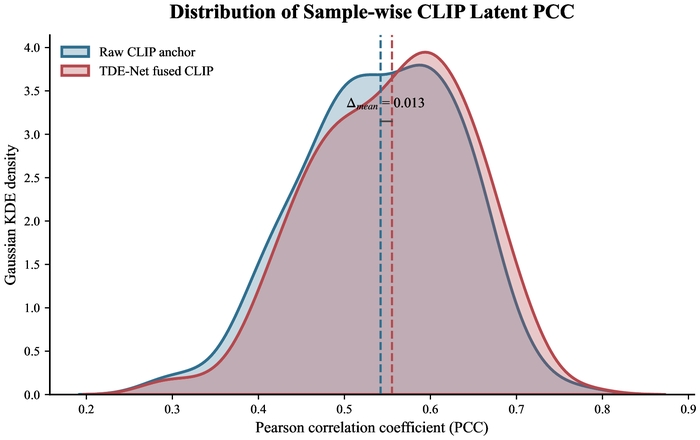
Rycina 7: Rozkład wyrównania latentnego CLIP dla poszczególnych próbek w podzbiorze sub-01 (n = 200 warunków wyłączonych z treningu). Krzywe przedstawiają gęstość jądrową Gaussa z szerokością pasma według reguły Scotta dla surowego punktu zakotwiczenia CLIP oraz dla predykcji CLIP zintegrowanej z zamrożoną siecią TDE-Net-fused. Pionowe przerywane linie oznaczają średnie z próbek, a adnotacja wskazuje różnicę między nimi. PCC, współczynnik korelacji Pearsona; KDE, estymacja gęstości jądrowej. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
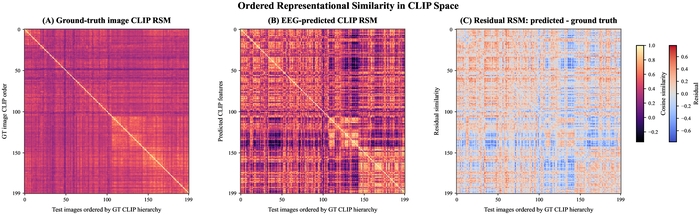
Rysunek 8: Uporządkowane podobieństwo reprezentacyjne w przestrzeni CLIP dla sub-01 (n = 200 warunków testowych). (A) RSM podobieństwa cosinusowego dla znormalizowanych L2 osadzeń (embeddings) obrazów referencyjnych w modelu CLIP. (B) RSM podobieństwa cosinusowego dla zintegrowanych osadzeń CLIP przewidzianych na podstawie EEG, przedstawione z tym samym uporządkowaniem i skalą kolorów co na panelu A. (C) RSM rezydualne, obliczone jako różnica między wartościami przewidzianymi a referencyjnymi, przedstawione w skali symetrycznej zdefiniowanej przez maksymalną wartość bezwzględną rezyduum. Uporządkowanie uzyskano za pomocą odległości euklidesowej i metody Ward dla osadzeń CLIP obrazów referencyjnych. RSM, macierz podobieństwa reprezentacyjnego (representational similarity matrix). Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
| Komponent | Parametr | Ustawienia |
| Dane i wstępne przetwarzanie | Podział zbioru danych | 16 540 warunków treningowych i 200 wydzielonych warunków testowych; podział na dopasowanie i rozwój w stosunku 90%/10% (ziarno 42) |
| sygnał EEG wejściowy | 17 kanałów ciemieniowo-potylicznych; 0-800 ms; 100 Hz; 80 punktów czasowych | |
| Reprezentacja spektralna | 80-punktowa FFT; 40 koszyków częstotliwości dodatnich; logarytmiczne widmo amplitudy w zakresie 0-50 Hz | |
| Strumień strukturalny | Konstrukcja grafu | Absolutna korelacja Pearsona specyficzna dla próbek; ważone top-k = 4 sąsiadów na węzeł; symetryzacja i pętle zwrotne |
| Architektura GCN | 5 warstw; 80 jednostek ukrytych; ReLU; dropout 0,3; symetryczna normalizacja stopnia; pooling średniej | |
| Cel kontrastowy | 80-wymiarowa głowica projekcyjna; temperatura InfoNCE τ = 0.5 | |
| Szkolenie | Adam; szybkość uczenia 5 × 10⁻⁴; wielkość partii 32; 20 epok; wyżarzanie cosinusoidalne; minimalny współczynnik uczenia 10⁻⁶; ziarno 42 | |
| Strumień semantyczny | Architektura | Jądra czasowe 5/15/31; głębokość 9; 24 kanały cech; dropout 0,5; wymiar wyjściowy 1024 |
| Szkolenie | AdamW; szybkość uczenia 5 × 10⁻⁴; zanik wag 0,01; wielkość partii 64; 50 epok; wyżarzanie cosinusoidalne; minimalna szybkość uczenia 10⁻⁶; ziarno 42 | |
| Mapowanie latentne | Regresja grzbietowa | Wyznaczoną wartość odcinka przecięcia z osią rzędnych; maksymalna liczba iteracji 50 000; dane wejściowe standaryzowane przy użyciu statystyk partycji dopasowania |
| Regularyzacja | kara CLIP λ = 1 000; surowa kara VAE λ = 0; kara strukturalnego VAE λ = 1,000 | |
| Wymiary celu | CLIP: 1 024; VAE: 36 864 | |
| Fuzja i dekodowanie | Wagi fuzji | waga kotwicy CLIP α = 0,55; waga kotwicy VAE α = 0,65; wybrano na podstawie danych rozwojowych i ustalono przed testowaniem |
| Model dyfuzyjny | sd2-community/stable-diffusion-2-1-unclip; skala strukturalna γ = 0,02; kroki czasowe dyfuzji T = 1 000 | |
| Pobieranie próbek | 20 kroków odszumiania; skala guidance 7,5; ziarno dyfuzji 0 |
Tabela 1: Zbiorcze podsumowanie parametrów dla TDE-Net. Tabela zawiera informacje o podziale danych, wstępnym przetwarzaniu, konstrukcji sąsiedztwa funkcjonalnego, ustawieniach koderów grafu i semantyki, karach mapowania ukrytego, wagach fuzji oraz ustawieniach dekodowania dyfuzyjnego wykorzystanych we wszystkich opisanych eksperymentach.
| Metoda | PixCorr | SSIM (wskaźnik podobieństwa strukturalnego) | AlexNet(2) | AlexNet(5) | Incepcja | CLIP | EffNet | SwAV |
| Poziom wyjściowy | 0.141 | 0.321 | 0.823 | 0.878 | 0.704 | 0.739 | 0.898 | 0.564 |
| DekodowanieObrazuEEG | - | 0.345 | 0.776 | 0.866 | 0.734 | 0.786 | - | 0.582 |
| Perceptogram (unCLIP) | 0.223 | 0.370 | 0.875 | 0.915 | 0.749 | 0.806 | 0.870 | 0.530 |
| TDE-Net (nasz model) | 0.253 ± 0.014 | 0.339 ± 0.003 | 0.878 ± 0.012 | 0.915 ± 0.012 | 0.761 ± 0.021 | 0.814 ± 0.007 | 0.829 ± 0.012 | 0.509 ± 0.010 |
Tabela 2: Wyniki rekonstrukcji ilościowej. Metody porównawcze — wewnętrzna konwolucyjna baza z mechanizmem uwagi (Baseline) oraz TDE-Net — zostały ocenione w ramach wspólnego schematu eksperymentalnego przy użyciu tego samego podziału THINGS-EEG2, 17-kanałowego wejścia, tych samych procedur preprocessingu, odseparowanych warunków testowych i definicji metryk, przy jednoczesnym zachowaniu specyficznych dla każdej metody architektur. Obecny model jest przedstawiony jako średnia ± SD dla 10 badanych. PixCorr, SSIM, AlexNet Layer 2, AlexNet Layer 5, Inception-v3 oraz CLIP są miarami, w których wyższa wartość oznacza lepszy wynik; EffNet i SwAV to odległości korelacyjne, dla których niższa wartość jest lepsza. Kolumna CLIP raportuje dokładność identyfikacji parzystej z wykorzystaniem modelu OpenAI CLIP ViT-L/14.
| Obiekt | PixCorr | SSIM | AlexNet L2 | AlexNet L5 | Inception | CLIP | EffNet | SwAV |
| sub-01 | 0.2260 | 0.3361 | 0.8831 | 0.9203 | 0.7533 | 0.8120 | 0.8567 | 0.5285 |
| sub-02 | 0.2488 | 0.3378 | 0.8699 | 0.9053 | 0.7268 | 0.8074 | 0.8335 | 0.5167 |
| sub-03 | 0.2564 | 0.3397 | 0.8728 | 0.9070 | 0.7658 | 0.8143 | 0.8268 | 0.5096 |
| sub-04 | 0.2420 | 0.3356 | 0.8598 | 0.9034 | 0.7854 | 0.8112 | 0.8255 | 0.5091 |
| sub-05 | 0.2499 | 0.3385 | 0.8760 | 0.8963 | 0.7251 | 0.8016 | 0.8394 | 0.5189 |
| sub-06 | 0.2621 | 0.3395 | 0.8910 | 0.9331 | 0.7818 | 0.8215 | 0.8202 | 0.5009 |
| sub-07 | 0.2489 | 0.3378 | 0.8643 | 0.9185 | 0.7704 | 0.8200 | 0.8222 | 0.5017 |
| sub-08 | 0.2786 | 0.3425 | 0.8951 | 0.9216 | 0.7524 | 0.8245 | 0.8214 | 0.5010 |
| sub-09 | 0.2609 | 0.3370 | 0.8775 | 0.9238 | 0.7662 | 0.8055 | 0.8250 | 0.5009 |
| sub-10 | 0.2571 | 0.3433 | 0.8871 | 0.9240 | 0.7792 | 0.8175 | 0.8140 | 0.4977 |
| Średnia | 0.2531 | 0.3388 | 0.8777 | 0.9153 | 0.7606 | 0.8135 | 0.8285 | 0.5085 |
| Średnia ± SD | 0.2531 ± 0.0138 | 0.3388 ± 0.0025 | 0.8777 ± 0.0115 | 0.9153 ± 0.0116 | 0.7606 ± 0.0213 | 0.8135 ± 0.0074 | 0.8285 ± 0.0122 | 0.5085 ± 0.0101 |
| 95% CI | 0.2432-0.2630 | 0.3370-0.3406 | 0.8695-0.8859 | 0.9070-0.9236 | 0.7454-0.7759 | 0.8082-0.8189 | 0.8198-0.8372 | 0.5013-0.5157 |
Tabela 3: Ilościowe wyniki międzyosobnicze dla TDE-Net. Każdy uczestnik dostarcza 200 wydzielonych warunków testowych. Tabela przedstawia osiem metryk dla uczestników od sub-01 do sub-10, a następnie średnią międzyosobniczą, odchylenie standardowe próbki (SD) oraz 95% przedział ufności (CI). CLIP oznacza dokładność identyfikacji parowej OpenAI CLIP ViT-L/14; EffNet i SwAV to dystanse korelacji, w których niższe wartości są lepsze.
| Metoda | PixCorr | SSIM (wskaźnik podobieństwa strukturalnego) | AlexNet(2) | AlexNet(5) | Inicjacja | CLIP | EffNet | SwAV |
| Kotwica liniowa | 0.2157 | 0.3309 | 0.8891 | 0.9128 | 0.7493 | 0.7967 | 0.8683 | 0.5394 |
| Linear + Struct-Stream | 0.2318 | 0.3393 | 0.8861 | 0.9319 | 0.7439 | 0.7996 | 0.8657 | 0.5359 |
| Liniowy + Sem-Stream | 0.2372 | 0.3382 | 0.8879 | 0.9228 | 0.7447 | 0.8026 | 0.8655 | 0.5307 |
| TDE-Net (nasz model) | 0.2531 | 0.3388 | 0.8777 | 0.9153 | 0.7607 | 0.8135 | 0.8285 | 0.5085 |
Tabela 4: Wyniki ablacji przedstawione jako średnie wartości dla wszystkich badanych w ramach procedury oceny opisanej w sekcji 6 protokołu. Linear Anchor jest lokalnie ocenianym wewnętrznym bezpośrednim punktem odniesienia dla mapowania grzbietów; konfiguracje strukturalna, semantyczna i kompletna wykorzystują te same indeksy warunków i definicje metryk. PixCorr, SSIM, AlexNet Layer 2, AlexNet Layer 5, Inception-v3 oraz CLIP to miary, w których wyższa wartość oznacza lepszy wynik; EffNet i SwAV to dystanse korelacji, w których niższa wartość oznacza lepszy wynik. Wartości podano z dokładnością do trzech miejsc po przecinku.
Rycina uzupełniająca 1: Reprezentatywne przypadki rekonstrukcji obejmujące zakres zgodności CLIP dla sub-01. 200 wyłączonych warunków zostało uszeregowanych według podobieństwa cosinusowego między połączonymi osadzeniami przewidzianymi przez EEG a osadzeniami CLIP stanowiącymi prawdę obiektywną; przedstawiono sześć najlepszych, sześć średnich i sześć najgorszych przypadków. Każda kolumna paruje próbkę obrazu prawdy obiektywnej ze zbioru testowego THINGS-EEG2 z jego rekonstrukcją TDE-Net. Obrazy prawdy obiektywnej zostały pobrane z bazy obrazów THINGS34. Kliknij tutaj, aby pobrać ten plik.
Rysunek uzupełniający 2: Wspólna wizualizacja reprezentacji CLIP rzeczywistych (ground-truth) i przewidzianych na podstawie EEG u badanego sub-01 (n = 200 warunków na reprezentację). (A) Rzeczywiste reprezentacje CLIP. (B) Reprezentacje CLIP przewidziane na podstawie EEG. Kolory oznaczają pięć klastrów k-średnich dopasowanych do znormalizowanych według normy L2 rzeczywistych osadzeń CLIP (k = 5, n_init = 50, seed = 7). Klastry są grupami opartymi na danych i nie odpowiadają zdefiniowanym wcześniej kategoriom semantycznym. Osadzenia rzeczywiste i przewidziane zostały złączone, zredukowane do 50 wymiarów za pomocą PCA, a następnie wspólnie rzutowane metodą t-SNE (perplexity = 28, learning rate = auto, metryka euklidesowa, seed = 12). PCA, analiza głównych składowych; t-SNE, stochastyczne osadzanie sąsiadów z rozkładem t. Kliknij tutaj, aby pobrać ten plik.
Rysunek uzupełniający 3: Wzorce EEG pogrupowane według ogólnych kategorii pojęć obrazowych dla badanego sub-01. Pojęcia zostały przypisane do kategorii: Zwierzęta, Pojęcia związane z żywnością/roślinami lub Inne obiekty. W obrębie każdej kategorii wiersze odpowiadają hierarchicznemu uporządkowaniu Warda dla wybielonych osadzeń CLIP (ground-truth), a dla przejrzystości pobrano jednorodnie maksymalnie 30 pojęć. Kolumny przedstawiają 17 kanałów EEG, z 80 punktami czasowymi na kanał. Skala kolorów (-1 do 1) reprezentuje przyciętą, znormalizowaną amplitudę wybielonego sygnału EEG. Kliknij tutaj, aby pobrać ten plik.
Rycina uzupełniająca 4: Topografia uwagi kanałów skalpu dla strumienia semantycznego. Kolory przedstawiają znormalizowane wartości względne wyuczonych parametrów wag kanałów dla wybranych 17 elektrod w standardowej projekcji skalpu 10–20; kropki i etykiety elektrod określają pozycje pomiarowe. Skala obejmuje zakres od 0 do 1 i podsumowuje wyuczone przez model względne ważenie kanałów. Kliknij tutaj, aby pobrać ten plik.
Dyskusja
Niniejsze badanie przedstawia modularny przepływ obliczeniowy, który rozdziela wstępne przetwarzanie EEG, uczenie reprezentacji strukturalnych i semantycznych, mapowanie latentne CLIP/VAE, fuzję oraz dekodowanie dyfuzyjne. Taka etapowa organizacja umożliwia oddzielne badanie wyników pośrednich od wygenerowanych obrazów i podąża za ogólniejszym postępem od kompaktowych enkoderów EEG do metod rekonstrukcji między modalnościami oraz opartych na dyfuzji6,11,12,13,14,15,16,,17,18,19,20,21,22. Analiza międzyosobnicza przedstawia wartości na poziomie pojedynczego badanego wraz ze średnią międzyosobniczą i odchyleniem standardowym próby (SD) dla ewaluacji na wydzielonej grupie dziesięciu osób. Wraz z krokową ablacją przedstawioną w Tabeli 4, analiza ta ilościowo określa efekty specyficzne dla strumienia oraz zmienność międzyosobniczą w ramach raportowanego rurociągu przetwarzania.
Kluczowe etapy i rozwiązywanie problemów
Najistotniejszymi kontrolami implementacyjnymi są izolacja partycji, spójna normalizacja, zachowanie indeksu warunków oraz oddzielne mapowania CLIP/VAE. Wagi fuzji muszą zostać wybrane na podstawie warunków rozwojowych i zamrożone przed rekonstrukcją testową. W przypadku nieoczekiwanie niskiej wydajności należy w pierwszej kolejności zweryfikować kolejność i wymiary tablic, a następnie sprawdzić surowe i specyficzne dla gałęzi PCC latentne, metadane fuzji oraz wyniki metryk na poziomie obrazu. Błąd wyrównania latentnego wskazuje na problem z mapowaniem w górnym strumieniu, natomiast zmienne obrazy przy stabilnych latentach mogą odzwierciedlać zachowanie stochastyczne lub zależne od dekodera14,21,22,29.
Zmiana montażu elektrod, częstotliwości próbkowania lub okna czasowego wymaga odpowiednich zmian w konstrukcji wykresów, cechach widmowych i jądrach czasowych. Jakość rekonstrukcji powinna być oceniana za pomocą komplementarnych miar niskopoziomowych i semantycznych, ponieważ żaden pojedynczy wskaźnik nie oddaje w pełni wierności pikseli, struktury oraz zgodności na poziomie obiektów6,11,21,22,23. Miara CLIP zastosowana w niniejszej pracy to dokładność identyfikacji parowej, podczas gdy Rysunek 7 oraz Rysunek 8 wykorzystują PCC na poziomie ukrytym; wielkości te nie są zamienne.
Modułowa organizacja TDE-Net zapewnia ramy do badania, czy komplementarne reprezentacje EEG w różny sposób przyczyniają się do aspektów strukturalnych i semantycznych rekonstrukcji wizualnej. Podejście to może ułatwić systematyczne porównanie reprezentacji cech EEG, celów latentnych i dekoderów generatywnych bez polegania wyłącznie na końcowych zrekonstruowanych obrazach. Alternatywne podejścia obejmują bezpośrednie liniowe mapowanie EEG na przestrzeń latentną, jednoprzepływowe koder splotowe lub oparte na mechanizmach uwagi, reprezentacje grafowe oraz kompleksowe (end-to-end) frameworki neuronowego dekodowania6,7,8,9,10,11,17,18,19,20,21,22. Przedstawiony przepływ pracy może być szczególnie użyteczny w badaniach nad dekodowaniem percepcji wzrokowej, analizą reprezentacji neuronalnych oraz nieinwazyjnymi interfejsami mózg-komputer, gdzie oddzielenie pośrednich predykcji EEG na przestrzeń latentną może pomóc w określeniu, które komponenty wpływają na skuteczność rekonstrukcji.
Ograniczenia
Główne ograniczenia to stała akwizycja RSVP w THINGS-EEG2, wybrane 17 kanałów ciemieniowo-potylicznych, mapowania specyficzne dla badanych, pojedynczy dekoder dyfuzyjny oraz jakościowe analizy interpretowalności21,22,23. Podsumowanie z 10 badanych uwzględnia zmienność międzyosobniczą w obrębie zbioru danych, ale nie potwierdza transferu między zbiorami danych lub między paradygmatami. Wygenerowane obrazy mogą zawierać prawdopodobne szczegóły, które nie wynikają z sygnału EEG, a widoki RSM, t-SNE, wzorców EEG oraz uwagi nie ustanawiają przyczynowych mechanizmów neuronalnych. Stopniowa ablacja charakteryzuje wkład strumienia strukturalnego, strumienia semantycznego i fuzji w podwójnej przestrzeni przy wspólnym zakotwiczeniu w surowym EEG, celach latentnych, dekoderze dyfuzyjnym oraz protokole ewaluacji.
Kierunki przyszłych badań
W ramach tych ograniczeń uzyskane wyniki wspierają ocenę komplementarnych reprezentacji EEG w oddzielnych przestrzeniach semantycznych i ukrytych obrazów przed dekodowaniem dyfuzyjnym. Przyszłe prace powinny objąć testy na niezależnych zbiorach danych, adaptację do badanego, szacowanie niepewności, alternatywne układy elektrod oraz dekodery z silniejszą kontrolą nad niepotwierdzonymi szczegółami wizualnymi14,15,16,17,18,19,20,21,22,23. Takie badania są niezbędne przed rozszerzeniem obecnych ustaleń na szersze zastosowania w neuronauce lub w obszarze interfejsów mózg-komputer.
Wnioski:
TDE-Net łączy surowy sygnał EEG pełniący rolę kotwicy z reprezentacjami strukturalnymi i semantycznymi EEG, dopasowuje je oddzielnie do przestrzeni latentnych VAE oraz CLIP, a następnie integruje wynikowe predykcje przed dekodowaniem dyfuzyjnym. U 10 uczestników zbioru THINGS-EEG2 zrekonstruowane obrazy zachowały mierzalną zgodność na poziomie pikseli, struktur oraz semantyki z wyświetlanymi bodźcami, podczas gdy stopniowa ablacja pozwoliła rozróżnić efekty strumienia strukturalnego, strumienia semantycznego oraz fuzji dwuprzestrzennej. Poprzez udostępnienie pośrednich cech EEG, predykcji latentnych, wyników fuzji oraz końcowych rekonstrukcji, protokół ten dostarcza odtwarzalnych ram do badania wizualnej rekonstrukcji opartej na EEG oraz oceny możliwości jej przyszłego rozszerzenia na niezależne zbiory danych i różne warunki akwizycji.
Oświadczenia
Autorzy oświadczają, że nie istnieją żadne konkurencyjne interesy finansowe ani relacje osobiste, które mogłyby wpłynąć na niniejszą pracę. Autorzy oświadczają, że w przygotowaniu manuskryptu, kodu, analizy danych ani rycin nie wykorzystano narzędzi generatywnej sztucznej inteligencji.
Podziękowania
Badania te były finansowane przez National Natural Science Foundation of China w ramach (Grant No. 62433002) oraz (Grant No. 62476014), National Science and Technology Major Project (No. 2021ZD0113703), Beijing Municipal Social Science Foundation Annual Planning Project (No. 23GLB014), Project of Construction and Support for High-level Innovative Teams of Beijing Municipal Institutions w ramach (Grant No. BPHR20220104) oraz Beijing Scholars Program w ramach (Grant No. 099).
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Accelerate | Hugging Face | 0.30.1 | Zarządzanie urządzeniami potoku dyfuzyjnego; https://github.com/huggingface/accelerate |
| CLIP ViT-L/14 | OpenAI | ViT-L/14; openai-clip 1.0.1 | Koder cech obrazu używany do celów semantycznych i parowej identyfikacji CLIP; https://github.com/openai/CLIP |
| Diffusers | Hugging Face | 0.32.2 | Implementacja potoku Stable UnCLIP; https://github.com/huggingface/diffusers |
| Matplotlib | Matplotlib Development Team | 3.10.6 | Generowanie rysunków naukowych; https://matplotlib.org/ |
| MNE-Python | MNE Developers | 1.11.0 | Standardowy montaż 10-20 i topografia kanałów skalpu; https://mne.tools/ |
| NumPy | NumPy Developers | 2.3.4 | Tablice EEG, osadzenia latentne, fuzja i agregacja metryk; https://numpy.org/ |
| NVIDIA GeForce RTX 4070 Laptop GPU | NVIDIA | 8 GB; driver 595.97 | GPU użyte do lokalnego trenowania kodera i rekonstrukcji dyfuzyjnej. |
| Pillow | Python Imaging Library Fork | 11.1.0 | Ładowanie, zmiana rozmiaru i eksport obrazów; https://python-pillow.org/ |
| Python | Python Software Foundation | 3.12.12 | Główne środowisko wykonawcze; https://www.python.org/ |
| PyTorch | PyTorch Foundation | 2.9.1+cu128 | Trenowanie kodera EEG i inferencja sieci neuronowych; https://pytorch.org/ |
| scikit-image | scikit-image Developers | 0.25.2 | Narzędzia SSIM i przetwarzania obrazów; https://scikit-image.org/ |
| scikit-learn | scikit-learn Developers | 1.7.2 | Regresja grzbietowa, k-średnich, PCA i t-SNE; https://scikit-learn.org/ |
| SciPy | SciPy Developers | 1.16.3 | Korelacja, dystans statystyczny i klasteryzacja hierarchiczna; https://scipy.org/ |
| Seaborn | Seaborn Developers | 0.13.2 | Wizualizacja gęstości jądra Gaussa; https://seaborn.pydata.org/ |
| Koder EEG strumienia semantycznego | Autorzy TDE-Net; zaadaptowany z LMDA-Net | Repository commit c99325d | Wieloskalowa czasowa reprezentacja semantyczna; implementacja i metadane punktów kontrolnych są dostępne w repozytorium kodu. |
| Stable Diffusion 2.1 UnCLIP | Stability AI / SD2 Community | sd2-community/stable-diffusion-2-1-unclip | Zamrożony dekoder dyfuzyjny; https://huggingface.co/sd2-community/stable-diffusion-2-1-unclip |
| Koder EEG strumienia strukturalnego | Autorzy TDE-Net | Repository commit c99325d | Samo-nadzorowana reprezentacja grafowa; surowe dane EEG i cechy grafu są łączone tylko w przypadku strukturalnego mapowania przestrzeni VAE. |
| Skrypty wyrównania, fuzji, ewaluacji i wizualizacji TDE-Net | Yuan-ui198 | commit c99325d7f9e090ddd7cd581 6aeabda7a9b9364da | https://github.com/Yuan-ui198/TDE-Net/tree/c99325d7f9e0 90ddd7cd5816aeabda7a9b9364da |
| Baza danych THINGS | Hebart et al. | doi:10.1371/journal.pone.0223792 | Źródło naturalistycznych bodźców obiektowych; https://things-initiative.org/ |
| Zbiór danych THINGS-EEG2 | Gifford et al. | doi:10.1016/j.neuroimage.2022.119754 | 64-kanałowe EEG od 10 osób; w tej pracy wybrano 17 kanałów ciemieniowo-potylicznych; https://osf.io/anp5v/ |
| timm | Ross Wightman i współautorzy | 1.0.22 | Narzędzia modeli wizyjnych z pretreningiem używane do ewaluacji cech; https://github.com/huggingface/pytorch-image-models |
| torchvision | PyTorch Foundation | 0.24.1+cu128 | Szkielety ewaluacyjne AlexNet, Inception-v3 i EfficientNet; https://pytorch.org/vision/ |
| tqdm | tqdm Developers | 4.67.1 | Raportowanie postępu ekstrakcji cech, rekonstrukcji i ewaluacji; https://tqdm.github.io/ |
| Transformers | Hugging Face | 4.37.2 | Interfejsy dla komponentów modeli z pretreningiem; https://github.com/huggingface/transformers |
Bibliografia
- Shen G, Horikawa T, Majima K, Kamitani Y. Deep image reconstruction from human brain activity. PLoS Comput Biol. 2019;15(1):e1006633. doi:10.1371/journal.pcbi.1006633.
- Chen Z, Qing J, Xiang T, Yue W, Zhou JH. Seeing beyond the brain: conditional diffusion model with sparse masked modeling for vision decoding. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2023. p. 22710-22720. Available from: https://openaccess.thecvf.com/content/CVPR2023/html/Chen_Seeing_Beyond_the_Brain_Conditional_Diffusion_Model_With
_Sparse_Masked_Modeling_CVPR_2023_paper.html - Takagi Y, Nishimoto S. High-resolution image reconstruction with latent diffusion models from human brain activity. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2023. p. 14453-14463. Available from: https://openaccess.thecvf.com/content/CVPR2023/html/Takagi_High-Resolution_Image_Reconstruction_With_Latent_Diffusion_Models_
From_Human_Brain_CVPR_2023_paper.html - Scotti PS et al. Reconstructing the mind's eye: fMRI-to-image with contrastive learning and diffusion priors. Adv Neural Inf Process Syst. 2023;36:24705-24728. doi:10.52202/075280-1073.
- Geman S, Bienenstock E, Doursat R. Neural networks and the bias/variance dilemma. Neural Comput. 1992;4(1):1-58. doi:10.1162/neco.1992.4.1.1.
- Lawhern VJ et al. EEGNet: a compact convolutional neural network for EEG-based brain-computer interfaces. J Neural Eng. 2018;15(5):056013. doi:10.1088/1741-2552/aace8c.
- Kostas D, Aroca-Ouellette S, Rudzicz F. BENDR: using transformers and a contrastive self-supervised learning task to learn from massive amounts of EEG data. Front Hum Neurosci. 2021;15:653659. doi:10.3389/fnhum.2021.653659.
- Song Y, Zheng Q, Liu B, Gao X. EEG Conformer: convolutional transformer for EEG decoding and visualization. IEEE Trans Neural Syst Rehabil Eng. 2023;31:710-719. doi:10.1109/TNSRE.2022.3230250.
- Cui CM et al. "Pre-Train, Prompt" framework to boost graph neural networks performance in EEG analysis. IEEE J Biomed Health Inform. 2025;29(7):4847-4860. doi:10.1109/JBHI.2025.3541058.
- Meng X, Qiu S, Wan S, Cheng K, Cui L. A motor imagery EEG signal classification algorithm based on recurrence plot convolution neural network. Pattern Recognit Lett. 2021;146:134-141. doi:10.1016/j.patrec.2021.03.023.
- Miao Z, Zhao M, Zhang X, Ming D. LMDA-Net: a lightweight multi-dimensional attention network for general EEG-based brain-computer interfaces. Neuroimage. 2023;276:120209. doi:10.1016/j.neuroimage.2023.120209.
- Zhang S, Tang C, Guan C. Visual-to-EEG cross-modal knowledge distillation for continuous emotion recognition. Pattern Recognit. 2022;130:108833. doi:10.1016/j.patcog.2022.108833.
- Palazzo S et al. Decoding brain representations by multimodal learning of neural activity and visual features. IEEE Trans Pattern Anal Mach Intell. 2021;43(11):3833-3849. doi:10.1109/TPAMI.2020.2995909.
- Rombach R, Blattmann A, Lorenz D, Esser P, Ommer B. High-resolution image synthesis with latent diffusion models. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2022. p. 10684-10695. Available from: https://openaccess.thecvf.com/content/CVPR2022/html/Rombach_High-Resolution_Image_Synthesis_With_Latent_Diffusion_Models_CVPR
_2022_paper.html - Radford A et al. Learning transferable visual models from natural language supervision. In: Proceedings of the 38th International Conference on Machine Learning. PMLR. 2021;139:8748-8763. Available from: https://proceedings.mlr.press/v139/radford21a.html
- Bai Y et al. DreamDiffusion: high-quality EEG-to-image generation with temporal masked signal modeling and CLIP alignment. In: Computer Vision - ECCV 2024. Cham: Springer; 2024. p. 472-488. doi:10.1007/978-3-031-72751-1_27.
- Cao X, Gong P, Zhang L, Zhang D. EEG-CLIP: a transformer-based framework for EEG-guided image generation. Neural Netw. 2026;194:108167. doi:10.1016/j.neunet.2025.108167.
- Liu Y et al. FSDBN: foreground-aware EEG-visual alignment via dynamic brain networks. arXiv [Preprint]. 2026. Available from: https://arxiv.org/abs/2607.18344
- Yin F, Zheng C, Gong P, Guan D, Zhu Q. Neural visual decoding via cognitive-guided adaptive blurring and information-constrained alignment. arXiv [Preprint]. 2026. Available from: https://arxiv.org/abs/2605.16418
- Liu J, Gong P, Zheng C, Liu Y, Zhu Q. Multi-level bidirectional biomimetic learning for EEG-based visual decoding. arXiv [Preprint]. 2026. Available from: https://arxiv.org/abs/2605.04680
- Fei T et al. Perceptogram: reconstructing visual percepts and presumptive electrode preference from EEG. arXiv [Preprint]. 2024. Available from: https://arxiv.org/abs/2404.01250
- Li D, Wei C, Li S, Zou J, Liu Q. Visual decoding and reconstruction via EEG embeddings with guided diffusion. Adv Neural Inf Process Syst. 2024;37:102822-102864. doi:10.52202/079017-3266.
- Gifford AT, Dwivedi K, Roig G, Cichy RM. A large and rich EEG dataset for modeling human visual object recognition. Neuroimage. 2022;264:119754. doi:10.1016/j.neuroimage.2022.119754.
- Kipf TN, Welling M. Semi-supervised classification with graph convolutional networks. In: International Conference on Learning Representations. 2017. Available from: https://openreview.net/forum?id=SJU4ayYgl
- Chen T, Kornblith S, Norouzi M, Hinton G. A simple framework for contrastive learning of visual representations. In: Proceedings of the 37th International Conference on Machine Learning. PMLR. 2020;119:1597-1607. Available from: https://proceedings.mlr.press/v119/chen20j.html
- Ramoser H, Muller-Gerking J, Pfurtscheller G. Optimal spatial filtering of single trial EEG during imagined hand movement. IEEE Trans Rehabil Eng. 2000;8(4):441-446. doi:10.1109/86.895946.
- Bai S, Kolter JZ, Koltun V. An empirical evaluation of generic convolutional and recurrent networks for sequence modeling. arXiv [Preprint]. 2018. Available from: https://arxiv.org/abs/1803.01271
- Woo S, Park J, Lee JY, Kweon IS. CBAM: convolutional block attention module. In: European
Conference on Computer Vision. Cham: Springer; 2018. p. 3-19. Available from:
https://doi.org/10.1007/978-3-030-01234-2_1 - Hoerl AE, Kennard RW. Ridge regression: biased estimation for nonorthogonal problems. Technometrics. 1970;12(1):55-67. doi:10.1080/00401706.1970.10488634.
- Zhou ZH. Ensemble Methods: Foundations and Algorithms. Boca Raton: Chapman and Hall/CRC; 2012.
- Ho J, Jain A, Abbeel P. Denoising diffusion probabilistic models. Adv Neural Inf Process Syst. 2020;33:6840-6851. Available from: https://proceedings.neurips.cc/paper/2020/hash/4c5bcfec8584af0d967f1ab10179ca4b-Abstract.html
- Ho J, Salimans T. Classifier-free diffusion guidance. arXiv [Preprint]. 2022. Available from: https://arxiv.org/abs/2207.12598
- Kingma DP, Welling M. Auto-encoding variational Bayes. In: International Conference on Learning Representations. 2014. Available from: https://openreview.net/forum?id=33X9fd2-9FyZd
- Hebart MN et al. THINGS: a database of 1,854 object concepts and more than 26,000 naturalistic object images. PLoS One. 2019;14(10):e0223792. doi:10.1371/journal.pone.0223792.
Przedruki i uprawnienia
Ten artykuł został opublikowany
Film wkrótce dostępny