O ensaio genético repórter é uma ferramenta bem estabelecida e poderosa para dissecar a relação entre as sequências de DNA e suas atividades reguladoras de genes. O acoplamento de elementos reguladores candidatos a genes repórteres que carregam etiquetas de sequência de identificação permite a paralelização massiva desses ensaios.
Artigo de método
Ensaios Repórter Massively Parallel em células de mamíferos cultivadas
Neste artigo
Aviso de errata
Important: There has been an erratum issued for this article. View Erratum Notice
Resumo
Resumo
O ensaio genético repórter é uma ferramenta bem estabelecida e poderosa para dissecar a relação entre as sequências de DNA e suas atividades reguladoras de genes. O rendimento potencial deste ensaio foi, no entanto, limitado pela necessidade de clonar e testar individualmente a atividade de cada sequência de interesse usando fluorescência de proteína ou atividade enzimática como proxy para a atividade regulatória. Os avanços nas tecnologias de síntese e sequenciamento de DNA de alto rendimento tornaram recentemente possível superar essas limitações, multiplexando a construção e interrogação de grandes bibliotecas de construtos repórteres. Este protocolo descreve a implementação de um Massively Parallel Reporter Assay (MPRA) que permite a comparação direta de centenas de milhares de sequências regulatórias putativas em uma única placa de cultura de células.
Introdução
Ensaios Repórter Massively Parallel (MPRA) permitem a medição multiplexado das atividades de regulação transcricional de milhares a centenas de milhares de seqüências de DNA 1 a 7. Na sua aplicação mais comum, a multiplexação é obtida por acoplamento de cada sequência de interesse de um gene repórter sintético que contém uma marca de identificação de sequência a jusante de uma grelha de leitura aberta (ORF, Figura 1). Após a transfecção, o isolamento do RNA e profunda seqüenciamento de extremidades 3 'dos transcritos do gene repórter, as atividades relativas das sequências acopladas pode ser inferida a partir da abundância relativa de suas etiquetas de identificação.

Figura 1 Visão de MPRA. Uma biblioteca de MPRA repórter constrói é construído acoplando sequências regulatórias putativos para sintéticogenes repórter que são constituídas por uma "inerte" (ORF tais como GFP ou luciferase), seguido por uma sequência de marcação de identificação. A biblioteca é transfectado em massa para uma população de células cultivadas e o ARNm transcrito repórter é subsequentemente recuperado. Sequenciação profunda é utilizado para contar o número de ocorrências de cada etiqueta de entre os ARNm e os plasmídeos repórter transfectadas. A proporção de ARNm conta sobre contagens de plasmídeo pode ser usada para inferir a actividade da sequência reguladora correspondente. Adaptado com permissão de Melnikov, et al 2.
MPRA podem ser adaptadas a uma ampla variedade de modelos experimentais, incluindo 1) mutagénese global de elementos reguladores de genes individuais, 2) para digitalização através de novos elementos reguladores um locus de interesse, 3) para testar o efeito da variação genética natural em um conjunto de putativas promotores, intensificadores ou silenciadores, e 4) engenharia semi-racional de elementos reguladores sintéticos. LiAs variantes da sequência de braries pode ser gerado utilizando uma variedade de métodos, incluindo síntese de biblioteca de oligonucleótidos (OLS) em microarrays programáveis 2,3,6,7, montagem de oligonucleótidos degenerados, 1,4 ligadura combinatória 8 e fragmentação do ADN genómico 5.
Este protocolo descreve a construção de uma biblioteca de variantes do promotor utilizando MQO e os vectores e pMPRA1 pMPRAdonor1 (Addgene IDs de 49349 e 49352, respectivamente; http://www.addgene.org), a transfecção transiente desta biblioteca em células de mamífero de cultura e quantificação subsequente das atividades promotoras de profunda seqüenciamento de suas marcas associadas (Tag-Seq). Versões anteriores deste protocolo foram utilizados na pesquisa, publicada na Melnikov et al. Nature Biotechnology 30, 271-277 (2012) e em Kheradpour et al. Genome Research 23, 800-811 (2013).
Protocolo
1 Seqüência de Projeto e Síntese
- Comece MPRA com o desenho e síntese de sequências a ser testado para a actividade reguladora. Para compatibilidade com a série vector pMPRA, projetar cada seqüência usando o seguinte modelo: 5'-ACTGGCCGCTTCACTG- var -GGTACCTCTAGA- tag -AGATCGGAAGAGCGTCG-3 ', onde var denota a seqüência a ser analisada e tag denota uma ou mais marcas de identificação.
- As duas regiões variáveis (e var tag) são separados por um par de Kpnl (GGTACC) e XbaI (TCTAGA) locais de restrição para facilitar a ligação direccional de um fragmento do gene repórter entre eles. Além disso, dois locais distintos Sfil (GGCCNNNNNGGCC) será adicionado por PCR para permitir a ligação direccional no esqueleto pMPRA. As regiões variáveis não devem conter cópias adicionais de qualquer destes locais de restrição. Se necessário, uma ou mais destas enzimas de restrição pode ser substituído, Desde que as substituições 1) permitir que o corte eficaz perto das extremidades de moléculas de DNA, e 2) não cortar em outros lugares na sequência do vector. Veja a discussão para obter detalhes adicionais.
- Obter os iniciadores necessários listados na Tabela 1 a partir de um fornecedor comercial.
| MPRA_SfiI_F | GCTAAGGGCCTAACTGGCCGCTTCACTG |
| MPRA_SfiI_R | GTTTAAGGCCTCCGTGGCCGACGCTCTTC |
| TAGseq_P1 | AATGATACGGCGACCACCGAGATCTACACT CTTTCCCTACACGACGCTCTTCCGATCT |
| TAGseq_P2 | CAAGCAGAAGACGGCATACGAGAT [índice] GT GACTGGAGTTCAGACGTGTGCTCTTCCGATCTCGAGG |
Tabela 1 sequências de primer. [Índice] denota uma seqüência de índice 6-8 nt utilizado para seqüenciamento multiplexado. Obter pelo menos 8 primers TagSeq-P2 com diferentes índices. Todosdos iniciadores deve ser purificado por HPLC ou PAGE.
- Bibliotecas oligonucleotídicas podem ser obtidas a partir de um vendedor ou de núcleo instalação comercial, ou gerado usando um sintetizador de oligonucleótidos baseada microarray programável, tal como descrito pelo fabricante. Ressuspender os produtos OLS em 100 ul de tampão TE 0,1.
- Executar as bibliotecas de oligonucleótidos sobre um 10% de TBE-ureia desnaturante em gel de poliacrilamida. Coloque cerca de 1 pmol por pista e mancha com mancha fluorescente ssDNA-sensível para avaliar a sua qualidade (Figura 2A).
- Se uma banda discreta correspondente aos oligonucleótidos de comprimento completo pode ser visualizado (Figura 2A, pistas 1 e 2), excisar a fatia de gel correspondente a acrilamida e eluir oligonucleótidos em 100 ul de TE 0,1 durante a noite à temperatura ambiente com agitação. Caso contrário, continue usando o OLS suspensão de matéria.
- Amplificar e adicionar caudas Sfil para a biblioteca oligonucleotídeo utilizando emulsão PCR 9 sup>.
- Defina-se 50 ul de misturas de reacção de PCR como descrito na Tabela 2. Em seguida combinam-se com 300 ul mistura de óleo e agente tensioactivo da emulsão e ADN Micellula kit de purificação e de vórtice durante 5 min a 4 ° C.
| Reagente | 1x Volume (uL) |
| Herculase II Fusão ADN Polimerase | 0,5 |
| Tampão de reacção 5x Herculase II | 10 |
| de dNTP (10 mM cada) | 1,25 |
| BSA (20 mg / ml) | 1,25 |
| MPRA_SfiI_F Primer (25 uM) | 0,25 |
| MPRA_SfiI_R Primer (25 uM) | 0,25 |
| Modelo OLS (1-10 attomol) | varia |
| Água livre de nuclease | 50 |
- Utilizar a concentração que dá o máximo de rendimento de produtos de amplificação, sem o aparecimento de artefactos (ver secção 1.12).
- Dispensar a emulsão resultante em tubos de PCR e executar 20 ciclos de PCR (2 minutos a 95 ° C, 20 x [20 s a 95 ° C, 20 seg a 55 ° C, 30 segundos a 72 ° C], 3 min a 95 ° C).
- Piscina e romper cada emulsão de reacção de PCR de 350 ul por adição de 1 ml de isobutanol e brevemente vórtex e, em seguida, purificar o produto de amplificação, utilizando uma coluna de purificação de ADN.
- Executar uma aliquota sobre um gel de agarose a 2% ou 4% para verificar a amplificação livre de artefacto (Figura 2B).

Figura 2: Preparação de bibliotecas de síntese de oligonucleótidos. UM) Três bibliotecas síntese oligonucleotídeo matérias diferentes (MQO) executado em desnaturante 10% TBE-uréia géis de poliacrilamida. As bandas correspondentes a oligonucleótidos de comprimento total (*) pode ser visualizada e excisada a partir de bibliotecas de 1 e 2 Biblioteca 3 contém os contaminantes que interferem com a purificação PAGE. Se este for o caso, seguir diretamente para a amplificação de PCR. B) produtos de aberto e de emulsão de amplificação por PCR da mesma biblioteca de oligonucleótidos corrida num gel de agarose. Amplificação por PCR de bibliotecas de oligonucleotídeos complexas freqüentemente cria produtos quiméricos e outros artefatos que podem aparecer como bandas superiores e inferiores. Emulsão PCR pode minimizar esses artefatos.
2 Construção da Biblioteca
- Prepara-se uma estrutura do plasmideo linearizado por digestão com Sfil pMPRA1 vector a 50 ° C durante 2 horas, corrido num gel de agarose a 1%, excisão da banda de espinha dorsal (neste caso, de 2,5 kb) e purificá-lo através de uma coluna de gel de spin-purificação.
- Digestos produtos de PCR a partir de emulsão passo 1.4 com Sfil a 50 ° C durante 2 horas e purificar por meio de colunas de purificação de ADN.
- Para ligar a biblioteca de promotor-tag na estrutura do vector linearizado, configurar as reacções contendo 100 ng do produto de PCR digerido, 50 ng do esqueleto do vector linearizado e ADN-ligase de T4. Incubar durante a noite a 16 ° C e, em seguida, aquece-se a 65 ° C durante 20 minutos para inactivar a ligase.
- Transformar E. coli com a reacção de ligação. Para preservar a complexidade biblioteca, visam obter pelo menos 10x mais ufc do que há combinações distintas promotor-tag na biblioteca projetada.
- Quando o número total de marcadores é de aproximadamente 100.000, o ufc alvo pode normalmente ser conseguido através da realização de transformações paralelas 6-8 por biblioteca.
- Para cada transformação, combinar 50 ul electrocompetentes E. As células de E. coli com 2 ul de mistura de ligação em gelo. Transformar por electroporação, recuperar as células em 800 ul SOCpor meio de agitação a 37 ° C durante 1 hora, e, em seguida, combinam as células a partir das transformações paralelas.
- Para avaliar a eficiência da transformação, placa de diluições em série a partir de uma alinquot de células recuperadas em placas de LB-agar com 50-100 ug / ml de carbenicilina e incubar durante a noite a 37 ° C. Estimar ufc totais (CFU observada) x (factor de diluição) x (V - V) / V, em que V é o volume total de células recuperado e v é o volume da alíquota para as diluições em série.
- Ao mesmo tempo, utilizar o restante das células recuperadas para inocular 200 ml de LB suplementado com 100 ug / ml de carbenicilina. Crescer as células a 37 ° C durante a noite numa incubadora com agitador e, em seguida, isolar o ADN de plasmídeo de acordo com procedimentos normalizados.
- Digerir uma aliquota do plasmídeo da biblioteca isolado com Sfil a 50 ° C durante 2 horas e separado num gel de agarose a 1% para confirmar a presença dos insertos.
- Linearizar o plasmídeo da biblioteca por cutting entre as variantes do promotor e tags usando Kpnl e Xbal. Para maximizar a eficiência da digestão, realizar digestões de série:
- Primeiro, digerir com Kpnl a 37 ° C durante 1 hora e purificar usando esferas magnéticas. Em segundo lugar, digerir com Xbal com adição de 1 U de fosfatase alcalina de camarão a 37 ° C durante 2 horas, o calor inactiva a 65 ° C durante 5 min, e em seguida purificar usando esferas magnéticas.
- Executar uma aliquota sobre um gel de agarose a 1% para verificar a linearização completa. Se o plasmídeo não cortado é visível, o fragmento linearizado deve ser purificado em gel.
- Para gerar uma biblioteca MPRA adequado para transfecção em células de mamíferos, ligar uma ORF com KpnI / XbaI extremidades -compatível na biblioteca intermediário linearizado.
- Para preparar um fragmento ORF luc2 compatível de pMPRAdonor1, digerir este plasmídeo com Kpnl e Xbal a 37 ° C durante 1 hora e corrido num gel de agarose a 1%. Extirpar o fragmento ORF (1,7 kb neste caso) e purifica-se utilizando uma coluna de gel de purificação de centrifugação.
- Clonar o fragmento do ORF na biblioteca intermediário linearizado como descrito nos passos 2,3-2,8.
- Digerir uma aliquota (correspondendo a 1-2 ng) da biblioteca MPRA com Kpnl a 37 ° C durante 1 hora e corrido num gel de agarose a 1%. Se a biblioteca digerido é executado como uma única banda, avance para a secção 3 Se forem observadas bandas adicionais (correspondendo tipicamente a transição de construções intermédios), a biblioteca pode ser ainda purificado como se segue:
- Digerir 3-5 ug da biblioteca contaminado com Kpnl a 37 ° C durante 1 hora e corrido num gel de agarose a 0,8% durante a noite a 4 ° C.
- Excisar a banda correcta biblioteca, purificar o ADN utilizando uma coluna de purificação de gel de rotação e realizar a auto-ligação de alta concentração utilizando a ligase de ADN de T4 a 37 ° C durante 1 hora. Em seguida, repetir a transformação e isolamento final, biblioteca de ADN, tal como descrito na etapa 2.8.
3 Transfection, perturbação, e Isolamento de RNA
- Para cada transfecção independentes, o número necessário de cultura de células (tal como determinado pela complexidade da biblioteca MPRA, ver discussão) em meio apropriado. Por exemplo, a cultura de células HEK293T / 17 em meio DMEM suplementado com 10% de FBS e L-glutamina / penicilina / estreptomicina. Células de cultura durante pelo menos duas transfecções independentes para cada biblioteca e condição experimental.
- Transfectar as células cultivadas com plasmídeos MPRA. O método e as condições de transfecção deve ser optimizada para cada tipo de célula. Para cada uma das amostras transfectadas, reter-se uma alíquota (50-100 ng) de ADN de plasmídeo como controlo correspondente.
- Por exemplo, transfectar 0,5 x 10 7 HEK293T / 17 células cultivadas para ~ 50% de confluência numa placa de cultura de 10 centímetros, com 10 ug de plasmídeo de DNA em 1 ml de Opti-MEM I Reduced Serum Medium, utilizando 30 ul de Lipofectamina LTX e 10 ul de reagente Além disso. Retirar a mistura de transfecção após 5 horas e permitir que océlulas recuperar durante 24-48 hr.
- Opcionalmente, execute qualquer perturbação necessária para ativar seqüências regulatórias ao contexto ou dependentes de sinal na biblioteca projetada.
- Colher as células e isolar ARN poli (A) + ARNm utilizando colunas padrão de oligo (dT) celulose ou pérolas utilizando as instruções do fabricante.
- Assegure-se que a capacidade máxima de ligação das colunas ou grânulos exceder a quantidade total de ARNm esperado a partir das células colhidas. Por exemplo, o rendimento esperado da seção 3.3 é de cerca de 0,5-2,5 mg mRNA.
4. Tag-Seq
- Para eliminar o arraste de ADN do vector a partir dos lisados de células transfectadas, o tratamento de cada uma das amostras de mRNA de 20 ul com 1 ul Turbo ADNase (2 U) e 2,3 ul de tampão 10x turbo ADNase a 37 ° C durante 1 h, adicionar 2,4 mL de reagente de DNase Turbo Inactivação pelo RT durante 5 min, com agitação, de centrifugação a 10.000 g durante 90 segundos, e, em seguida, transferir a solução para um tubo fresco.
- Verifique pureza através da realização de PCR, como descrito na secção 4.6 em 60-100 ng de cada amostra de mRNA, e depois executar os produtos em gel de agarose. Se os fragmentos específicos são visíveis (0,25 kb se usando pMPRA1 com luc2), coluna de purificar o mRNA tratada e, em seguida, repetir o tratamento DNase.
- Para gerar bibliotecas de sequenciamento Tag-Seq, converter mRNA repórter de cDNA e adicione adaptadores de sequenciamento por PCR.
- Defina-se misturas de iniciadores de ARNm / IF, tal como descrito na Tabela 3. Incubar a 65 ° C durante 5 min, em seguida, colocar em gelo. Em paralelo, criar reacções de síntese de cDNA, como descrito na Tabela 4.
| Reagente | 1x Volume (uL) |
| amostra de ARNm (400-700 ng total) | 8 |
| Oligo-0DT (50 uM) | 1 |
| de dNTP (10 mM cada) | 1 |
| Reagente | 1x Volume (uL) |
| 10x SuperScript III RT buffer | 2 |
| MgCl2 (25 mM) | 4 |
| DTT (0,1 M) | 2 |
| RNaseOut (40 U / ul) | 1 |
| SuperScript III (200 U / ul) | 1 |
Tabela 4 Mistura de reacção de síntese de cDNA.
- Suavemente combinar ARNm / RT iniciador mistura com misturas de síntese de cDNA. Incubar a 50 ° C durante 50 min, 85 ° C durante 5 min e, em seguida, colocar em gelo. Finalmente, incubar com 2 U de ribonuclease H, a 37 ° C durante 20 min.
- Defina-se reacções de PCR como descrito na Tabela 5 com 4-6 ulmistura de reacção de cDNA ou 50 ng de plasmídeo repórter como modelos. Em seguida, realizar a amplificação por PCR (95 ° C durante 2 min, 26 x [95 ° C durante 30 seg, 55 ° C durante 30 seg, 72 ° C durante 30 seg], 72 ° C durante 3 min).
| Reagente | 1x Volume (uL) |
| 2x PfuUltra II HotStart PCR Master Mix | 25 |
| TagSeq_P1 Primer (25 uM) | 0,5 |
| TagSeq_P2 Primer (25 uM) | 0,5 |
| Molde (mRNA, cDNA ou a mistura de ADN de plasmídeo) | varia |
| Água livre de nuclease | 50 |
Tabela 5 mix reação Tag-Seq PCR.
- Executar os produtos de PCR através de um gel de agarose a 2%, faixas especiais de consumo correspondentes aos amplicons biblioteca de tags-Seq (0,25 kb se usandopMPRA1 com luc2) e purificar estas usando colunas de giro de purificação em gel.
- Pool, desnaturar e sequenciar os amplicons Tag-Seq purificadas diretamente com um instrumento seqüenciamento Illumina.
- Filtro de baixa qualidade lê, removendo tudo o que a) conter um ou mais posição com uma qualidade Phred pontuação inferior a 30 dentro da tag seqüenciado ou b) não corresponde exatamente a tag projetado. Conte o número de vezes que cada etiqueta restante aparece em cada biblioteca. Normalizar as contagens de tag de TPM (tags por milhão de etiquetas sequenciados) e, em seguida, calcular a relação de contagem de tag ARNm derivados sobre contagens tag derivado de plasmídeo para cada par de bibliotecas de sequenciação. Se várias marcas diferentes foram ligados a cada variante de sequência, use os seus rácios médios para análise a jusante.
Resultados
MPRA facilita alta resolução, dissecção quantitativa das relações de elementos reguladores da transcrição seqüência de atividades. Um experimento MPRA bem sucedido irá tipicamente produzir medições altamente reprodutíveis para a maioria das sequências na biblioteca transfectadas (Figura 3A). Se for observada uma fraca reprodutibilidade (Figura 3B), isto é indicativo de uma muito baixa concentração de mRNAs repórter nas amostras de RNA recuperado, devido ou a 1) reduzida actividade absoluta entre as sequências ensaiadas, ou 2) a baixa eficiência de transfecção.
A Figura 4 mostra uma representação "pegada informações" 1,2 gerado por ensaio ~ 37.000 variantes aleatórias de uma sequência de 145 pb a montante do gene ifnb humano em células HEK293 com ou sem exposição ao virus Sendai. O promotor TATA-box e conhecido potenciador proximal 10 pode ser claramente identificada como regi rica em informaçõesons de um modo dependente de vírus.
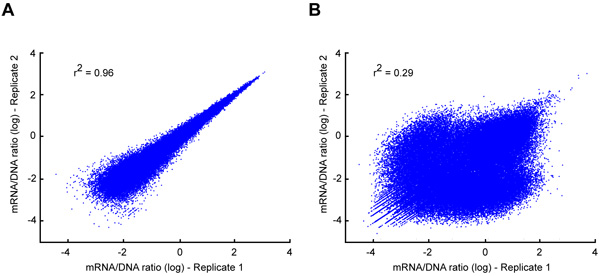
Figura 3 Tag-Seq reprodutibilidade. Gráficos de dispersão que mostram exemplos de dados de tag-Seq de dois transfections réplicas independentes com alta (A) e baixa (B) reprodutibilidade. A última trama mostra muitas marcas de outlier com contagens elevadas de ARNm em apenas uma das duas repetições. Tais artefactos tipicamente indicam que as concentrações de ARNm repórter foram demasiado baixos para a amplificação de PCR quantitativa, quer devido a baixas actividades absolutas entre as construções repórter, ou baixos níveis de eficiência de transfecção.
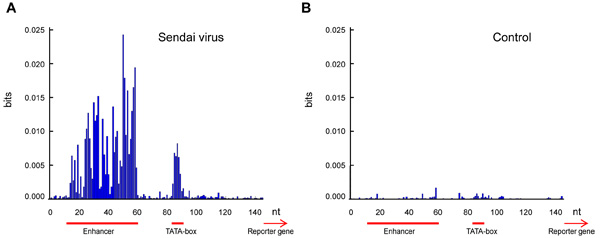
Figura 4. Informação pegada do local de início da transcrição ifnb humano e potenciador proximal. Cerca de 37.000 variantes aleatórios de uma região de 145 nucleótidos (nt) a montante do gene humano ifnb foram ensaiadas usando MPRA em células HEK293 com (A) e sem (B) exposição a vírus de Sendai. As barras azuis mostrar a informação mútua entre a saída do repórter e as sequências de nucleótidos em cada posição. O potenciador proximal e caixa TATÁ destacam como regiões com elevado teor de informação, por infecção viral.
Discussão
O MPRA é uma ferramenta flexível e poderosa para dissecação de relações sequência-atividade em elementos reguladores de genes. O sucesso dos experimentos de MPRA depende de pelo menos três fatores: 1) design cuidadoso da biblioteca de sequências, 2) minimização de artefatos durante a amplificação e clonagem e 3) alta eficiência de transfecção.
Os comprimentos possíveis das regiões variáveis nas construções repórter são amplamente determinados pela tecnologia de síntese ou clonagem usada. O OLS padrão geralmente é limitado a cerca de 200 nt, mas esse protocolo é compatível com inserções de até pelo menos 1.000 nt. Observe que regiões variáveis que são altamente repetitivas ou contêm estruturas secundárias fortes podem acabar sub-representadas devido a vieses de PCR e clonagem. O comprimento das tags que identificam cada uma das regiões variáveis deve ser de 10 a 20 nt e a coleção de tags deve ser idealmente projetada de forma que haja pelo menos duas diferenças de nucleotídeos entre qualquer par. Tags que contêm as sequências de sementes de microRNA conhecido ou outros fatores que podem influenciar a estabilidade do mRNA também devem ser evitados quando possível.
Um parâmetro-chave no projeto de experimentos MPRA é o número total de construções repórter distintas a serem incluídas na biblioteca (a complexidade do projeto, denotada CD). Na prática, o CD é limitado pelo número de células cultivadas que podem ser transfectadas. Como regra geral, o número total de células transfectadas deve ser pelo menos 50-100 vezes maior que o CD. Por exemplo, se 20 milhões de células podem ser transfectadas com uma eficiência de transfecção de 50%, então CD não deve ser superior a ~ 200.000. Observe que CD é igual ao número de variantes de sequência regulatória distintas multiplicado pelo número de tags distintas por sequência. Quanto mais marcas distintas estiverem vinculadas a cada sequência regulatória, mais precisa será a estimativa da atividade dessa sequência (porque as medições de marcas distintas podem ser calculadas), mas menos variantes distintas podem ser analisadas em um experimento. A escolha ideal depende do projeto experimental. Em um experimento simples de "ataque ao promotor", onde um modelo matemático será ajustado às medições agregadas, uma única etiqueta por variante geralmente é suficiente. Em uma triagem para polimorfismos de nucleotídeo único que causam alterações nas atividades regulatórias, pode ser necessário usar 20 ou mais tags por alelo para obter resultados estatisticamente robustos, porque comparar cada par de alelos requer um teste de hipótese separado.
Se não se espera que as sequências a serem analisadas contenham locais de início de transcrição, um promotor constante também pode ser adicionado no mesmo fragmento. Por exemplo, pMPRAdonor2 (Addgene ID 49353) inclui um promotor TATA-box mínimo que é útil quando se espera que a região variável a montante tenha atividade intensificadora significativa, enquanto pMPRAdonor3 (Addgene ID 49354) inclui um promotor viral SV40 forte e modificado que é útil quando se espera que a região variável contenha atividade silenciadora ou outros elementos regulatórios negativos.
Os produtos OLS brutos geralmente contêm uma fração significativa de oligonucleotídeos truncados. Isso pode interferir na amplificação precisa da PCR das sequências projetadas, particularmente quando há homologia significativa entre elas. O uso da purificação PAGE para remover produtos de síntese truncados e PCR de emulsão para minimizar os artefatos de amplificação são técnicas eficazes para garantir a alta qualidade da biblioteca. Se qualquer uma das etapas for impraticável, é imperativo minimizar o número de ciclos de PCR usados em cada etapa de amplificação. A seleção e expansão da biblioteca clonada em cultura líquida é geralmente suficiente para manter a complexidade do projeto, mas se vetores propensos à recombinação forem usados ou se for observado um viés de representação significativo, as células recuperadas podem ser semeadas diretamente em grandes placas de ágar LB, expandidas como colônias individuais e depois raspadas para isolamento de DNA. Também é importante considerar o impacto potencial dos erros de síntese, que normalmente são encontrados a uma taxa de 1:100-500 no OLS. Recomenda-se o sequenciamento completo das construções repórter antes da transfecção para identificar e corrigir tais erros.
Não é necessário introduzir construções repórter em todas as células da cultura transfectada, mas eficiências de transfecção abaixo de ~ 50% podem levar a taxas de sinal para ruído ruins. É aconselhável otimizar as condições de transfecção antes de realizar experimentos de MPRA em um novo tipo de célula. Ao trabalhar com tipos de células difíceis de transfectar, os sinais MPRA podem ser aumentados pela pré-seleção de células transfectadas. A série de vetores pMPRA inclui variantes que expressam constitutivamente um marcador de superfície celular truncado que pode ser usado para enriquecer fisicamente as células transfectadas antes do isolamento do RNA (por exemplo, Addgene IDs 49350 e 49351).
Divulgações
Os autores declaram que não têm interesses financeiros concorrentes.
Agradecimentos
Este trabalho foi financiado pelo Instituto Nacional de Pesquisa do Genoma Humano dos Institutos Nacionais de Saúde sob Award Número R01HG006785.
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| Síntese de biblioteca de oligonucleotídeos | Agilent, CustomArray ou outros fornecedores de OLS | personalizados | Se estiver usando o método de construção OLS |
| pMPRA1 | Addgene | 49349 | MPRA plasmídeo |
| backbone pMPRAdonor1 | Addgene | 49352 | luc2 ORF plasmídeo |
| doador TE 0.1 Tampão (10 mM Tris-HCl, 0.1 mM EDTA, pH 8.0) | Genérico | n/a | Tampão OLS |
| Novex Géis TBE-Ureia, 10% | Life Technologies | EC6875BOX | PAGE purificação de produtos OLS |
| Novex TBA-Ureia Sample Buffer | Life Technologies | LC6876 | PAGE purificação de produtos |
| OLS SYBR Gold Gel de Ácido Nucleico Stain | Life Technologies | S-11494 | PAGE purificação de produtos OLS |
| Emulsão de DNA de Micellula & Kit de purificação | EURx/CHIMERx | 3600-01 | Biblioteca de amplificação por emulsão PCR |
| Herculase II Fusão DNA Polimerase | Agilent | 600675 | Polimerase para emulsão |
| PCR SfiI | New England Biolabs | R0123S | Clonagem de biblioteca com vetores pMPRA |
| KpnI-HF | New England Biolabs | R3142S | Clonagem de biblioteca com vetores pMPRA |
| XbaI | Novo England Biolabs | R0145S | Clonagem de biblioteca com vetores pMPRA |
| T4 DNA Ligase (2.000.000 unidades/ml) | New England Biolabs | M0202T | Clonagem de biblioteca com vetores pMPRA |
| One Shot TOP10 Electrocomp E. coli | Life Technologies | C4040-50 | Clonagem de biblioteca com vetores pMPRA |
| Ágar LB e meios líquidos com carbenicilina | Genérico | n/a | Meios de crescimento para clonagem |
| de géis E-Gel EX 1% | Life Technologies | G4010-01 | Verificação e purificação de biblioteca |
| Géis E-Gel EX, 2% | Life Technologies | G4010-02 | Verificação e purificação de biblioteca |
| Kit de extração de gel MinElute | Qiagen | 28604 | Biblioteca e purificação de backbone |
| EndoFree Plasmid Maxi Kit | Qiagen | 12362 | Biblioteca Isolamento de DNA |
| Meios de cultura celular | n/a | n/a | Reagentes de |
| transfecção | n/a | n/a | MicroPoly |
| (A)Purist | para experimentos Life Technologies | AM1919 | isolamento de mRNA |
| TURBO sem DNA Kit | Life Technologies | AM1907 | Remoção de DNA de plasmídeo |
| SuperScript III Vida útil do sistema de síntese de primeira fita | Tecnologias | 18080-051 | síntese de cDNA |
| PfuUltra II Hotstart PCR Master Mix | Agilent | 600850 | Polimerase para Tag-Seq |
| PCR Primers (ver texto) | IDT | personalizado | PAGE purificar primers Tag-Seq |
Referências
- Kinney, J., Murugan, A., Callan, C. G., Cox, E. C. Using deep sequencing to characterize the biophysical mechanism of a transcriptional regulatory sequence. Proceedings of the National Academy of Sciences USA. 107 (20), 9158-9163 (2010).
- Melnikov, A., et al. Systematic dissection and optimization of inducible enhancers in human cells using a massively parallel reporter assay. Nature Biotechnology. 30 (3), 271-277 (2012).
- Patwardhan, R. P., Lee, C., Litvin, O., Young, D. L., Pe’er, D., Shendure, J. High-resolution analysis of DNA regulatory elements by synthetic saturation mutagenesis. Nature Biotechnology. 27 (12), 1173-1175 (2009).
- Patwardhan, R. P., et al. Massively parallel functional dissection of mammalian enhancers in vivo. Nature Biotechnology. 30 (3), 265-270 (2012).
- Arnold, C. D., Gerlach, D., Stelzer, C., Boryń, ŁM., Rath, M., Stark, A. Genome-wide quantitative enhancer activity maps identified by STARR-seq. Science (New York, N. Y.). 339 (6123), 1074-1077 (2013).
- Kheradpour, P., et al. Systematic dissection of regulatory motifs in 2000 predicted human enhancers using a massively parallel reporter assay. Genome Research. 23 (5), 800-811 (2013).
- White, M. A., Myers, C. A., Corbo, J. C., Cohen, B. A. Massively parallel in vivo enhancer assay reveals that highly local features determine the cis -regulatory function of ChIP-seq peaks. Proceedings of the National Academy of Sciences USA. 110 (29), 11952-11957 (2013).
- Mogno, I., Kwasnieski, J. C., Cohen, B. A. Massively parallel synthetic promoter assays reveal the in vivo effects of binding site variants. Genome Research. 23 (11), 1908-1915 (2013).
- Schütze, T., et al. A streamlined protocol for emulsion polymerase chain reaction and subsequent purification. Analytical Biochemistry. 410 (1), 155-157 (2011).
- Panne, D., Maniatis, T., Harrison, S. C. An atomic model of the interferon-beta enhanceosome. Cell. 129 (6), 1111-1123 (2007).
Reimpressões e permissões
Errata
Formal Correction: Erratum: Massively Parallel Reporter Assays in Cultured Mammalian Cells
Posted by JoVE Editors on 3/01/2015. Citeable Link.
null
Explorar mais artigos
Ensaio de Repórter Massivamente ParaleloConstrução de Biblioteca de RepórteresAnálise de Sequências de DNAAtividade Regulatória GênicaTransfecção de Células MamíferasAnálise de Sequenciamento ProfundoProtocolo de PCR em EmulsãoPreparação de Biblioteca de PlasmídeosContagem de Etiquetas de SequênciaAnálise Computacional
