Bu çalışma, akciğer adenokarsinomunda mitotik katastrof ile ilişkili sekiz prognostik gen (PDGFB, LDHA, ZEB2, H2AX, FKBP4, DMD, ANXA2, S100B) tanımlamakta, kabul edilebilir öngörü performansına sahip bir risk modeli oluşturmakta ve risk grupları arasında belirgin immün mikroçevre özellikleri olduğunu ortaya koymaktadır.
Bu içeriği görüntülemek için JoVE aboneliğiniz gereklidir. Giriş yapın veya ücretsiz denemenizi bugün başlatın.
Araştırma makalesi
Transkriptom Analizi Yoluyla Akciğer Adenokarsinomunda Mitotik Felaket İlişkili Prognostik Genlerin Belirlenmesi
Bu makalede
Özet
Özet
En yaygın akciğer kanseri alt tipi olan akciğer adenokarsinomu (LUAD), kötü bir prognoz sergilemektedir. LUAD'da hücre ölümüne yol açan mitotik katastrof indüklenebilse de, mitotik katastrof ilişkili genlerin (MCRG'ler) bu hastalıktaki prognostik ve biyolojik önemi belirsizliğini korumaktadır. LUAD ile ilişkili diferansiyel eksprese olan genler (DEG'ler) TCGA-LUAD kohortundan taranmış ve DEG'lerin MCRG'lerle kesişmesi yoluyla örtüşen genler tanımlanmıştır. Makine öğrenimi yoluyla aday prognostik genler seçilmiş ve ardından çok genli bir prognostik model oluşturulmuştur. PDGFB, LDHA, ZEB2, H2AX, FKBP4, DMD, ANXA2 ve S100B'den oluşan sekiz aday prognostik imza kurulmuş; eğitim setinde sırasıyla 0,723, 0,715 ve 0,625 değerlerindeki 2 yıllık, 3 yıllık ve 5 yıllık eğri altı alan (AUC) değerleri ile kabul edilebilir bir öngörü güvenilirliği (bootstrap-düzeltmeli C-indeksi: 0,699, %95 CI: 0,657-0,742) ve GSE31210'da tutarlı bir validasyon (AUC'ler: 0,812, 0,766 ve 0,814) göstermiştir. Düşük riskli hastalar, anlamlı derecede daha iyi sağkalım sonuçları, artmış immün infiltrasyon, daha yüksek immün ve stromal skorlar, artmış immünofeniskorlar ve daha aktif kanser immünite döngüleri sergilemiştir. Yüksek ve düşük riskli gruplar arasında tümör mutasyon yükü ve ilaç duyarlılığında anlamlı farklar gözlemlenmiştir. Kantitatif polimeraz zincir reaksiyonu (qPCR), klinik örneklerdeki altı aday sonuçla ilişkili genin transkriptomik profillerini doğrulamıştır. Risk skorunu ve klinik evreyi içeren bir nomogram, iyi bir öngörü performansı göstermiştir. Bu bulgular, sekiz MCRG ilişkili aday genin, risk grupları arasındaki belirgin immün mikroçevre özellikleri ile birlikte, LUAD'da hasta sonuçlarını öngörmek ve riski stratifiye etmek için güçlü bir potansiyele sahip olduğunu kanıtlamaktadır.
Giriş
Akciğer kanseri, dünya çapında en yaygın ve ölümcül kanserler arasında yer almaya devam etmektedir1,2. Küçük hücreli dışı akciğer kanserinde (NSCLC), tüm akciğer kanseri vakalarının yaklaşık %40'ını oluşturan akciğer adenokarsinomu (LUAD) hakimdir3,4. Cerrahi prosedürlerde, moleküler hedefli tedavilerde, immün kontrol noktası inhibitörlerinde ve kombinasyon rejimlerinde önemli ilerlemeler kaydedilmiş olsa da, LUAD hastaları için klinik görünüm olumsuz kalmaya devam etmektedir5,6. LUAD'da patolojik ve görüntüleme tabanlı tanı yaklaşımları yaygın olarak kullanılsa da, tümör heterojenliğini ve moleküler özelliklerini yakalamada doğuştan gelen kısıtlamalara sahiptirler. Buna karşılık, moleküler biyobelirteç tabanlı tümör dokusu analizi, tümör biyolojisi hakkında daha kapsamlı bilgiler sağlayabilir ve prognostik değerlendirme ile bireyselleştirilmiş tedavi stratejilerine katkıda bulunabilir7. Bu nedenle, güvenilir moleküler biyobelirteçlerin tanımlanması, LUAD'ın prognostik öngörüsünü ve biyolojik anlayışını geliştirmek için önemini korumaktadır.
Hücresel replikasyonun temel bir mekanizması olan mitoz, replike olmuş kromozomların iki kız hücre arasında doğru şekilde paylaştırılmasını sağlar8. Mitotik süreçlerin düzensizliği; kontrolsüz hücre proliferasyonunu, genomik instabiliteyi ve tümör progresyonunu teşvik edebilir. Mitotik katastrof (MC), tipik olarak iğ iplikleri aparatının hasarı veya kusurlu hücre döngüsü kontrol noktalarından kaynaklanan, mitozun tamamlanamaması üzerine tetiklenen bir hücre ölümü yolağını tanımlar9. Morfolojik düzeyde MC; çok çekirdeklilik, mikronükleler, multipolar iğ yapıları ve poliploidizasyon dahil olmak üzere hücresel anomalilerle kendini gösterir10. Ağır mitotik kusurları olan hücreleri ortadan kaldırma mekanizması olarak MC, tümör progresyonunun baskılanmasına katkıda bulunabilir9. A549 LUAD hücrelerinde p53 delesyonu, mitotik katastrofu ve nihayetinde hücre ölümünü tetikleyebilir11; bu durum MC ile LUAD ile ilişkili hücresel süreçler arasında potansiyel bir bağlantı olduğunu göstermektedir. Bununla birlikte, LUAD'da MC ile ilişkili genlerin (MCRG'ler) prognostik önemi ve biyolojik fonksiyonları henüz yeterince aydınlatılmamıştır.
Bu araştırmada, LUAD'daki MCRG'lerin prognostik önemi ve varsayılan biyolojik ilgisi, TCGA ve GEO'dan alınan veriler kullanılarak sistematik olarak incelenmiştir. Aday MCRG'ler öncelikle diferansiyel ekspresyon ve kesişim analizleri yoluyla belirlenmiştir. Çoklu makine öğrenimi yaklaşımları ile aday genler taranmış ve daha sonra dışsal olarak valide edilen bir prognostik risk imzası oluşturulmuştur. Sağkalım öngörüsünü geliştirmek amacıyla, risk skorunu klinik özelliklerle birlikte içeren bir nomogram geliştirilmiştir. Ek olarak, belirlenen genlerin biyolojik etkilerini ve klinik faydasını incelemek için immün mikroçevre karakterizasyonu, somatik mutasyon değerlendirmesi ve kemosensitivite analizi gerçekleştirilmiştir. Topluca, bu bulgular LUAD'da MCRG'lerin prognostik potansiyelini ortaya koymakta olup biyobelirteç geliştirilmesine ve bireyselleştirilmiş yönetime ışık tutabilir.
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Protokol
Çalışma, Helsinki Deklarasyonu'na uygun olarak yürütülmüş ve protokol, 22 Nisan 2025 tarihinde Anhui Göğüs Hastanesi Etik Kurulu tarafından onaylanmıştır (K2025-007). Çalışmaya katılan tüm öznelerden bilgilendirilmiş onam alınmıştır.
Veri çıkarımı ve normalizasyonu
LUAD için transkriptomik profiller ve ilgili klinik veri setleri TCGA ve GEO kohortlarından elde edilmiştir. TCGA-LUAD veri seti eğitim seti olarak belirlenmiş; GSE72094, GSE31210 ve GSE26939 ise dış doğrulama kohortları olarak kullanılmıştır (Tablo 1). Ek olarak, önceki bir çalışmadan 900 MCRG toplanmıştır12(Ek Tablo 1). Transkriptom verileri GENCODE v36 veya ilgili GPL platform anotasyon dosyaları kullanılarak açıklanmıştır. Prob ID'leri gen sembollerine dönüştürülmüş, yinelenen genler avereps fonksiyonu kullanılarak birleştirilmiş ve gen düzeyinde ekspresyon matrisleri oluşturmak için yalnızca protein kodlayan genler tutulmuştur. TCGA-LUAD eğitim seti için, örneklerin %50'den fazlasında milyon eşleşmiş fragman başına ekzon modelinin kilobazı başına fragman sayısı (FPKM) < 1 olan genler filtrelenmiş ve kalan ekspresyon değerlerine log2 dönüşümü uygulanmıştır (log2[FPKM+1]). GEO doğrulama kohortları için ham ekspresyon verileri indirilmiş, prob ID'leri ilgili platform anotasyon dosyaları kullanılarak gen sembollerine eşlenmiş ve aynı gene karşılık gelen çoklu problar, ekspresyon değerlerinin ortalaması alınarak birleştirilmiştir. Bu veri setlerine gerektiğinde log2 dönüşümü uygulanmıştır. Göreli karşılaştırılabilirliği sağlamak amacıyla her kohort için ayrı bir standardizasyon stratejisi benimsendiğinden, TCGA ve GEO arasında platformlar arası toplu etki (batch effect) düzeltmesi uygulanmamıştır. Spesifik olarak, hem eğitim hem de doğrulama kohortları için gen ekspresyon değerleri, her veri setinin ortalaması ve standart sapması kullanılarak merkezlenmiş ve ölçeklendirilmiştir (z-skoru dönüşümü). Daha sonra, eğitim setinden elde edilen aynı Cox regresyon katsayıları, tüm kohortlar için risk skorlarını hesaplamak amacıyla kullanılmıştır. Klinik uygulanabilirliği korumak ve herhangi bir doğrulama setine aşırı uyum sağlamaktan (overfitting) kaçınmak için, eğitim kohortunun medyan risk skoru, tüm dış doğrulama kohortlarındaki hastaları yüksek ve düşük riskli gruplara ayırmak için sabit bir kesme noktası olarak kullanılmıştır. Yaş, cinsiyet, patolojik evre, Tümör-Nod-Metastaz (TNM) evresi, histolojik tip, sağkalım süresi, sağkalım durumu ve doku tipi dahil olmak üzere klinik bilgiler, mevcut olduğunda çıkarılmıştır. Son nokta genel sağkalım (OS) olarak belirlenmiştir. Eksik sağkalım bilgisi olan veya sağkalım süresi < 30 gün olan örnekler hariç tutulmuştur. Sağkalım süresi yıla çevrilmiş ve sağkalım durumu hayatta olanlar için 0, ölenler için 1 olarak kodlanmıştır.
Aday genlerin tanımlanması ve fonksiyonel analizleri
Limma paketi, eğitim setindeki LUAD tümör ve normal örnekler arasındaki farklı ifade edilen genleri (DEG'ler) belirlemiştir13. DEG'ler, |log2FC| > 0.5 ve düzeltilmiş p-değeri < 0.05 kriterlerine göre tanımlanmıştır. Ardından, DEG'leri farklı ekspresyon kümelerine ayırmak için ClusterGVis R paketindeki mfuzz bulanık kümeleme algoritması kullanılmıştır. Üyelik puanlarına dayanarak her kümedeki en temsili beş gen üzerinde Gen Ontolojisi–Biyolojik Süreç (GO-BP) analizi tamamlanmıştır. DEG'ler ile MCRG'lerin kesişimi alınarak ortak gen seti türetilmiştir. Örtüşen genlerin biyolojik uygunluğu, Gen Ontolojisi/Kyoto Genler ve Genomlar Ansiklopedisi (GO/KEGG) kullanılarak yapılan fonksiyonel zenginleştirme analizi ile değerlendirilmiştir. Protein-protein etkileşim (PPI) ağları STRING veri tabanından elde edilmiştir14. Ağ güvenilirliğini artırmak için yalnızca güven puanı > 0.7 olan etkileşimler tutulmuştur.
Prognostik gen taraması
LUAD'da genel sağkalımla ilişkili olması muhtemel genleri belirlemek için tek değişkenli Cox regresyon analizi gerçekleştirmek amacıyla Survival paketi kullanılmıştır15. p-değeri < 0.05 olan genler potansiyel prognostik göstergeler olarak değerlendirilmiştir. TCGA-LUAD eğitim kohortu, tam sağkalım verilerine sahip 500 hastayı içermekte olup, bunlardan 216'sı (%43,2) izlem sırasında ölüm olayları yaşamıştır. Aday genlerin (n = 108) olaylara (n = 216) oranı yaklaşık 1:2 olup bu durum Cox regresyon analizi için kabul edilebilir düzeydedir. Ardından, öznitelikleri daha fazla seçmek için En Küçük Mutlak Büzülme ve Seçim Operatörü (LASSO) regresyon analizi ve Ekstrem Gradyan Artırma (XGBoost) modeli kullanılmıştır. Cox orantılı risk modelleri, glmnet paketinin cv.glmnet fonksiyonu aracılığıyla family = "cox" şeklinde oluşturulmuştur. Optimal düzenlileştirme parametresi, 10 katlı çapraz doğrulama kullanılarak belirlenmiş ve minimum çapraz doğrulama hatasını temsil eden λ.min değeri, optimal λ değeri olarak seçilmiştir. Sıfır olmayan regresyon katsayılarına sahip genler aday öznitelikler olarak çıkarılmıştır. XGBoost modeli için sağkalım süresi ve sağkalım durumu sonuç değişkeni olarak birleştirilmiş; ölüm olaylarına pozitif değerler, sansürlü vakalara ise negatif değerler atanmıştır. Parametreler objective = "survival: cox" ve eval_metric = "cox-nloglik" olarak, 100 iterasyon ve 0,1 öğrenme hızıyla ayarlanmıştır. Model eğitiminden sonra, öznitelik kazanç değerleri kullanılarak gen önem skorları hesaplanmıştır. Öznitelik boyutunu ve model karmaşıklığını azaltmak için önem skorları azalan sırada sıralanmış ve ilk 20 gen tutulmuştur. LASSO ve XGBoost sonuçları arasında örtüşen genler, aday prognostik genler olarak tanımlanmıştır.
Prognostik bir modelin oluşturulması ve değerlendirilmesi
Belirlenen aday genlerin çok değişkenli Cox regresyon analizi kullanılarak bir prognostik model geliştirilmiştir. Risk skorları şu şekildele bireysel olarak hesaplanmıştır:
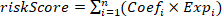 .
burada Coefi i geni için katsayıyı ve Expi ilgili gen ekspresyon değerini belirtir. Bireyler daha sonra, medyan risk skoru kesme noktası olarak kullanılarak yüksek riskli ve düşük riskli olmak üzere iki gruba ayrılmıştır. Ardından, zamana bağlı alıcı işletim karakteristiği (ROC) eğrileri oluşturulmuştur. Aşırı uyum (overfitting) potansiyelini değerlendirmek için, 1.000 yeniden örnekleme iterasyonu ile bootstrap dahili doğrulaması gerçekleştirilerek, %95 güven aralıkları ile yanlılığı düzeltilmiş C-indeksi ve zamana bağlı AUC'ler hesaplanmıştır. 2, 3 ve 5 yıllık tahmin edilen ve gözlemlenen sağkalım olasılıkları arasındaki uyumu değerlendirmek için kalibrasyon eğrileri oluşturulmuştur. Ayrıca, farklı eşik olasılıklarında risk skorunun klinik karar verme sürecindeki potansiyel değerini nicelleştirmek amacıyla, modelin 2, 3 ve 5 yıllık zaman noktalarındaki klinik net faydasını değerlendirmek için R'daki ggDCA paketi kullanılarak karar eğrisi analizi (DCA) yapılmıştır. Riskle tabakalandırılmış gruplar ve diğer klinik kategoriler arasındaki sağkalım farklılıkları, log-rank testi ile Kaplan–Meier (KM) sağkalım eğrileri kullanılarak karşılaştırılmıştır. Ayrıca, bireysel genlerin model performansına katkılarını aydınlatmak için post-hoc açıklayıcı yorumlama amacıyla Shapley Additive exPlanations (SHAP) analizi kullanılmıştır.
Nomogram geliştirme ve dış doğrulama
Modelin klinik uygulanabilirliğini değerlendirmek amacıyla, hesaplanan risk skorları ile çeşitli klinik özellikler (cinsiyet, yaş ve TNM evresi dahil) arasındaki ilişkiler Wilcoxon sıra toplamı veya Kruskal-Wallis testleri kullanılarak incelenmiştir. Risk skorunun bağımsız bir prognostik faktör olarak işlev görüp görmediğini değerlendirmek için klinik değişkenler ve risk skoru çok değişkenli Cox regresyon modellemesine dahil edilmiştir. Ardından, hayatta kalma olasılığı tahminlerini bireyselleştirmek için bağımsız klinik risk faktörlerini (örneğin, Evre) ve genetik risk skorunu birleştiren bir prognostik nomogram, regplot R paketi aracılığıyla oluşturulmuştur. Nomogram tarafından öngörülen hayatta kalma olasılığının gerçek hayatta kalma sonuçlarıyla uyumunu değerlendirmek için kalibrasyon eğrileri kullanılmıştır. Son olarak, entegre nomogram sisteminin nihai öngörü kapasitesi ve genellenebilirliği, zaman bağımlı ROC eğrileri ve kohortlar genelinde kapsamlı KM klinik alt grup analizleri ile titizlikle doğrulanmıştır.
İmmün infiltrasyon ve immün alt tip analizleri
LUAD hastalarındaki immün hücre infiltrasyonunu değerlendirmek amacıyla, lökosit gen (LM22) imza matrisi kullanılarak 22 immün hücre tipinin göreceli oranlarını tahmin etmek için CIBERSORT kullanılmıştır. Prognostik gen ekspresyon seviyeleri ile immünolojik infiltrasyon arasındaki ilişkiler Spearman korelasyon analizi ile değerlendirilmiştir. İmmün, stromal, tümör saflığı ve ESTIMATE skorları ESTIMATE algoritması aracılığıyla türetilmiş ve risk grupları arasındaki farklar Wilcoxon testi ile değerlendirilmiştir. LUAD hastaları, ImmuneSubtypeClassifier paketi16 kullanılarak altı immün alt tipe ayrılmıştır. Risk grupları arasındaki immün alt tip dağılımlarını karşılaştırmak için ek olarak Wilcoxon testi kullanılmıştır.
İmmün kontrol noktası, immünofenoskor ve kanser immünite döngüsü analizleri
Bu çalışmada, LUAD immün manzarasını karakterize etmek amacıyla, riskle stratifiye edilmiş gruplar genelinde 21 immün kontrol noktası genini17 değerlendirmek için Wilcoxon sıra toplamı testi kullanılmıştır. Aday prognostik genler, Spearman korelasyonu ile immün kontrol noktası genlerine ilişkilendirilmiştir. Farklı risk seviyelerindeki LUAD hastalarında immün kontrol noktası inhibitörlerine (ICI'lar) verilen yanıttaki farklılıkları değerlendirmek için, anti-PD-1 ve anti-CTLA-4 tedavilerine ait immünofenospuan (IPS) verileri The Cancer Immunome Atlas (TCIA)18 üzerinden elde edilmiş ve kanser-immünite döngüsü aktivitesini değerlendirmek ile risk grupları arasındaki ilgili puanları karşılaştırmak için Tracking Tumor Immunophenotype (TIP)19 veri tabanı kullanılmıştır.
Somatik mutasyon ve ilaç duyarlılık analizi
Risk grupları arasındaki mutasyon modellerindeki varyasyonları incelemek için TCGA mutasyonları aracı kullanılarak TCGA-LUAD vakalarına ait somatik mutasyon profilleri elde edildi. Mutasyon verileri maftools paketi ile işlendi ve görselleştirildi. Her bir örnek için tümör mutasyon yükü (TMB) seviyeleri belirlendi ve iki risk kategorisi arasında karşılaştırıldı. Farmakogenomik duyarlılık analizi, Genomics of Drug Sensitivity in Cancer (GDSC) veri tabanına20 uygun olarak pRRophetic paketi kullanılarak gerçekleştirildi. Her bir LUAD hastası için antikanser ilaçların yarı maksimal inhibisyon konsantrasyonu (IC50) değerleri tahmin edildi ve risk grubu arasındaki farklılıklar Wilcoxon sıra toplam testi kullanılarak nicelendirildi.
Prognostik genlerin ekspresyon seviyelerinin değerlendirilmesi
Her bir veri seti, seçilen aday sonuçla ilişkili genlerin transkript düzeylerini değerlendirmek için kullanılmıştır. Gen ekspresyonunu hasta prognozu ile ilişkilendirmek amacıyla, survminer R paketindeki surv_cutpoint fonksiyonu aracılığıyla optimal kesim noktaları belirlenmiştir. Bu eşik değerlere dayanarak, LUAD vakaları sonraki sağkalım analizi için yüksek ve düşük ekspresyonlu alt gruplara ayrılmıştır.
Ayrıca, Anhui Göğüs Hastanesi'nden eşleşmiş beş LUAD tümörü ve komşu normal doku çifti temin edilmiş ve ardından qPCR doğrulaması gerçekleştirilmiştir. Tüm katılımcılar yazılı bilgilendirilmiş onay vermiştir. qPCR doğrulaması için altı aday prognostik gen (PDGFB, LDHA, ZEB2, FKBP4, DMD ve S100B) seçilmiştir. RNA, RNA ekstraksiyon reaktifi kullanılarak homojenize edilmiş doku örneklerinden ekstrakte edilmiş, ardından kloroform ekstraksiyonu ve izopropanol çöktürmesi uygulanmıştır. RNA konsantrasyonu ve saflığı spektrofotometre ile ölçülmüştür. Altı aday prognostik genin qPCR doğrulaması, bir real-time PCR sisteminde SYBR Green tabanlı PCR master mix kullanılarak gerçekleştirilmiştir: 95 °C'de 30 s boyunca başlangıç denatürasyonunu takiben 40 döngü boyunca 95 °C'de 20 s, 55 °C'de 20 s ve 72 °C'de 20 s uygulanmıştır. Relatif ekspresyon hesaplanmış ve 2-ΔΔCt tekniği ile Glyceraldehyde-3-Phosphate Dehydrogenase(GAPDH) genine göre standardize edilmiştir. Tüm reaktiflerin ve cihazların detayları Malzemeler Tablosunda verilmiştir.
İstatistiksel analiz
İstatistiksel analizler, istatistiksel hesaplama ve grafikleme yazılımı kullanılarak gerçekleştirilmiştir. Protein-protein etkileşim ağı, ağ analiz yazılımı kullanılarak görselleştirilmiştir. Normalite değerlendirmesinin ardından, normal dağılım gösteren sürekli değişkenler için Student t-testi, normal dağılım göstermeyenler için ise Mann-Whitney U testi kullanılmıştır.
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Sonuçlar
Aday gen tanımlama ve fonksiyonel analiz
2.485 down-DEG ve 2.430 up-DEG olmak üzere toplam 4.915 DEG tespit edilmiştir (Şekil 1A). Fonksiyonel modül kümeleme analizi, bu DEG'leri altı ekspresyon modülüne (C1-C6) ayırmış olup, bunlar arasından C1, C2, C3 ve C5 modülleri tümör örneklerinde nispeten daha yüksek ekspresyon göstermiştir (Şekil 1B). Fonksiyonel anotasyon, bu modüllerin aktomiyosin kontraktil halka organizas...
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Tartışma
LUAD, akciğer kanserinin önde gelen türleri arasında yer almakta ve önemli bir halk sağlığı yükü oluşturmaya devam etmektedir21. MC, ciddi mitotik anomalilere sahip hücrelerin temizlenmesine ve tümör ilerlemesinin baskılanmasına katkıda bulunabilen hücre ölümüyle ilişkili bir süreçtir22. Bu nedenle, MCRG'lerin LUAD'daki potansiyel rolünün araştırılması, prognostik biyobelirteçlerin tanımlanmasına yardımcı olabilir ve LUAD biyolojisinin anlaşılmasını geliştirebilir. Çalışmad...
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Açıklamalar
Yazarlar herhangi bir çıkar çatışması beyan etmemektedir.
Malzemeler
| Ad | Şirket | Katalog numarası | Yorumlar |
|---|---|---|---|
| ClusterGVis | CRAN | versiyon 0.1.2 | Gen Ekspresyon Kümelemesi ve Görselleştirme |
| Cytoscape | Cytoscape Konsorsiyumu | sürüm 3.9.1 | Protein Etkileşim Ağlarının Görselleştirilmesi RRID:SCR_003032 |
| CFX384 Gerçek Zamanlı Kantitatif Floresan PCR Sistemi | Bio-Rad | CFX384 Touch | qPCR reaktifi |
| DMD primeri | Tsingke | Girdi sağlanmadı. Lütfen çevrilmesini istediğiniz metni giriniz. | İleri: 5’-GCTCAACCATCGATTTGCAGCC-3’ Tersine Çevir: 5’-TTCAGCCTCCAGTGGTTCAAGC-3’ |
| FKBP4 primeri | Tsingke | Lütfen çevrilmesini istediğiniz kaynak metni sağlayın. | İleri: 5’-TGACTCCAGTCTGGATCGCAAG-3’ Tersine Çevir: 5’-CTGGTTTGCAGGTGATGTGGCA-3’ |
| GEO | NCBI | Çevrimiçi Araç | LUAD Dış Doğrulama Veri Setinin Elde Edilmesi RRID:SCR_005012 |
| GAPDH-primeri | Tsingke | Lütfen çevrilmesi gereken kaynak metni sağlayın. Metni ilettiğinizde, belirttiğiniz tüm bilimsel ve teknik kriterlere uygun olarak akademik Türkçe çevirisini gerçekleştireceğim. | İleri: 5’-GTCTCCTCTGACTTCAACAGCG-3’ Ters çevirme: 5’-ACCACCCTGTTGCTGTAGCCAA-3’ |
| glmnet | CRAN | versiyon 4.1-8 | LASSO Regresyonda Özellik Seçimi RRID:SCR_015505 |
| LDHA-primeri | Tsingke | Lütfen çevrilmesini istediğiniz kaynak metni sağlayın. | İleri: 5’-GGATCTCCAACATGGCAGCCTT-3’ Tersine Çevir: 5’-AGACGGCTTTCTCCCTCTTGCT-3’ |
| limma | Bioconductor | versiyon 3.60.6 | DEG taraması RRID:SCR_010943 |
| maftools | Bioconductor | sürüm 2.20.0 | Somatik Mutasyon Verilerinin Görselleştirilmesi RRID:SCR_024519 |
| pRRophetic | CRAN | 0.5 | İlaç IC Değerinin Tahmini50 Değerler RRID:SCR_024417 |
| PDGFB-primer | Tsingke | Girdi sağlanmadı. Lütfen çevrilmesini istediğiniz metni iletin. | İleri: 5’-GAGATGCTGAGTGACCACTCGA-3’ Tersine çevir: 5’-GTCATGTTCAGGTCCAACTCGG-3’ |
| qPCR SYBR Green Master Mix | Vazyme | Q111-02 | qPCR reaktifi |
| R yazılımı | R Foundation | versiyon 4.2.2 | Biyoinformatik Analizi |
| regplot | CRAN | versiyon 1.1 | Çizgi Grafikleri Oluşturma |
| sağkalım | CRAN | sürüm 3.8-3 | Sağkalım Analizi ve Cox Regresyonu RRID:SCR_021137 |
| Lütfen çevirmek istediğiniz metni (STRING) paylaşın. Metni ilettiğinizde, belirttiğiniz tüm akademik ve teknik kriterlere uygun olarak çeviriyi gerçekleştireceğim. | STRING Konsorsiyumu | Çevrimiçi Araç | Protein Etkileşim Ağı Analizi RRID:SCR_005223 |
| S100B-primeri | Tsingke | Lütfen çevrilmesini istediğiniz metni sağlayın. | İleri: 5’-GAAGAAATCCGAACTGAAGGAGC-3’ Tersine Çevir: 5’-TCCTGGAAGTCACATTCGCCGT-3’ |
| survminer | CRAN | versiyon 0.5.0 | Sağkalım Eğrisi Çizimi ve Optimizasyonu RRID:SCR_021094 |
| TRIzol | Tiangen | DP424 | qPCR reaktifi |
| TCGA | NCI | Çevrim içi Araç | LUAD Transkriptom ve Klinik Veri Edinimi RRID:SCR_003193 |
| ZEB2-primeri | Tsingke | Metin sağlanmadı. Lütfen çevirmek istediğiniz İngilizce kaynağı paylaşın. | İleri: 5’-AATGCACAGAGTGTGGCAAGGC-3’ Tersine Çevirme: 5’-CTGCTGATGTGCGAACTGTAGG-3’ |
Kaynaklar
- Asada K, et al. Multi-omics and clustering analyses reveal the mechanisms underlying unmet needs for patients with lung adenocarcinoma and identify potential therapeutic targets. Mol Cancer. 2024;23(1):182.
- Sun Q, et al. Prediction of lung adenocarcinoma prognosis and diagnosis with a novel model anchored in circadian clock-related genes. Sci Rep. 2024;14(1):18202.
- Ho KH, et al. Cancer Essential Genes Stratified Lung Adenocarcinoma Patients with Distinct Survival Outcomes and Identified a Subgroup from the Terminal Respiratory Unit Type with Different Proliferative Signatures in Multiple Cohorts. Cancers (Basel). 2021;13(9):2128.
- Zhang J, et al. Unraveling the Expression Patterns of Immune Checkpoints Identifies New Subtypes and Emerging Therapeutic Indicators in Lung Adenocarcinoma. Oxid Med Cell Longev. 2022;2022:3583985.
- Zheng T, et al. The pathological significance and potential mechanism of ARHGEF6 in lung adenocarcinoma. Comput Biol Med. 2023;158:106894.
- Yu Y, et al. Predicting potential therapeutic targets and small molecule drugs for early-stage lung adenocarcinoma. Biomed Pharmacother. 2024;174:116528.
- Guo Q, et al. Heterogeneous mutation pattern in tumor tissue and circulating tumor DNA warrants parallel NGS panel testing. Mol Cancer. 2018;17(1):131.
- Wang S, et al. Development and validation of a mitotic catastrophe-related genes prognostic model for breast cancer. PeerJ. 2024;12:e18075.
- Mao Z, et al. Mitotic catastrophe heterogeneity: implications for prognosis and immunotherapy in hepatocellular carcinoma. Front Immunol. 2024;15:1409448.
- Zhang QY, et al. Multiple Regulatory Mechanisms of Post-Translational Modifications and Therapeutic Potential of Mitotic Catastrophe. Int J Mol Sci. 2026;27(8):3370..
- Minemoto Y, et al. Loss of p53 induces M-phase retardation following G2 DNA damage checkpoint abrogation. Arch Biochem Biophys. 2003;412(1):13-9.
- Liu Y, et al. Developing a prognosis and chemotherapy evaluating model for colon adenocarcinoma based on mitotic catastrophe-related genes. Sci Rep. 2024;14(1):1655.
- Ritchie ME, et al. limma powers differential expression analyses for RNA-sequencing and microarray studies. Nucleic Acids Res. 2015;43(7):e47.
- Szklarczyk D, et al. The STRING database in 2023: protein-protein association networks and functional enrichment analyses for any sequenced genome of interest. Nucleic Acids Res. 2023;51(D1):D638-d46.
- Lei J, et al. Clinicopathological characteristics of pheochromocytoma/paraganglioma and screening of prognostic markers. J Surg Oncol. 2023;128(4):510-8.
- Thorsson V, et al. The Immune Landscape of Cancer. Immunity. 2018;48(4):812-30.e14.
- Guo Y, et al. Novel immune checkpoint-related gene model to predict prognosis and treatment responsiveness in low-grade gliomas. Heliyon. 2023;9(9):e20178.
- Sun X, et al. A transcriptomic-based model associated with PARP inhibitor sensitivity and immunogenic signatures in ovarian cancer. Discover Oncology. 2026;843.
- Wang L, et al. Identification of an ac4C modification related gene signature for predicting prognosis in laryngeal squamous cell carcinoma patients based on single-cell analysis and machine learning. 2026.
- Lin W, et al. Screening of Molecular Markers of Cisplatin Resistance in Lung Adenocarcinoma and Functional Verification Based on TCGA Database. Cancer Research on Prevention and Treatment. 2024;49(6):569-74.
- Gao W, et al. Promising therapeutic efficacy and safety of a novel integrin α6-targeting peptide-drug conjugate in lung adenocarcinoma. Molecular Cancer 2025;24(1):190.
- Vitale I, et al. Mitotic catastrophe: a mechanism for avoiding genomic instability. Nat Rev Mol Cell Biol. 2011;12(6):385-92.
- Liu M, et al. CDK1-mediated phosphorylation of LDHA fuels mitosis through LDHB-dependent lactate oxidation. EMBO Reports 2025;26(20):4923-4949.
- Zhang W, et al. Inhibition of LDHA suppresses cell proliferation and increases mitochondrial apoptosis via the JNK signaling pathway in cervical cancer cells. Oncology reports 2022;47(4).
- Mangé A, et al. FKBP4 connects mTORC2 and PI3K to activate the PDK1/Akt-dependent cell proliferation signaling in breast cancer. Theranostics. 2019;9(23):7003-7015.
- Meng W, et al. FKBP4 Accelerates Malignant Progression of Non-Small-Cell Lung Cancer by Activating the Akt/mTOR Signaling Pathway. Analytical cellular pathology (Amsterdam) 2020;2020:6021602.
- Xiu-Ying H, et al. PDGFBB facilitates tumorigenesis and malignancy of lung adenocarcinoma associated with PI3K-AKT/MAPK signaling. Sci Rep. 2024;14(1):4191.
- Sharma D, Singh M, Rani R. Role of LDH in tumor glycolysis: Regulation of LDHA by small molecules for cancer therapeutics. Semin Cancer Biol. 2022;87:184-95.
- Zhang P, et al. An Epithelial-Mesenchymal Transition-Based Prognostic Model for Survival Prediction in Lung Adenocarcinoma: COL5A2 and ZEB2. Current gene therapy 2026.
- Xu X, et al. Proteomic landscape of lung adenocarcinoma precancerous lesions reveals mitochondrial dsRNA-associated immune and stress responses. American journal of cancer research 2025;15(9):3888-3903.
- Li P, et al. Peripheral blood mononuclear cell DNA methylation biomarkers for prognostic stratification in Chinese lung adenocarcinoma: a genome-wide epigenetic profiling study. Clinical Epigenetics 2025;17(1):177.
- Chaudhary S, et al. Dissecting the MUC5AC/ANXA2 signaling axis: implications for brain metastasis in lung adenocarcinoma. Exp Mol Med. 2024;56(6):1450-60.
- Kondrup M, Nygaard AD, Madsen JS, Bechmann T. S100B as a biomarker for brain metastases in patients with non-small cell lung cancer. Biomed Rep. 2020;12(4):204-8.
- Jones L, Naidoo M, Machado LR, Anthony K. The Duchenne muscular dystrophy gene and cancer. Cell Oncol (Dordr). 2021;44(1):19-32.
- Peng G, Yan J, Shi P, Li H. LINC01140 Hinders the Development of Breast Cancer Through Targeting miR-200b-3p to Downregulate DMD. Cell Transplant. 2023;32:9636897231211202.
- Alnassar N, et al. Downregulation of Dystrophin Expression Occurs across Diverse Tumors, Correlates with the Age of Onset, Staging and Reduced Survival of Patients. Cancers (Basel). 2023;15(5):1378.
- Luce LN, Abbate M, Cotignola J, Giliberto F. Non-myogenic tumors display altered expression of dystrophin (DMD) and a high frequency of genetic alterations. Oncotarget. 2017;8(1):145-55.
- Hu Z, et al. IL6-STAT3-C/EBPβ-IL6 positive feedback loop in tumor-associated macrophages promotes the EMT and metastasis of lung adenocarcinoma. J Exp Clin Cancer Res. 2024;43(1):63.
- Ugel S, Canè S, De Sanctis F, Bronte V. Monocytes in the Tumor Microenvironment. Annu Rev Pathol. 2021;16:93-122.
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Yeniden basım ve izinler
Bu makale yayımlandı
Video yakında