Hukuki metin parçalanması ve tıbbi yapay zeka (AI) yanlılık izleme sorunlarını ele alan bu çalışma, bir hukuki bilgi grafiği oluşturmakta ve semantik hizalama için ilişki farkındalıklı graf konvolüsyonu kullanmaktadır. Gradyan tabanlı geri yayılım aracılığıyla yanlı kaynakları tespit eden çalışma, uyumlu bir tıbbi yapay zeka uygulamasını destekleyen olumlu deneysel metrikler sunmaktadır.
Bu içeriği görüntülemek için JoVE aboneliğiniz gereklidir. Giriş yapın veya ücretsiz denemenizi bugün başlatın.
Araştırma makalesi
Graf Sinir Ağlarına Dayalı Tıbbi Yapay Zekada Yasal Bilgi Grafikleri Oluşturma ve Yanlılığı İzleme
Bu makalede
Özet
Özet
Tıbbi yapay zeka (YZ) yasal uyum analizinde bu makale, çok kaynaklı heterojen yasal metinlerin anlamsal parçalanmışlığı ve algoritmik yanlılıkların izlenmesindeki zorlukların neden olduğu sorumluluk belirleme belirsizliğini ele almaktadır. Çalışmada, çizge sinir ağlarına dayalı bir bilgi grafiği oluşturma ve yanlılık yayılım yolu tespit yöntemi kurgulanmıştır. Dört tip heterojen düğüm —yasal maddeler, tıbbi davranışlar, algoritma modülleri ve sorumlu taraflar— yapılandırılıp kodlanmış ve dört tip yasal anlamsal ilişkiye dayalı bir yönlü çizge oluşturulmuştur: "ihlal", "temel", "tetikleyici"ve "atıf"Ardından, çapraz modal hukuk semantiği için çok katmanlı özellik hizalaması sağlamak amacıyla, kenar tipiye özel ağırlıklar ve bir dikkat mekanizması ile birleştirilmiş, ilişki farkındalıklı bir grafik evrişimli ağ kullanılır. Daha sonra, yanlılığa önemli ölçüde katkıda bulunan kenarları belirlemek, bir yanlılık yayılım alt grafiği oluşturmak ve kök düğüm kümelerini konumlandırmak için topluluk keşfi kullanmak amacıyla gradyan tabanlı geri yayılım uygulanır. Son olarak, gerçek zamanlı karar akışları geçici düğümlere eşlenir, uyumluluk gömme benzerliği ile doğrulanır ve sistemik yanlılık birikimine karşı uyarmak için temel kenar ağırlıklarının dinamikleri izlenir. Deneyler, semantik hizalama doğruluğu açısından, önerilen yöntemin farklı bilgi grafiği yoğunluk gradyanlarında en az 0,92 ortalama varlık hizalama doğruluğu ve en az 0,8 ortalama ilişki koruma tamlığı sağladığını göstermektedir. Yanlılık yerelleştirme kapasitesi bakımından ise kök düğüm geri çağırma oranı 0,95'e ulaşmaktadır.±±0,02'dir ve yayılım yolu hassasiyeti 0,93'e ulaşır±±0.03. Bu araştırma, belirli bir ölçüde, hukuki mantık ile algoritmik davranış arasında derin bir etkileşim sağlayarak tıbbi yapay zekanın güvenilir bir şekilde konuşlandırılması için açıklanabilir ve doğrulanabilir bir uyumluluk destek sistemi sunmaktadır.
Giriş
Tıbbi yapay zekanın tanı ve tedavi desteği, kaynak tahsisi ve risk değerlendirmesine derinlemesine katılımı, karar verme süreçlerini yasal sorumluluk varsayımına bağlamıştır1,2. Yasal normlar oldukça yapılandırılmış ancak anlamsal olarak dağıtık durumdadır ve yapay zeka sistemlerinin davranışları, ikisi arasında anlamsal olarak hizalanabilir ve izlenebilir bir arayüz olmaksızın "kara kutu" şeklinde olabilir3. Bu bağlamda, algoritmik davranış dizileri içindeki yasal nedensel zincirleri yakalayan ortak bir temsil çerçevesi geliştirmek, sorumluluğun ayrıntılı bir şekilde atfedilmesi ve dinamik uyumluluğun gerçekleştirilmesi için gerekli bir kolaylaştırıcı olarak ortaya çıkmıştır4,5. Bu çalışma sadece teknoloji sistemlerinin yasal olarak test edilmesiyle ilgili değil, aynı zamanda tıbbi hakkaniyetin, algoritmik adaletin ve kurumsal güvenin derinlemesine sürdürülmesini de kapsamakta olup, bu nedenle büyük teorik öneme ve pratik aciliyete sahiptir.
Günümüzde tıbbi yapay zekanın yasal uygunluk analizindeki temel sorun, yasal semantik ile algoritmik davranış arasında hesaplanabilir bir bağlantı yapısının bulunmamasıdır6,7. Yasal belgeler düz metin olarak sunulmaktadır ve paragraflar arasındaki ilişkiler bağımlılıklar, çatışmalar ve istisnalarla içe geçmiştir; bu durum, belgelerin makineler tarafından yorumlanabilecek mantıksal birimlere ayrılmasında sorunlara yol açmaktadır8,9. Yapay zeka sisteminin karar verme süreci veri odaklı bir kara kutu içinde kapsüllenmiş olduğundan, çıktı varyasyonlarının hiçbiri yasal görevlerdeki belirli ihlallere veya sorumluluk paylaşım düğümlerine izlenememektedir10,1. Bu tür kopukluklar (örneğin, eğitim verisi yanlılığı, model tasarım hataları veya yasal normların semantik yorumu), yanlılığın kaynağını belirlemek veya geliştiriciler, uygulayıcılar veya kullanıcılar için yasal görevleri netleştirmek amacıyla deneysel olarak izole edilememektedir12,13. Daha da sorunlu olanı, mevcut uygunluk prosedürlerinin, "huk-teknoloji" etkileşim ağındaki yanlılığın yayılma yolunu veya güçlenmesini dikkate almadan, yalnızca nihai çıktının sabit bir spesifikasyonu karşılayıp karşılamadığını kontrol etmesidir14,15. Tıbbi yapay zeka eş zamanlı olarak birden fazla yasal hükme tabi olduğunda ve sistem bir maddenin yanlış yorumlanması nedeniyle bir hata zinciri oluşturduğunda, geleneksel yaklaşımlar hatanın diğer ilgili hükümler aracılığıyla nasıl yayıldığını ve ardından sorumluluğa nasıl ulaştığını izleyememektedir16,17. Ek olarak, gerçek zamanlı karar akışı ile mevcut hukuk bilgi grafiği arasında dinamik bir korelasyon mekanizmasının eksikliği, sistem çalışması sırasında uygunluk değerlendirmesinin gecikmesine neden olmakta ve böylece yanlılık birikim eğiliminin proaktif olarak izlenmesini engellemektedir18,19. Tüm bu sorunlar birlikte; sorumluluk tespitinde belirsizliğe, kırılgan atıflara ve gecikmiş düzenleyici müdahalelere yol açarak, yüksek riskli sağlık hizmetleri yapay zeka sistemlerinin güvenilir şekilde konuşlandırılmasını ve yasal hesap verebilirliğin uygulanmasını önemli ölçüde engellemektedir.
Hepsinden önemlisi, geleneksel araştırmalar yasal metinleri yapılandırılmış bir formda inceler ve uyumluluk soruları ile yanıtlarını veya risk bildirimlerini desteklemek amacıyla ontolojiler veya kurallar ile belirli alanların bilgi tabanlarını oluşturur20,21. Bu yaklaşımlar bazı yasal kavramların temsillerini yakalayabilse de, hukukun iç mantığını tutarlı ve statik varsayma eğilimindedirler; bu da yargı yetki alanları arasındaki tutarsızlıklar, istisnalar veya belirsiz ifadelerle başa çıkmayı zorlaştırır. Sonraki çalışmalar, yasal varlıkları ve ilişkileri çıkarmak için önceden eğitilmiş dil modellerini kullanan doğal dil işleme teknolojisini getirerek bilgi çıkarım kapsamının genişliğini artırmıştır2,23, ancak yine de yüzeysel bir semantik düzeyde kalmış ve yasal davranışlar ile teknik davranışlar arasında bir eşleme arayüzü kurmayı başaramamıştır. Algoritmik yanlılık yönetimi açısından araştırmalar çoğunlukla hakkaniyet kısıtlamalarının tasarımına odaklanmıştır24,25 ve bunun değerlendirme göstergeleri genellikle demografik değişkenlere dayalıdır, bu da yasal atıf ilkeleriyle uyum eksikliğine yol açmaktadır. Hatta bazı çalışmalar yasal kuralları kısıtlamalar olarak kodlamayı ve bunları model eğitimine yerleştirmeyi denemiştir26,27, ancak kural ifadesinin katılığı ve kaba granülaritesi nedeniyle, bu yaklaşımların karmaşık klinik durumlara uyarlanması zordur. Genel olarak, mevcut çalışmalar yasal uyumluluğu, sistem mimarisinin içsel ve hesaplanabilir bir özelliği yerine harici bir doğrulama görevi olarak ele almaktadır. Bu durum, yasal mantık ve algoritmik mantığın paralel çalışmasına neden olmakta, yanlılık yayılım yolları üzerinde ortak akıl yürütmeyi ve dinamik müdahaleyi desteklememektedir.
Son yıllarda, ilişkisel yapıları açıkça modelleme yetenekleri nedeniyle graf sinir ağları tıp alanına kademeli olarak dahil edilmiştir28,29. Bazı çalışmalar; içtihatları, yasal hükümleri ve taraf bilgilerini entegre etmek için heterojen graflar kullanarak düğüm gömmeleri aracılığıyla dava önerilerini veya ceza öngörülerini desteklemekte30,31, böylece graf yapılarının hukuki bağlantıları yakalamadaki etkinliğini doğrulamaktadır. Diğer çalışmalar ise hata yayılımını izlemek için kenarları veri akışlarını veya çağrı ilişkilerini temsil edecek şekilde kullanarak algoritmik bileşenleri graf düğümleri olarak soyutlamaktadır32,3. Bu keşifler, graf yapılarının hukuki ve teknolojik unsurların ortak bir taşıyıcısı olarak hizmet edebileceğini göstermektedir. Ancak mevcut graf modelleri genellikle üç sınırlamadan muzdariptir: birincisi, tek bir kenar ilişkisi türüyle sınırlı olduklarından, hukuki semantikteki normatif, nedensel ve atıfsal farklılıkları ayırt edememektedirler; ikincisi, özellik toplama süreci kenar türlerinin semantik ağırlıklarını göz ardı etmekte ve bu durum farklı hukuki mantık yollarının eşit şekilde ele alınmasına yol açmaktadır; üçüncüsü ise yanlılık yayılımı için türevlenebilir bir izleme mekanizmasından yoksun olduklarından, yüksek katkılı kenarların konumlandırılması ve sorumluluk yollarının yeniden oluşturulması imkansız hale gelmektedir. Bu makale, her bir hukuki semantik kenar türüne özel bir dönüşüm matrisi atayarak ve türler arası bilgi akışını dinamik olarak ayarlamak için bir dikkat mekanizması getirerek semantik heterojenite füzyonu sorununu çözen ilişki duyarlı bir graf evrişimli ağ oluşturmaktadır. Ayrıca, gradyan geri yayılımı ve alt graf çıkarımını birleştirerek, yalnızca statik akıl yürütmeyi destekleyen geleneksel graf modellerinin darboğazını aşmakta ve makro düzeydeki uyumluluk yargısından mikro düzeydeki yanlılık izlemeye yorumlanabilir bir geçiş sağlamaktadır.
Tıbbi alanın ötesinde, graf tabanlı ve evrimsel yöntemlerdeki son gelişmeler, yapılandırılmış bilgi işlemeye yönelik geniş bir uygulanabilirlik göstermiştir. Örneğin, Xue ve ark., ontoloji eşleştirmede adaptif benzerlik öznitelik inşası için çok katmanlı hibrit bir genetik programlama yaklaşımı önermiş ve heterojen bilgi grafları arasında sağlam bir hizalama sağlamıştır34. Cheng ve ark., görüntü restorasyonunda graf konvolüsyonel ağ uygulamalarına ilişkin kapsamlı bir inceleme sunarak gürültü giderme, süper çözünürlük ve bulanıklık giderme yöntemlerini sistematik olarak kategorize etmiştir35. Li ve ark., otomatik makine öğrenimi perspektifinden evrimsel derin öğrenme üzerine; ilkeleri, algoritmaları, uygulamaları ve açık zorlukları kapsayan detaylı bir inceleme sunmuştur36. Ma ve ark., belirsizlik altında hata tanıma için bulanık bir sinirsel mimari arama çerçevesi geliştirmiş ve evrimsel aramanın belirsiz verileri işlemedeki etkinliğini kanıtlamıştır37. Bu çalışmalar, karmaşık karar verme görevleri için graf yapılandırmalı temsillerin ve evrimsel optimizasyonun entegrasyon potansiyelini vurgulamaktadır.
Bu makalenin temel amacı, üç düzeyde inovasyonla tıbbi yapay zekanın yasal uyumluluk analizi için uçtan uca yorumlanabilir bir çerçeve oluşturmaktır. Bilgi temsili düzeyinde; yasal maddeleri, tıbbi uygulamaları, algoritma modüllerini ve sorumlu tarafları dört tip heterojen düğüm olarak modelleyen ilk çalışmadır. Yasal uygulamalara dayanarak; "ihlal", "dayanak", "tetikleyici" ve "atıf" olmak üzere dört tip yönlendirilmiş ilişki çıkararak, yasal nedensel mantığa sahip yönlendirilmiş bir bilgi grafiği oluşturmakta ve uyumluluk analizi için yapılandırılmış bir semantik temel sağlamaktadır. Yanlılığın kaynak izleme aşamasında ise, gradyan hassasiyetine dayalı bir kenar katkısı nicelleştirme yöntemi önermektedir. Geri yayılım yoluyla çıktı yanlılığını maksimize eden kenar kümesini belirlemekte, ardından yüksek katkılı düğümleri kümelemek için bir topluluk keşif algoritması uygulayarak "kara kutu yanlılığını" "beyaz kutu sorumluluk kümelerine" dönüştürmekte ve böylece atıf işlemini işletilebilir bir kanıt zincirine dayandırmaktadır. Gerçek zamanlı dinamik izleme düzeyinde ise, gerçek zamanlı yapay zeka çıktılarını bilgi grafiği uzayına eşleyen geçici bir karar-düğüm gömme mekanizması geliştirmektedir. Gömme yakınlığı karşılaştırmasına dayanarak, norm sapma derecesini nicelleştirmekte ve sistematik yanlılığın birikimini işaret etmek amacıyla temel yasal-teknik kenarların ağırlık değişimini izlemektedir. Bu paradigma, hem semantik parçalanma hem de izlenebilirlik çıkmazlarını çözmekte ve yasal uyumluluğu ex post doğrulamadan ex ante yönetişime dönüştürerek, yüksek riskli yapay zeka sistemlerinde sorumluluğun şeffaflığı için ölçeklenebilir teknik bir yol sunmaktadır.
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Protokol
Tıbbi yapay zeka hukuk bilgi grafiği için graf sinir ağının kurulumu
Şekil 1'de gösterildiği gibi, önerilen çerçeve üç ana modülden oluşmaktadır. Giriş katmanı, çok modlu varlık kodlama ve yönlendirilmiş kenar modellemesi aracılığıyla çok kaynaklı verileri heterojen bir grafta bütünleştirir. İlişki farkındalıklı GCN katmanı daha sonra türe özgü ağırlıklar ve dikkat mekanizması ile modlar arası semantik hizalama gerçekleştirerek birleştirilmiş düğüm gömmeleri üretir. Son olarak, bu gömmeler ön yargı izleme (gradyan geri yayılımı ve topluluk tespiti aracılığıyla) ve dinamik uyumluluk izleme (gerçek zamanlı düğüm eşleme ve kenar ağırlığı takibi aracılığıyla) süreçlerini destekleyerek düzenleyiciler için yorumlanabilir atıf kanıtları ve risk uyarıları sunan çıktıları sağlar.
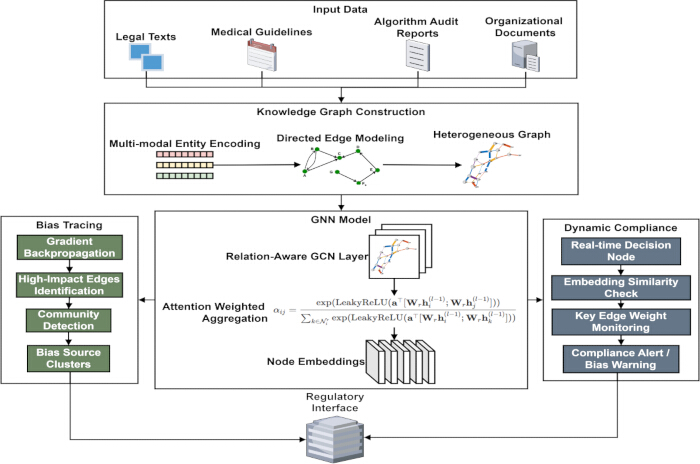
Şekil 1: Tıbbi yapay zeka için yasal bilgi grafiği ve yanlılık izleme mimarisi. Bu diyagram, önerilen çerçevenin genel iş akışını göstermektedir. Giriş katmanı, çok kaynaklı heterojen verileri (yasal metinler, klinik kılavuzlar, algoritma denetim raporları) birleştirir; bu veriler dört varlık türüne (yasal maddeler, tıbbi davranışlar, algoritma modülleri, sorumlu taraflar) kodlanır ve dört yönlü yasal-semantik ilişkiyle (ihlal, dayanak, tetikleyici, atıf) birbirine bağlanır. İlişki duyarlı GCN katmanı, türe özgü ağırlıklar ve dikkat mekanizması aracılığıyla çapraz modal semantik hizalama gerçekleştirir. Yanlılık izleme modülü, yüksek katkılı kenarları belirlemek için gradyan geriye yayılımını kullanır ve ardından kök düğüm kümelerini konumlandırmak için topluluk tespiti uygular. Dinamik uyumluluk izleyicisi, gerçek zamanlı kararları geçici düğümlere eşler, yasal maddelere karşı gömme benzerliğini değerlendirir ve erken uyarı için kenar ağırlığı gelişimini takip eder. Çıktılar, yorumlanabilir atıf kanıtlarını ve risk uyarılarını içerir. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
Yasal varlıkların ve ilişkilerin heterojen grafik yapılı kodlaması
Tıbbi yapay zeka düzenleme yasalarından, klinik uygulama kılavuzlarından ve algoritma denetim raporlarından tutarlı bir şekilde dört temel varlık türetilmiştir: yasal maddeler, tıbbi prosedürler, algoritma modülleri ve sorumlu varlıklar. Her bir varlık türünün anlamsal olarak ayırt edilebilmesi için ayrı bir özellik temsil öğrenme modeli önerilmiştir. Yasal madde düğümleri, yasal maddenin numarasını içerecek şekilde düzenlenmiş olup bu numara, yasal madde için benzersiz bir kimlik (ID) olarak kullanılmıştır. Aynı zamanda, maddeyle ilişkili yasal sorumluluk düzeyini belirtmek için bir ceza şiddeti nicelleştirme indeksi tanımlanmış ve sonuç olarak bir özellik vektörü oluşturulmuştur.
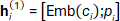 (1)
ci giriş numarasını, Emb(·) düşük boyutlu gömme eşleşmesini ve [·;·] vektör birleştirme işlemini temsil eder. Bu temsil, yasal metnin hem biçimsel yapısını hem de cezanın ağırlığını koruyarak ifadeler arası akıl yürütmeyi destekler.
Tıbbi davranış düğümleri, klinik operasyon sınıflandırma sistemine göre standartlaştırılmış ve kodlanmıştır; bu sayede risk seviyeleri rj ∈ {1,2,3} ve uygulanabilir senaryo etiketleri kümesi sj ⊂ S (burada S önceden tanımlanmış senaryo kategorilerinin tam kümesidir) çıkarılmaktadır. Etiket kümesini işlemek için multi-hot kodlama kullanılmış ve bu, başlangıç temsilini oluşturmak üzere risk seviyesi gömülmesi (embedding) ile birleştirilmiştir:
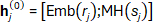 (2)
Bu strateji, farklı tıbbi davranış türlerinin vektör uzayında ölçülebilir mesafe ilişkilerine sahip olmasını sağlayarak senaryolar arası karşılaştırmaları destekler. Metin gömme fonksiyonu Emb(·), çıktı boyutu 768 olarak sabitlenmiş, önceden eğitilmiş Çince hukuk dili modeli Lawformer (geniş ölçekli bir Çince hukuk derlemi üzerinde ön eğitilmiş) kullanılarak uygulanmıştır.
Varlıklar arasındaki mantıksal bağımlılıklara ve yasal kısıtlamalara dayanarak, her biri farklı yasal nedensellik modellerine karşılık gelen "ihlal", "dayanak", "tetikleyici" ve "atıf" olmak üzere dört tip yönlendirilmiş semantik ilişki tanımlanmıştır. İlişki farkındalığı için gerçekleştirilecek sonraki mesaj iletimi amacıyla, her eij ⊂ E kenarına tij ⊂ T = {violate, base, trigger, attribute} kümesinden bir etiket türü atanır. Kenar oluşturma süreci kesin olarak alan kuralı eşleştirme mekanizmasını takip eder: Tıbbi bir davranış normatif gerekliliklerden saptığında, davranış düğümünden ilgili yasal maddeye doğru bir "ihlal" kenarı oluşturulur; yasal madde bir operasyon için teknik uyum dayanağı olduğunda bir "dayanak" kenarı oluşturulur; algoritma modülünün çıktısı belirli bir tıbbi davranışın yürütülmesini doğrudan tetikliyorsa bir "tetikleyici" kenarı bağlanır; sorumluluğun atfedilmesi ilişkisi ise kurumun sorumluluk belgelerine ve denetim sonuçlarına dayalı olarak, sorumlu taraf ile ihlal veya algoritma kusuru arasında bir "atıf" kenarı oluşturularak kurulur.
Tüm düğümler başlatıldıktan sonra, V düğüm kümesi, E tip etiketli yönlendirilmiş kenarlar kümesi ve H0 başlangıç özellik matrisi olmak üzere heterojen bir grafik (V, E, H0) oluşturulur. Grafik yapısının semantik ayırt etme yeteneğini artırmak için düğüm özellikleri normalize edilir:
 (3)
μk ve σk ...'nın ortalaması ve standart sapmasıdır ksırasıyla eğitim setindeki n. düğüm özelliği olup, ∈ sıfıra bölünmeyi önlemek için kullanılan küçük bir sabittir. Normalizasyon, çok kaynaklı heterojen özelliklerin grafik konvolüsyon işlemlerine tek tip bir ölçekte katılmasını sağlayarak, sayısal baskınlık etkilerinin semantik öğrenmeyi engellemesini önler. Ortaya çıkan yapılandırılmış grafik modeli, tıbbi yapay zeka sistemindeki hukuk, davranış, teknoloji ve sorumluluk şeklindeki dört boyutlu öğelerin ilişkisel topolojisini tam olarak taşıyarak, sonraki yanlılık yayılım analizi için hesaplanabilir bir grafik temeli sağlar.
Çapraz modal yasal semantikler için grafik konvolüsyon hizalama iyileştirmesi
Relational Graph Convolutional Network (R-GCN) çerçevesini genişleten, ilişki duyarlı bir grafik evrişimli ağ38,39, başlangıçtaki heterojen grafiğin birden fazla katmanı boyunca özellikleri yaymak için kullanılır. R-GCN, genel ilişkisel veriler için ilişki başına dönüşüm matrisleri sunarken; bizim yaklaşımımız, komşu katkılarını dinamik olarak ağırlıklandırmak için öğrenilebilir bir dikkat mekanizmasını entegre eder ve tıbbi yapay zeka uyumluluk analizine uygun dört özel yasal-semantik ilişki türü (ihlal, temel, tetikleyici, atıf) tanımlar. Her katmanın işlemi, kenarların semantik türüne bağlı olarak dönüşüm sürecini bağımsız olarak parametreleştirir. Herhangi bir hedef düğüm için, komşuluk bilgileri bağlayan kenarların türlerine göre gruplandırılır ve toplanır. Farklı yasal semantik yollar boyunca iletilen özellikleri ayırt etmek için her ilişki türü, özel bir doğrusal dönüşüm matrisi ile donatılmıştır40,41. Eğer yasal madde düğümü ile tıbbi davranış düğümü arasındaki kenar "temel" türündeyse, yasal madde düğümü bir tıbbi davranış düğümünden mesaj aldığında, komşunun özelliklerini uzamsal olarak eşlemek için ilgili ağırlık matrisini uygular. Aynı şekilde, bir tıbbi davranış düğümü, kenar entegrasyon şeması modül düğümü "tetikleyici" aracılığıyla bir algoritma modülüne çıktı gönderdiğinde, bu ilişkiyle ilişkili olan parametre matrisi tetiklenir ve özellik dönüşümünü gerçekleştirir. Bu durum, farklı yasal mantık türlerinin akışkanlığını taklit ederek, bilgi akışı sırasında çapraz modal gürültü olmadan semantik bağımsızlığı korumak için farklı mantık katmanlarını gerçekleştirir/bilgilendirir. Toplama işlemi şu şekilde tanımlanmıştır:
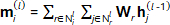 (4)
mi(l), l katmanındaki i düğümü tarafından toplanan kapsamlı bilgiyi, Nil, r ilişkisi altındaki komşu setini, Wr, doğrusal dönüşüm matrisini ve hj(l−1) ise önceki katmandaki komşu düğümün gömme temsilini ifade eder.
Mesaj agregasyonu sırasında, farklı komşu düğümlerin hedef düğüm temsil güncellemesi üzerindeki etki yoğunluğunu dinamik olarak ayarlamak için öğrenilebilir bir dikkat mekanizması tanıtılmıştır42,43. Dikkat katsayısı, sabit ön ağırlıklara dayanmaksızın, düğüm öznitelik benzerliği ve yasal önem şeklindeki çift faktöre göre oluşturulur. Yasal madde düğümleri için, komşu tıbbi davranış özellikleri alındığında, dikkat puanı söz konusu davranışla ilişkili ceza yoğunluğunun nicelleştirilmiş değerine göre hesaplanır; algoritma modülü düğümü tıbbi davranış bilgilerini birleştirdiğinde, daha yüksek operasyonel risk seviyelerine sahip komşulara odaklanır. Dikkat ağırlığı şu şekilde hesaplanır:
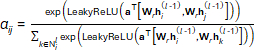 (5)
αij, düğüm j'nin düğüm i'ye olan dikkat katsayısıdır ve a öğrenilebilir dikkat vektörüdür. Bu model, uçtan uca eğitim sırasında yüksek riskli veya yüksek kısıtlamalı bağlantılı yolların otomatik olarak tanımlanmasına ve bunlara daha yüksek dikkat atanmasına olanak tanır. Nihai güncellenmiş düğüm gömmelemesi, ağırlıklı mesajlar ve artık bağlantılar tarafından belirlenir.
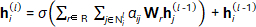 (6)
σ aktivasyon fonksiyonudur ve rezidüel tasarım, derin yayılımdaki gradyan kaybolması problemini hafifleterek çoklu semantik çatışmalar durumunda stabilite sağlar. L = 3 graf konvolüsyonel katmanı (her biri 256 gizli boyuta ve ReLU aktivasyonuna sahiptir) sonrasında, tüm düğümlerin gömme vektörleri çapraz modlu bağlamsal bilgileri sorunsuz bir şekilde bünyesine katar ve yasal semantik ayırt etme yeteneklerine sahip birleştirilmiş temsillere dönüşür.
Sağlık hizmetleri yapay zekası için iki alternatif yasal uyumluluk analiz diyagramı, yasal ilişki türlerinin ve yanlılığın yayılma yollarının görselleştirilmesi amacıyla Şekil 2'de gösterilmekte olup, bu karar verme sürecinin potansiyel yanlılık kaynaklarını belirtmektedir. Şekil 2A, dört ilişki türünün renklerle kodlandığı ve her tür için kenarların farklı bir renkle ayırt edildiği çeşitli yasal semantik ilişkilerin etkisini göstermektedir. Kenarın kalınlığı, söz konusu ilişkinin dikkat ağırlığına, yani bu ilişkinin yapay zeka kararına ne kadar katkı sağladığına karşılık gelir. Kalın bir kenar, esasen karardaki baskın bir yasal ilişkiyi belirtir ve bu durumda davanın sonucunu yeterince gerekçelendirmiştir. Düğüm boyutu, ihlallere olan katkısıyla ölçülür: daha büyük düğümler, davranış ile belirli yasal maddeler arasında daha güçlü bir ilişkiyi ve dolayısıyla daha yüksek potansiyel riski ifade eder. Yukarıdaki görselleştirme, yapay zeka karar verme sürecindeki en güçlü ve en riskli yasal yolları belirlememizi sağlayan net bir yasal semantik katman sunar. Şekil 2B ayrıca, karar verme sürecinde kalınlaştırılmış ve kesikli çizgilerle (örneğin B1-B3) desteklenen yüksek katkılı kenarlara vurgu yaparak, (yanlılık yayılımına) yüksek katkı sağlayan yolları belirtmektedir. Bu kenarların genişliğinin iki katına çıkması, sistemik yanlılığın yayılmasındaki önemlerini temsil eder. Hangi yasal kural ve teknik davranış kombinasyonlarının yanlılık için bu amplifikasyon etkisine yol açtığı Şekil 2'de gösterilmektedir. Bu analiz, sadece yanlılık yayılım yolunu ortaya çıkarmakla kalmaz, aynı zamanda yanlılığın kaynağının belirlenmesini kolaylaştırarak, buna bağlı olarak uyumluluk denetiminin ve yapay zeka aracının sorumluluğunun tespit edilmesini sağlar.
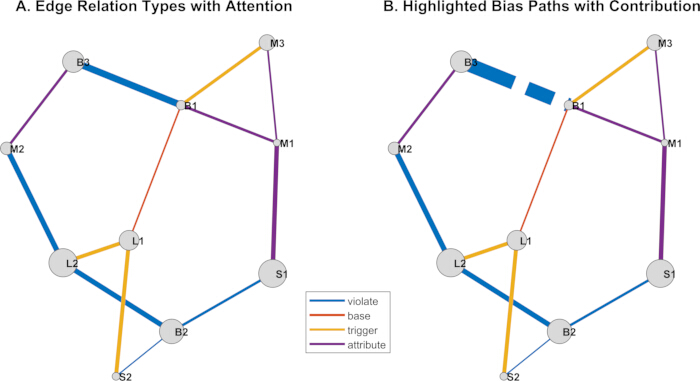
Şekil 2: Sağlık hizmetleri yapay zekasında yasal uyum ve yanlılık yayılımının analizi (Örnekleme). (A) Renklerle kodlanmış yasal semantik ilişkiler: ihlal (kırmızı), temel (mavi), tetikleyici (yeşil), atıf (turuncu). Kenar kalınlığı dikkat ağırlığı ile orantılıdır ve her bir ilişkinin yapay zeka kararı üzerindeki etkisini gösterir. Düğüm boyutu, ihlal katkısı ile orantılıdır ve riskli varlıkları vurgular. (B) Yanlılık yayılım alt grafiği: yüksek katkılı kenarlar kalın ve kesikli çizgilerle gösterilmiştir (örneğin, B1‑B3); çift genişlikteki kenarlar sistemik yanlılığın güçlenmesini belirtir. Bu görselleştirme, baskın yasal yolların, yanlılık kaynaklarının ve uyum denetiminin belirlenmesini destekler. Bu bir şematik çizim olduğu için herhangi bir ölçüm ölçeği veya hata çubuğu uygulanmamıştır. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
Yanlılık yayılım yolu için alt graf geri izleme mekanizması
Bu çalışmada "yanlılık" (bias), bir yapay zeka sisteminin çıktısının klinik ve yasal olarak beklenen karardan sistematik olarak sapması şeklinde tanımlanmış olup, modelin öngördüğü risk puanı ile temel gerçek uyumluluk etiketi arasındaki farkla ölçülmektedir. Yanlılık sinyali, algoritmanın nihai çıktısı ile uyumluluğun ikili göstergesi (uyumlu için 1, uyumsuz için 0) arasındaki çapraz entropi kaybı olarak hesaplanmakta ve bir gruptaki tüm karar örnekleri üzerinden toplanmaktadır.
Graf sinir ağı eğitildikten sonra, çıkış katmanındaki yanlılık sinyali üzerinde geri yayılım analizi gerçekleştirmek için ağın türevlenebilirliği kullanılır. Anomalileri tespit eden algoritma karar düğümünden başlayarak, her bir bağlantılı kenarın yanlılık oluşumuna olan katkısını nicelleştirmek için kayıp fonksiyonunun her bir kenara göre gradyan büyüklüğü hesaplanır. Bu işlem, nihai çıktı değişimindeki her bir kenar parametre dönüşümünün etki gücünü elde etmek için graf yapısındaki yönlendirilmiş kenarlar boyunca katman katman geriye gidilerek bir otomatik türevleme çerçevesi aracılığıyla uygulanır. Gradyanın mutlak değeri ne kadar yüksekse, o kenarın taşıdığı hukuksal-teknik ilişki yanlılık yayılımında o kadar baskındır. Bir kenarın katkısı şu şekilde tanımlanır:
 (7)
Lbias, yanlı davranış için tanımlanmış türetilebilir kayıp ve wi, kenar tipine karşılık gelen giriş ağırlık vektörüdür. Bu gradyan değeri, belirli bir semantik ilişkinin mevcut ilişkilendirme yanlılığına katılım derecesini yansıtır. Tüm kenarlar bu şekilde puanlandıktan sonra, katkısı gij > τ değerini aşan yüksek katkılı kenarlar kümesini Ehigh filtrelemek için dinamik bir eşik τ belirlenir ve başlangıç yanlılık yayılım alt grafiği Gbias = (Vbias, Ehigh) oluşturulur. Özellikle τ, her eğitim dönemindeki tüm kenarlar genelindeki mutlak gradyan değerlerinin 85. yüzdeliği olarak belirlenerek, alt grafik oluşturma için yalnızca en etkili olan ilk %15'lik kenarların tutulması sağlanır. Bu alt grafik, sistematik yanlılığı yönlendirme olasılığı en yüksek olan temel bağlantı yollarına odaklanarak arama alanını daraltır ve kaynak izleme verimliliğini artırır.
Oluşturulan yanlılık yayılım alt grafı içerisinde, yüksek derecede aynı hizada olan düğüm küme yapılarını belirlemek için spektral kümeleme odaklı bir topluluk tespit algoritması yürütülür. Bu işlem, alt grafın normalize edilmiş Laplace matrisi faktörizasyonuna dayanarak düğüm gömmelerini düşük boyutlu bir spektral uzaya eşler ve fonksiyonel olarak yakından ilişkili olduklarında çapraz türdeki düğümlerin (yasal maddeler ve algoritma modülleri gibi) aynı kümede gruplandırılmasını sağlamak için bu uzayda yoğunluk duyarlı bir kümeleme stratejisi uygular. Tanımlanan her topluluk, potansiyel bir fonksiyonel döngüyü veya sorumluluk toplama birimini temsil eder. Topluluk bölümlendirme sonuçları, aşağıdaki optimizasyon hedefleri tarafından yönlendirilir:
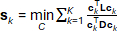 (8)
L=D−A alt grafın Laplacian matrisidir, A bitişikli matrisidir, D derece matrisidir, Ck şunun gösterge vektörüdür k-topluluğu ve K önceden belirlenmiş topluluk sayısıdır. Bu kriter, topluluklar arasındaki minimum kesim farkını maksimize ederek sıkı iç bağlantılar sağlar.
Şimdi, her topluluk üzerinde katmanlar arası kompozit tabanlı analiz gerçekleştirilir. Eğer bir topluluk yasal madde düğümleri ve algoritma modülü düğümleri içeriyorsa, potansiyel bir yanlılık kaynağı olarak etiketlenir. Nedenselliği test etmek için bir müdahale testi yürütülür: bu bölgedeki tüm kenarlar geçici olarak grafikten kaldırılır, aynı karar verme süreci yeniden yürütülür ve yanlılık ölçümlerindeki farklılıklar gözlemlenir. Nedensel geçerlilik ölçütü şu şekilde tanımlanır:
 (9)
Borig ve Bmask sırasıyla orijinal modelin yanlılık gücünü ve maskeleme sonrası yanlılığı temsil eder. Eğer nedensel geçerlilik ölçümü önceden belirlenmiş eşik değerinin önemli ölçüde üzerindeyse, bu durum düğüm kümesinin açıklanabilir bir yanlılık kaynağı olarak tanımlandığı anlamına gelir; bu da daha sonraki uyumluluk düzeltme ve hata atama işlemlerine yön verecektir.
Yasal kısıtlamaların dinamik uyumluluk doğrulaması
Tıbbi bir yapay zeka sisteminin çalışması sırasında ortaya çıkan gerçek zamanlı karar örnekleri, geçici düğümler olarak tanıtılır ve öğrenilmiş bir bilgi grafiği alanına gömülür. Her düğüm, girdi bağlamını, çıktı davranışını ve algoritmanın durumunu okuyarak başlangıç bir öznitelik vektörü üretir. Ardından, bu vektör, tek katmanlı ileri yayılım gerçekleştirmek üzere dondurulmuş parametrelere sahip bir graf sinir ağına beslenir ve orijinal graf yapısını değiştirmeden bilgi grafiği ile uyumlu bir gömme (embedding) üretilir. Böylece, geçici düğümlerin ve yasal madde düğümlerinin ortak bir anlamsal alanda karşılaştırılmasına olanak tanır.
Ardından, geçici düğüm ile her bir yasal madde düğümü arasındaki kosinüs benzerliğini hesaplayın:
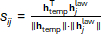 (10)
htemp geçici düğümün gömülmesidir ve hjlaw ise j. yasal madde düğümünün gömülmesidir. Benzerlik değeri, mevcut karar ile her bir yasal kısıtlama arasındaki anlamsal eşleşme derecesini fiilen yansıtır. Farklı uygulama senaryoları altında karar sınırını uyarlamak için, tarihsel uyumluluk örneklerinin benzerlik dağılımına dayalı dinamik bir uyumluluk eşiği θ belirlenir. Spesifik olarak, θ = µ - 2σ olup burada µ ve σ, 500 bilinen uyumlu karar örneğinden oluşan bir doğrulama setinden hesaplanan kosinüs benzerliği dağılımının ortalaması ve standart sapmasıdır.
Bir kosinüs benzerlik puanı dinamik uyumluluk eşiğinin altına düşerse, ilgili hukuk kuralının ihlal edildiği kabul edilir ve bu durum uyumluluk uyarı mekanizmasını tetikler. Bildirim ayrıca, düzenleyicilerin derhal harekete geçmesi için yeterli olması gereken minimum eşleşen yasal madde numarasını, benzerlik değerini ve sapma analizinin yönünü de içerir. Bu yaklaşım, opak karar verme sürecinden yasal semantik alanına yorumlanabilir bir eşleme sağlar ve anlık uyumluluk kontrolünü kolaylaştırır.
Sürekli çalışma sırasında, yanlılık yayılım alt grafiğindeki temel yasal-teknolojik bağlantı kenarlarının ağırlık değişim eğilimi takip edilir. Algoritma modülü düğümlerini ve yasal madde düğümlerini birbirine bağlayan kenarlara, teknik davranışın belirli düzenlemelere verdiği yanıt gücünü doğrudan temsil ettikleri için ağırlık verilir. Çıkarım sırasında her bir hedef kenar için dönüşüm matrisi parametreleri kaydedilir ve normları, ikisi arasındaki korelasyon gücünün evrimine dair dinamik bir gösterge olarak çıkarılır. Kenar gücü dizisi şu şekilde tanımlanır:
 (11)
wt, t zaman damgasındaki eij kenarı arasındaki ilişkiye karşılık gelen ağırlık matrisinin Frobenius normunu temsil eder ve Wkl(t), o sırada modelde gerçekte kullanılan parametre matrisidir. Bu gösterge, modelin öğrenme derinliğini veya yasal kısıtlamaya olan bağımlılığını yansıtır.
Sıralama üzerinde kayan pencere monotonluk testi uygulanır ve anlamlı bir yükseliş trendinin gözlemlenip gözlemlenmediğini belirlemek için geliştirilmiş bir işaret testi kullanılır. Eğer N ardışık zaman adımı boyunca gerçekleşen artışlar pozitif baskınlık koşulunu sağlıyorsa, kenarın anormal bir güçlendirme fenomeni sergilediği kabul edilir. Geçmiş gradyan katkı verileriyle daha fazla birleştirildiğinde, eğer kenar önceki kaynak izleme analizi turunda yüksek etkili bir yol olarak tanımlanmışsa, sistematik sapma birikimi erken uyarı süreci başlatılır.
Son olarak, hedef kenarın her iki ucundaki düğümler hakkındaki bilgileri, ağırlık değişim eğrilerini, ilgili kararların sıklığına ilişkin istatistikleri ve potansiyel atıf önerilerini içeren bir kaynak izleme raporu oluşturulur. Bu mekanizma, statik uyumluluk değerlendirmesinden dinamik risk tahminine geçiş sağlayarak, potansiyel kurumsal sapmalarda proaktif müdahaleyi destekler.
Deneysel veriler ve tasarım
Önerilen çerçevenin etkinliğini doğrulamak için, bu çalışma gerçek düzenlemeler ile simülasyon verilerini entegre eden çok kaynaklı heterojen bir veri seti oluşturmuş ve titiz kontrol deneyleri tasarlamıştır. Veri kaynakları arasında ulusal tıbbi yapay zeka düzenleyici mevzuatları, klinik tedavi kılavuzları, açık kaynaklı algoritma denetim raporları ve simülasyon karar günlükleri yer almaktadır. Ön işlemenin ardından, Şekil 3'te gösterildiği gibi 285 düğüm (85 yasal madde, 120 tıbbi davranış, 42 algoritma modülü ve 38 sorumlu kuruluş) ve 1247 yönlendirilmiş kenar içeren kıyaslama heterojen bilgi grafiği oluşturulmuştur.
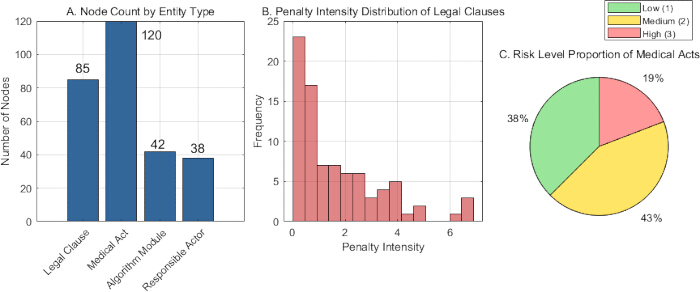
Şekil 3: Heterojen varlık türlerinin dağılımı ve özellikleri. (A) Her bir varlık türü için düğüm sayısını gösteren sütun grafiği: yasal maddeler (85), tıbbi davranışlar (120), algoritma modülleri (42), sorumlu taraflar (38). (B) Yasal madde düğümleri için ceza yoğunluğu histogramı; düşük (0‑0.33), orta (0.34‑0.66) ve yüksek (0.67‑1.0) kategorilere ayrılmıştır; dikey eksen sayıyı temsil etmektedir. (C) Tıbbi davranış düğümleri arasındaki risk düzeyi dağılımının pasta grafiği: düşük (%19), orta (%43), yüksek (%38). Tüm değerler mutlak sayılar veya yüzdelerdir; bunlar veri setinin tanımlayıcı istatistikleri olduğu için hata çubukları sunulmamıştır. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
Şekil 3, heterojen bilgi grafiğindeki varlık düğümlerinin dağılımını ve özelliklerini göstermektedir. Şekil 3A, dört tip varlık düğümünün sayısal dağılımını göstermekte olup, en yüksek sayıya "tıbbi davranış" düğümleri (120), ardından "yasal maddeler" (85) sahipken, "algoritma modülleri" (42) ve "sorumlu varlıklar" (38) nispeten daha az sayıdadır. Bunun nedeni, grafiğin yapısal olarak davranışlar ve kurallar temelinde tasarlanmış olmasıdır. Şekil 3B, tek bir yasal maddeyi temsil eden düğümler için ceza yoğunluklarının dağılımını sunmaktadır; burada yoğunluk, yasal sorumluluğun ciddiyetini ölçer. Veriler, yüksek ceza yoğunluğuna sahip hükümlerin nispeten az olduğunu ve çoğunluğunun orta-düşük yoğunluk aralığında yer aldığını göstermektedir; bu durum, gerçek dünyadaki hukuk sistemlerinde yalnızca birkaç ağır ihlal maddesinin bulunması gerçeğiyle tutarlıdır. Şekil 3C, tıbbi davranış düğümlerindeki risk seviyesi dağılımını göstermektedir; burada orta riskli davranışlar %43 ile en büyük oranı oluştururken, düşük riskli davranışlar %19 ile en düşük oranı oluşturmaktadır; bu durum, tıbbi senaryoların normal şekilde yürütüldüğünü ve yüksek riskli operasyonların grafikte daha sıkı ilişkilendirme kısıtlamalarına tabi tutulduğunu ortaya koymaktadır. Bu istatistikler toplu olarak, sonraki grafik evrişimli hizalama için özellik desteği sağlamak amacıyla bilgi grafiği oluşturulurken benimsenen varlık çözümleme kodlama şemasını gerekçelendirmektedir.
Tüm veri seti; her bir bölünmede genel grafik yapısını korumak amacıyla düğüm türü ve ilişki dağılımına göre tabakalı olarak eğitim (%70), doğrulama (%10) ve test (%20) setlerine rastgele ayrılmıştır. Adil bir karşılaştırma sağlamak için tüm temel yöntemlerde aynı bölünme tutarlı bir şekilde kullanılmıştır. Bu temel bölünmeye ek olarak, yukarıda açıklanan üç bilgi grafiği yoğunluk gradyanı (seyrek, orta, yoğun) ve üç yargı alanı ötesi karmaşıklık ayarı (tekli, ikili, çoklu), yöntemin farklı veri tamlık ve düzenleyici örtüşme koşulları altındaki dayanıklılığını topluca değerlendiren bağımsız pratik test ortamları olarak hizmet etmektedir. Yanlılık lokalizasyon değerlendirmesi için temel gerçek (ground-truth) etiketleri oluşturmak amacıyla iki aşamalı bir strateji benimsenmiştir: (1) Uzman anotasyonu — üç hukuk ve tıp uzmanı, karar günlüklerini bağımsız olarak inceleyerek kaydedilen her bir uyumluluk ihlali için kök neden düğümlerini ve yayılım yollarını belirlemiş, görüş ayrılıkları çoğunluk oyuyla çözülmüştür; (2) Simüle edilmiş enjeksiyon — kontrollü testler için, bilgi grafiğindeki kenar ağırlıkları bozulup rastgele seçilen 20 karar yoluna yapay olarak yanlılık sinyalleri enjekte edilmiş ve böylece gerçek kaynak düğümlerinin ve etkilenen kenarların önceden bilinmesi sağlanmıştır.
Tüm temel yöntemler (TransE, ComplEx, Graph Neural Networks (GNN) Explainer, KG-BERT ve Node2Vec) için, adil bir karşılaştırma sağlamak amacıyla kendi yöntemimizle aynı eğitim konfigürasyonunu (Adam optimize edici, 1 × 10⁻³ öğrenme oranı, 64 grup boyutu, 100 epok) ve aynı veri bölümlerini kullandık. TransE ve ComplEx için gömme boyutu 1,0 kenar payı ile 256 olarak ayarlandı; KG-BERT için 16 grup boyutu ve 128 maksimum dizi uzunluğu ile önceden eğitilmiş BERT-base modelini kullandık; GNNExplainer için 256 aynı gizli boyutuna sahip 3 katmanlı bir GCN kullandık; Node2Vec için ise yürüyüş uzunluğunu 80, düğüm başına yürüyüş sayısını 10 ve gömme boyutunu 256 olarak belirledik.
Adil bir karşılaştırma sağlamak için, tüm temel yöntemleri aynı yanlılık yerelleştirme görevlerine, yani kök-düğüm belirleme ve yayılım-yolu yeniden yapılandırma görevlerine uyarladık. Doğası gereği açıklanabilir olmayan TransE, ComplEx ve Node2Vec için, yanlılık kaybının her bir düğüm gömmesine göre gradyanını hesapladık ve gradyan büyüklüğünü düğüm önem puanı olarak kullandık; kök düğümler bu puanlara eşik değer uygulama yoluyla seçildi ve yayılım yolları, en yüksek gradyan katkısına sahip kenarlar korunarak yeniden yapılandırıldı. GNNExplainer için, hem kök düğümleri hem de alt grafikleri elde etmek amacıyla modelin yerleşik kenar-önemi ve düğüm-maskeleme mekanizmalarını doğrudan kullandık. Üçlüler üzerinden çalışan KG‑BERT için ise, her bir graf kenarını metinsel bir üçlüye dönüştürdük ve düğüm önemini türetmek için modelin varlıklar üzerindeki dikkat ağırlıklarını kullandık, ardından yol yeniden yapılandırması için aynı eşikleme stratejisini uyguladık. Bu uyarlamalar sayesinde, her temel yöntem hem kök-düğüm tahminleri hem de yayılım-yolu tahminleri üretmiş olup, tüm yöntemler arasında tek tip bir değerlendirme yapılmasına olanak sağlamıştır.
Değerlendirme dört temel yetenek etrafında odaklanmaktadır: semantik hizalama doğruluğu, yanlılığı yerelleştirme yeteneği, hesap verebilirlik verimliliği ve alanlar arası genelleme. Ayrıca, gerçek dünya karmaşıklığını taklit eden üç önemli kontrol değişkeni sunmaktadır.
1) Bilgi grafiği yoğunluk gradyanı: Yöntemin farklı bilgi tamamlanma seviyelerinde nasıl performans gösterdiğini değerlendirmek için, temel tam grafikten (yoğunluk D = 1.0) rastgele kenar çıkarma stratejisine dayalı olarak aşağıdaki şekilde iki alt küme oluşturulur:
Seyrek grafik (D ~ 0,3): Kenarların %30'u rastgele korunarak, birçok bilginin eksik olduğu erken bilgi oluşturma aşaması simüle edilmiştir.
Orta yoğunluklu grafik (D ~ 0.6): Kenarların %60'ı rastgele tutulur; bu durum, kısmen bilinen bir bilgi yapısının tipik bir senaryosunu simüle eder.
Yoğun grafik (D = 1.0): Nispeten eksiksiz bilgiye sahip olunan en iyi durum senaryosuna karşılık gelen tüm 1247 kenarın kullanımı.
2) Tıbbi yapay zeka karar sıklığı durumu: Dinamik uyumluluk izlemenin gerçek zamanlı performansını test etmek için üç yapay karar akış yükü ayarlanmıştır:
Düşük frekans 10 Hz: Küçük ölçekli veya tek saha sistemlerinin izlenmesini simüle ederek, saniyede ortalama 10 karar olayı oluşturulur.
Orta frekans 50 Hz: bölgesel veya orta ölçekli tıbbi kurumların yapay zeka sistem yükünü simüle eden saniyede 50 karar olayı.
Yüksek frekans 100 Hz: Saniyedeki 100 karar olayı, büyük bir hastaneye veya bulut platformuna konuşlandırılan yapay zeka hizmetleri için yüksek eşzamanlılık baskısı senaryolarını simüle eder.
3) Yargı alanı ötesi karmaşıklık gradyanı: Yasal kısıtlama modellemesinin aktarılabilirliğini test etmek için karmaşıklık tabanlı üç test seti oluşturulmuştur:
Tek yargı yetkisi: Yalnızca tıbbi yapay zekayı düzenleyen mevcut Çin yasaları ve yönetmeliklerinden oluşur.
İkili yargı yetkisi: Kuralların yaklaşık %15'inin çelişkili ve örtüşen olduğu Çin ve Avrupa Birliği'nin düzenleyici rejimlerini kapsar.
Çok taraflı yargı yetkisi: İlk ikisinin üzerine inşa edilen bu yapı, ABD HIPAA (Health Insurance Portability and Accountability Act) gizlilik ve güvenlik kurallarını da entegre ederek üç farklı hukuk rejiminin yasal sistemlerinin iç içe geçtiği bir test ortamı oluşturur ve kural çatışma oranını yaklaşık %25'e çıkarır.
Kantitatif değerlendirme için aşağıdaki temel göstergeler kullanılmıştır:
1) Semantik hizalama doğruluğu: Grafiğin, hukuki ve teknik varlıklar arasındaki ilişkileri modelleme yeteneğini ölçer.
Varlık hizalama doğruluğu:
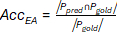 (12)
Ppred, model tarafından tahmin edilen hizalanmış varlık çiftleri kümesi ve Pgold, uzmanlar tarafından açıklanmış altın standart hizalamalar kümesidir.
İlişki koruma bütünlüğü:
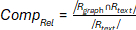 (13)
Rgraph grafikte yeniden oluşturulan ilişkiler kümesi ve Rtext orijinal yasal metinden çıkarılan açık ilişkiler kümesidir.
2) Yanlılık Yerelleştirme Yeteneği: Yanlılığın kök nedenlerinin ve yayılım yollarının izlenmesindeki etkinliğin değerlendirilmesi.
Kök Düğüm Geri Çağırma Oranı:
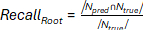 (14)
Npred model tarafından tanımlanan yanlılık kaynak düğümleri kümesi ve Ntrue uzmanlar tarafından etiketlenen gerçek kaynak düğümleri kümesidir.
Yayılım yolu doğruluğu:
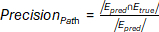 (15)
Epred, model tarafından çıkarılan yanlılık yayılım alt grafiğindeki kenar kümesi ve Etrue gerçek yanlılık yayılım kenar kümesidir.
3) Hesap Verilebilirlik İzleme Verimliliği: Sistemin gerçek zamanlı izleme senaryolarındaki performansını test edin.
Ortalama İzleme Gecikmesi:
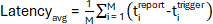 (16)
M toplam istek sayısını temsil eder; titrigger ve tireport ise sırasıyla i. yanlılık tetikleyicisinin ve kaynak raporun oluşturulmasının zaman damgalarıdır.
Sistem verimliliği:
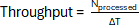 (17)
Nprocessed, ΔT zaman penceresi içinde başarıyla işlenen eşzamanlı izleme isteklerinin sayısını temsil eder.
4) Alanlar arası genelleme yeteneği: Yöntemin farklı hukuk sistemlerine uyarlanabilirliğinin doğrulanması.
Yargı yetkisi kapsamı:
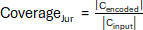 (18)
Cencoded grafiğe başarıyla kodlanan farklı yetki maddelerinin sayısını, Cinput ise toplam giriş maddelerinin sayısını temsil eder.
Kısıtlama çakışması tespit oranı:
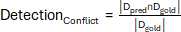 (19)
Dpred, model tarafından tespit edilen yasal mantık çelişkileri kümesi ve Dgold ise uzmanlar tarafından etiketlenmiş tüm çelişki çiftleri kümesidir.
Tüm deneyler, çok çekirdekli bir işlemci ve grafik işlem birimi ile donatılmış bir iş istasyonu kullanılarak gerçekleştirilmiştir; donanım özelliklerinin tamamı Materyaller Tablosunda sunulmuştur.
Bu yaklaşımın temel hiperparametreleri ve değerleri, model yapısı ve eğitim konfigürasyonunun yanı sıra gömme boyutu, evrişimli katman sayısı, öğrenme oranı ve toplu işlem boyutu gibi kritik eşikleri kapsayacak şekilde Tablo 1'de listelenmiştir. Tüm parametreler, ızgara araması yoluyla doğrulama setine göre optimize edilmiş, eğitilen model kararlı bir şekilde yakınsamış ve en iyi performans elde edilmiştir. Bazı eşikler, tıbbi yapay zeka uyumluluk kontrolünün yüksek güvenilirlik gereksinimlerini karşılamak amacıyla alan kriterleriyle birlikte belirlenmiştir.
| Parametre | Değer | Açıklama |
| Gömme Boyutu | 128 | Düğüm gömme işlemleri için öznitelik boyut büyüklüğü |
| Konvolüsyon Katmanı Sayısı | 3 | İlişki duyarlı graf konvolüsyon ağının derinliği |
| Öğrenme Oranı | 0.001 | Adam optimize edicisi için başlangıç öğrenme oranı |
| Grup Boyutu | 32 | Yığın başına işlenen alt grafik sayısı |
| Yıpranma Oranı | 0.1 | Eğitim sırasında düğüm özelliklerine uygulanan dropout olasılığı |
| Dikkat Başlıklarının Sayısı | 8 | Çok başlı dikkat mekanizmasındaki baş sayısı |
| L2 Düzenleme Katsayısı | 5 × 10⁻⁴ | Parametre düzenlemesi için ağırlık azalma katsayısı |
| Benzerlik Eşiği | 0.75 | Uyum doğrulama için minimum gömme benzerliği |
| Gradyan Katkı Eşiği | 0.01 | Yanlılık alt grafik oluşturulmasında yüksek etkili kenarların seçimi için eşik değeri |
| İzleme Penceresi Boyutu | 10 | Kenar ağırlığı dinamiklerini izlemek için kullanılan zaman adımları |
Tablo 1: Ana parametre ayarları. Deneylerde kullanılan temel hiperparametrelerin listesi: gömme boyutu (256), GCN katman sayısı (3), gizli boyut (256), öğrenme oranı (1 × 10⁻³), grup boyutu (64), dikkat vektörü boyutu, kenar katkı eşiği (gradyan büyüklüklerinin 85. yüzdeliği), dinamik uyumluluk eşiği (µ‑2σ; burada µ ve σ, 500 uyumlu örneklikten oluşan doğrulama setinden alınmıştır), topluluk sayısı K (spektral kümeleme ile belirlenmiştir) ve optimize edici (Adam). Bu değerler, doğrulama seti üzerinde ızgara araması (grid search) yoluyla seçilmiştir.
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Sonuçlar
Tıbbi yapay zeka hukuk bilgi grafiğinde yanlılık kaynağı izleme performans doğrulamasu
İlişki duyarlı grafik konvolüsyonunun performansı
İlişki farkındalıklı bir grafik evrişimli ağ eğitilerek, farklı evrişimli katmanlar genelinde yasal maddeler ve tıbbi davranış düğümleri arasındaki gömme benzerlikleri hesaplanmış ve her katmanın hizalama etkisi kaydedilmiştir. İkinci olarak, eğitim sonrası dört yasal semantik ilişkiye atanan dikka...
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Tartışma
Tıbbi yapay zekanın klinik kararlara entegrasyonu, yapılandırılmamış yasal metinler ile kara kutu algoritmalar arasındaki semantik boşluk nedeniyle sorumluluk atama konusunda yasal zorluklar ortaya çıkarmaktadır. Bunu gidermek için; yasal maddeleri, tıbbi davranışları, algoritma modüllerini ve sorumlu tarafları, dört yönlü yasal-semantik ilişki (ihlal, dayanak, tetikleyici, atama) aracılığıyla birbirine bağlanan heterojen düğümler olarak modelleyen GNN tabanlı bir bilgi grafiği önerdik. Bu yapı, modallar arası hizalama v...
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Açıklamalar
Makale daha önce yayınlanmamıştır ve başka bir derginin değerlendirme sürecinde değildir. Yazarların tamamı makalenin içeriğini onaylamıştır. Yazarlar, herhangi bir finansal çıkar çatışması olmadığını beyan ederler.
Malzemeler
| Ad | Şirket | Katalog numarası | Yorumlar |
|---|---|---|---|
| ComplEx | Açık kaynak uygulama (örneğin, OpenKE) | Sürüm 1.0 | Bilgi grafiği karşılaştırması için kompleks gömme temel çizgisi |
| GNNExplainer | Açık kaynak uygulama (https://github.com/RexYing/gnn-explainer) | Commit 7a3b6a2 (2021) | Yanlılık takibi için GNN yorumlanabilirliği temel çizgisi |
| Intel Xeon Gold 6248 (CPU) | Intel Corporation | SRF7F | Model eğitimi ve veri ön işleme için merkezi işlemci |
| KG-BERT | HuggingFace Transformers + BERT-base | BERT-base-uncased (HuggingFace) | Semantik hizalama için Transformer tabanlı KG gömme temel çizgisi |
| Node2Vec | Açık kaynak uygulama (https://github.com/aditya-grover/node2vec) | Sürüm 1.0 | Rastgele yürüyüş tabanlı düğüm gömme temel çizgisi |
| NVIDIA Tesla V10 (GPU) | NVIDIA Corporation | 90-2G50-010-0 | Graf neural network eğitimini hızlandıran yüksek performanslı GPU |
| Bizimki (Relation-aware GCN) | PyTorch'ta özel uygulama | PyTorch 1.12.0 | İlişki başına dönüşümler, dikkat ve gradyan geri izleme içeren önerilen çerçeve |
| TransE | Açık kaynak uygulama (örneğin, OpenKE) | Sürüm 1.0 | Bilgi grafiği karşılaştırması için translasyonel gömme temel çizgisi |
Kaynaklar
- Wang Y, Ma Z. Ethical and legal challenges of medical AI on informed consent: China as an example. Dev World Bioeth. 2025;25(1):46-54.
- Sand M, Durán JM, Jongsma KR. Responsibility beyond design: Physicians' requirements for ethical medical AI. Bioethics. 2022;36(2):162-169.
- Schultz MD, Seele P. Towards AI ethics' institutionalization: knowledge bridges from business ethics to advance organizational AI ethics. AI Ethics. 2023;3(1):99-111.
- Magesh V, et al. Hallucination-Free? Assessing the reliability of leading AI legal research tools. J Empir Leg Stud. 2025;22(2):216-242.
- Patil S, Shankar H. Transforming healthcare: harnessing the power of AI in the modern era. Int J Multidiscip Sci Arts. 2023;2(2):60-70.
- Birkstedt T, Minkkinen M, Tandon A, Mäntymäki M. AI governance: themes, knowledge gaps and future agendas. Internet Res. 2023;33(7):133-167.
- Mohammad Amini M, et al. Artificial intelligence ethics and challenges in healthcare applications: a comprehensive review in the context of the European GDPR mandate. Mach Learn Knowl Extr. 2023;5(3):1023-1035.
- Pasham SD. Opportunities and difficulties of artificial intelligence in medicine existing applications, emerging issues, and solutions. The Metascience. 2023;1(1):67-80.
- Vearrier L, et al. Artificial intelligence in emergency medicine: benefits, risks, and recommendations. J Emerg Med. 2022;62(4):492-499.
- Peng Y, Rousseau JF, Shortliffe EH, Weng C. AI-generated text may have a role in evidence-based medicine. Nat Med. 2023;29(7):1593-1594.
- Alam MN, Kaur M, Kabir MS. Explainable AI in healthcare: enhancing transparency and trust upon legal and ethical consideration. Int Res J Eng Technol. 2023;10(6):1-9.
- Sorantin E, et al. The augmented radiologist: artificial intelligence in the practice of radiology. Pediatr Radiol. 2022;52(11):2074-2086.
- Borger JG, et al. Artificial intelligence takes center stage: exploring the capabilities and implications of ChatGPT and other AI-assisted technologies in scientific research and education. Immunol Cell Biol. 2023;101(10):923-935.
- Chikhaoui E, Alajmi A, Larabi-Marie-Sainte S. Artificial intelligence applications in healthcare sector: ethical and legal challenges. Emerg Sci J. 2022;6(4):717-738.
- Kerasidou CX, Kerasidou A, Buscher M, Wilkinson S. Before and beyond trust: reliance in medical AI. J Med Ethics. 2022;48(11):852-856.
- Polineni TNS, Maguluri KK, Yasmeen Z, Edward A. AI-driven insights into end-of-life decision-making: ethical, legal, and clinical perspectives on leveraging machine learning to improve patient autonomy and palliative care outcomes. Migr Lett. 2022;19(6):1159-1172.
- Galiana LI, Gudino LC, González PM. Ethics and artificial intelligence. Rev Clin Esp (Engl Ed). 2024;224(3):178-186.
- Paladugu PS, et al. Generative adversarial networks in medicine: important considerations for this emerging innovation in artificial intelligence. Ann Biomed Eng. 2023;51(10):2130-2142.
- Harris E. Large language models answer medical questions accurately, but can't match clinicians' knowledge. JAMA. 2023;330(9):792-794.
- İpek ZH, Gözüm AIC, Papadakis S, Kallogiannakis M. Educational applications of the ChatGPT AI system: a systematic review research. Educ Process Int J. 2023;12(3):26-55.
- Kim C, et al. Transparent medical image AI via an image-text foundation model grounded in medical literature. Nat Med. 2024;30(4):1154-1165.
- Wang YH, Lin GY. Exploring AI-healthcare innovation: natural language processing-based patents analysis for technology-driven road mapping. Kybernetes. 2023;52(4):1173-1189.
- Pruneski JA, et al. Natural language processing: using artificial intelligence to understand human language in orthopedics. Knee Surg Sports Traumatol Arthrosc. 2023;31(4):1203-1211.
- Chen RJ, et al. Algorithmic fairness in artificial intelligence for medicine and healthcare. Nat Biomed Eng. 2023;7(6):719-742.
- Yang Y, et al. The limits of fair medical imaging AI in real-world generalization. Nat Med. 2024;30(10):2838-2848.
- Almarshadi NF, et al. Clinical and medical coding: a new pathway for automation—an updated review. J Med Life Sci. 2024;6(4):633-651.
- Osifowokan AS, Agbadamasi TO, Adukpo TK, Mensah N. Regulatory and legal challenges of artificial intelligence in the US healthcare system: liability, compliance, and patient safety. World J Adv Res Rev. 2025;25(3):949-955.
- Hasan MT. Graph neural network models for detecting fraudulent insurance claims in healthcare systems. Am J Adv Technol Eng Solut. 2022;2(01):88-109.
- Johnson R, Li MM, Noori A, Zitnik M. Graph artificial intelligence in medicine. Annu Rev Biomed Data Sci. 2024;7:345-368.
- Lettieri N, Guarino A, Malandrino D, Zaccagnino R. Knowledge mining and social dangerousness assessment in criminal justice: metaheuristic integration of machine learning and graph-based inference. Artif Intell Law. 2023;31(4):653-702.
- Ma Y, et al. Incorporating structural information into legal case retrieval. ACM Trans Inf Syst. 2023;42(2):1-28.
- Jin Z, et al. GNNLens: a visual analytics approach for prediction error diagnosis of graph neural networks. IEEE Trans Vis Comput Graph. 2022;29(6):3024-3038.
- Shen Y, Zhang J, Song SH, Letaief KB. Graph neural networks for wireless communications: from theory to practice. IEEE Trans Wirel Commun. 2022;22(5):3554-3569.
- Xue X, et al. Adaptive similarity feature construction for ontology matching via multi-layer hybrid genetic programming. IEEE Transactions on Evolutionary Computation, 2025;30(2):519-533.
- Cheng T, et al. Graph convolutional network for image restoration: A survey. Mathematics, 2024;12(13): 2020.
- Li N, et al. Survey on evolutionary deep learning: Principles, algorithms, applications, and open issues. ACM Computing Surveys, 2023; 56(2): 1-34.
- Ma L, et al. A novel fuzzy neural network architecture search framework for defect recognition with uncertainties. IEEE Transactions on Fuzzy Systems, 2024; 32(5): 3274-3285.
- Fang Y, et al. Relation-aware graph convolutional networks for multi-relational network alignment. ACM Trans Intell Syst Technol. 2023;14(2):1-23.
- Schlichtkrull M, et al. Modeling relational data with graph convolutional networks//European semantic web conference. Cham: Springer International Publishing, 2018; 593-607.
- Ariai F, Mackenzie J, Demartini G. Natural language processing for the legal domain: a survey of tasks, datasets, models, and challenges. ACM Comput Surv. 2025;58(6):1-37.
- Xu Y, et al. BNet: batch normalization with enhanced linear transformation. IEEE Trans Pattern Anal Mach Intell. 2023;45(7):9225-9232.
- Guo MH, et al. Attention mechanisms in computer vision: a survey. Comput Vis Media. 2022;8(3):331-368.
- Guo MH, et al. Visual attention network. Comput Vis Media. 2023;9(4):733-752.
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.