Bu araştırma çalışması; veri artırma, ön işleme ve hibrit model özelleştirmesi (ara Füzyon) kullanarak, beş adet halka açık veri setinde beyin tümörlerinin sınıflandırılması için DenseNet121 ve EfficientNetB7'nin özellik füzyon kabiliyetlerini zenginleştiren FusionNetX adlı bir yaklaşım sunmuş; birden fazla değerlendirme parametresinde üstün performans göstererek %98,77 ile %99,89 arasında sonuçlar elde etmiştir.
Bu içeriği görüntülemek için JoVE aboneliğiniz gereklidir. Giriş yapın veya ücretsiz denemenizi bugün başlatın.
Yöntem makalesi
FusionNetX: Geliştirilmiş Beyin Tümörü Tespiti için MRI ve Derin Öğrenmeden Yararlanan Bir Derin Özellik Füzyon Modeli
Bu makalede
Özet
Özet
Beyin tümörleri, dünyadaki en ölümcül hastalıklardan biri olarak kabul edilmektedir ve bunların yanlış teşhis edilmesi hastaların hayatını tehlikeye atarak sağkalım oranını düşürmektedir. Derin öğrenme tabanlı tekniklerle, özellikle evrişimli sinir ağlarıyla desteklenen manyetik rezonans görüntüleme (MRI), beynin iç yapısının daha detaylı incelenmesine olanak tanıması, olağanüstü öğrenme ve öngörü yetenekleri sunması nedeniyle bu engelin aşılmasında kritik öneme sahiptir. Beyindeki tümörlerin doğru teşhis edilmesine yönelik ihtiyaç hâlâ önemini korumaktadır. Bu nedenle, eğitilebilir ve eğitilemez katmanlar dahil olmak üzere özelleştirilmiş ince ayar hiperparametrelerini kullanarak, önceden eğitilmiş iki model olan DenseNet121 ve EfficientNetB7'nin güçlü yönlerinden yararlanan, geliştirilmiş özellik füzyonu tabanlı bir DL modeli (FusionNetX) önerilmiştir. Önerilen FusionNetX modeli; Br35H, Figshare, Sartaj, Masoud ve Balanced Brain Tumor olmak üzere kamuya açık beş beyin tümörü veri seti üzerinde uygulanmıştır. Görüntü kalitesini artırmak ve yeniden boyutlandırma ile veri artırımı yoluyla aşırı öğrenmeyi (overfitting) önlemek için bazı ön işleme adımları uygulanmıştır. Doğruluk, kayıp, pozitif öngörü değeri, negatif öngörü değeri, gerçek pozitif oranı, gerçek negatif oranı, F1-skoru, yanlış negatif oranı ve yanlış pozitif oranı gibi çeşitli performans değerlendirme metrikleri kullanılarak, önerilen FusionNetX modelinin doğruluğunun Br35H için %99,33, Figshare için %99,13, Masoud için %99,89, BBT-Dataset için %99,19 ve Sartaj için %98,77 olduğu bulunmuştur. Ayrıca, önerilen FusionNetX modelinin önemini göstermek için beş beyin tümörü veri seti geç füzyon ve dikkat tabanlı füzyon kullanılarak değerlendirilmiş ve tüm veri setlerinde %0,3 ile %1,9 arasında artışlarla sonuçların önemli ölçüde daha iyi olduğu görülmüştür. Dahası, alıcı işletim karakteristik eğrisi hesaplanmış ve çeşitli performans değerlendirme metriklerinden elde edilen sonuçlar, önerilen FusionNetX modelinin beyin tümörlerini doğru şekilde tespit edip öngörebildiğini ve sağlık çalışanlarının zamanında karar vermesine yardımcı olabileceğini göstermiştir.
Giriş
Kanser, şiddeti ve büyüme hızı nedeniyle günümüzde insan vücudundaki en ölümcül hastalıktır; beyin tümörleri, meme kanseri, akciğer nodülleri, böbrek kanseri ve diğerleri gibi çok sayıda kanserli hastalığın insan vücudunda görülmesi ölüm oranlarının artmasına neden olmaktadır. Kanser, kişinin vücudundaki hücrelerin veya dokuların anormal şekilde çoğalmasıyla gelişir. Kanser metastaz yaptığında, diğer insan organlarına zarar verebilir ve daha tehlikeli hale gelebilir1. Beyin tüm vücut fonksiyonlarını kontrol ettiği için, ona verilen herhangi bir zarar tüm vücut üzerinde geniş kapsamlı sonuçlar doğurabilir. Bu nedenle beyin tümörleri veya kanseri insanlar için oldukça ölümcüldür2. Ek olarak, beyin tümörleri temel olarak benign (iyi huylu) ve malign (kötü huylu) olmak üzere iki ana kategoriye ayrılır. "Benign" temel olarak kanserli olmadığı anlamına gelir; bu yalnızca çevre şartları değiştirilerek düzeltilebilen bir beyin sorunudur. Ancak malignite durumunda, metastatik doğası nedeniyle tehlikeli kabul edilir; çünkü anormal hücrelerin veya dokuların vücudun diğer bölgelerine taşınması veya buralardan gelmesi, kanserin vücuttaki yayılım şansını artırarak diğer organları da bozar3.
Ayrıca, Amerikan Beyin Tümörleri Derneği ve Dünya Sağlık Örgütü'ne (WHO) göre hipofiz tümörleri, meningiomlar ve gliomlar, beyin kanserlerinin üç ana kategorisidir4. Gliomlar, beyindeki nöronları besleyen glial hücrelerden köken alır. Hipofiz tümörleri, beynin tabanında yer alan ve çeşitli vücut fonksiyonlarından sorumlu olan hipofiz bezinde başlar; meningiom tümörleri ise beyni ve omuriliği çevreleyen zarları koruyan meningeslerde başlar. Ayrıca, tanısal amaçlarla vücudun iç kısımlarını incelemek için röntgen, bilgisayarlı tomografi (BT) taramaları ve manyetik rezonans görüntüleme (MRG) dahil olmak üzere birden fazla tıbbi görüntüleme yöntemi yaygın olarak kullanılır5,6. Her görüntüleme yönteminin kendine özgü avantajları ve dezavantajları vardır. MRG, vücudun, özellikle de beynin yumuşak dokularının ve hücrelerinin ayrıntılı görüntülerini sağlayan bir görüntüleme yöntemidir. Kanser, vücutta anormal doku veya hücreleri içerir ve MRG bu anormalliklerin detaylı görüntülerini sağlayarak beyin tümörlerinin veya kanserin teşhisinde daha kullanışlı bir görüntüleme yöntemi haline gelir. Ek olarak MRG, vücut iç anatomisinin incelenmesi sırasında zararlı radyasyon üretmediği için diğer görüntüleme yöntemlerinden daha güvenlidir.
Ayrıca, beyin tümörleriyle ilişkili tanısal zorlukları ele almak için makine öğrenimi (ML), görüntü işleme (IP) ve derin öğrenme (DL) dahil olmak üzere birçok hesaplamalı metodoloji de kullanılmakta olup, her bir yaklaşım kanseri teşhis etmek için görüntüleme modaliteleriyle alınan görüntülere uygulanmaktadır7. Bu yaklaşımlar, etkilenen bölgedeki örüntüleri tanımlayarak kanseri teşhis etmek için görüntülerdeki farklı nesnelerin gizli örüntülerini ve yapılarını öğrenirler. Her hesaplamalı yaklaşımın tanı sürecinde kendine özgü avantajları ve dezavantajları vardır. ML ve IP tabanlı yaklaşımlar, çoğunlukla hatalı tahminlere ve sürecin yanlış teşhis edilmesine yol açan, elle tasarlanmış (handcrafted) özellikleri çıkarırlar; bu durum özellikle daha büyük veri setlerinde belirgindir8. Elle tasarlanmış özellik çıkarma ile ilgili sorunların üstesinden gelmek için, tümörleri doğru şekilde teşhis etmek amacıyla görüntülerden en iyi özellikleri öğrenen ve otomatik olarak çıkaran, yaygın olarak evrişimli sinir ağı (CNN) tabanlı modeller olarak adlandırılan derin öğrenme tabanlı modellere geçiş yapılmaktadır. DL tabanlı yaklaşımlar, büyük ölçekli verilerdeki karmaşık örüntüleri öğrenme ve çıkarma yetenekleri sayesinde daha doğru sonuçlar ürettikleri için, özellikle beyin tümörleri, meme kanseri, akciğer kanseri ve diğer hastalıkların erken ve doğru tespiti amacıyla insan vücudundaki hastalıkları teşhis etmek için tıbbi görüntülemede yaygın olarak kullanılmaktadır9. Bir DL modelinde karşılaşılan temel sorun, daha fazla kaynak tüketimi ve veri örneklemesidir; bu durum, önceden eğitilmiş modellerin hastalık teşhisinde kullanılarak zaman ve kaynak tasarrufu sağladığı, transfer öğrenme10 (TL) adı verilen başka bir derin öğrenme tabanlı yaklaşımla aşılmaktadır. Büyük bir veri setinden doku, renk, kenarlar ve daha fazlasıyla ilgili temel özellikleri halihazırda öğrenmiş olan önceden eğitilmiş modeller, sağlık sorunlarının erken ve doğru teşhisini mümkün kılar. Bu modeller daha sonra, modelden yararlanarak hiperparametreler ile eğitilebilir ve eğitilemez katmanlar eklenerek, daha önce hiç görülmemiş yeni bir veri setine aktarılabilir11. Beyin tümörlerinin sınıflandırılması üzerine önemli miktarda araştırma yapılmıştır ve Tablo 112,13,14,15,16,17,18,19,20,21,22,23 bu araştırmaların yaklaşımlar, veri setleri ve sonuçlar dahil olmak üzere ayrıntılarını sunmaktadır. Yine de, hiçbir araştırma çalışması, sağlam özellik çıkarma için iki transfer öğrenme modelini birleştiren ve sorunsuz eğitim ile test sağlamak için düzenleme (regularization) tekniklerini ayarlayan bir metodoloji uygulamamıştır. Önerilen metodolojinin kapsamlı değerlendirmesi, farklı beyin tümörü özelliklerine göre model performansı hakkında içgörüler sağlar.
| Ref | Yöntem | Veri Örnekleri | Sonuçlar | Kısıtlamalar |
| 12 | Özelleştirilmiş CNN | Br35H | Accuracy = 97.45%, | Sonuçlarda hala iyileştirmelere ihtiyaç vardır; kendi yapım bir CNN kullanmak yerine, modifiye edilmiş önceden mevcut bir CNN modeli kullanmak daha iyidir. |
| Loss = 0.1141%, | ||||
| Recall = 98.09%, | ||||
| F1-Score = 97.69%, | ||||
| Precision = 97.29%, | ||||
| Artırılmış Br35H | Accuracy = 98.99%, | |||
| Precision = 98.90%, | ||||
| Loss = 0.0570%, | ||||
| Recall = 98.91%, | ||||
| F1-Score = 99.04% | ||||
| 13 | Öznitelik Füzyonu DNN modeli | Br35H | Accuracy = 98.22%, | Sonuçlarda hala iyileştirmelere ihtiyaç vardır ve özelleştirilmiş bir model kullanmak yerine, öznitelik füzyonu için önceden mevcut bir model kullanma gereksinimi devam etmektedir. |
| FNR = 1.77%, | ||||
| Sensitivity = 98.2%, | ||||
| F1-Score = 98%, | ||||
| Specificity = 98%, | ||||
| Figshare | Accuracy = 98.01%, | |||
| Sensitivity = 96.03%, | ||||
| F1-Score = 96%, | ||||
| Specificity = 98.67%, | ||||
| FNR = 3.96% | ||||
| 14 | SGD ile AlexNet | Br35H | Accuracy = 98.79%, | Yine de sonuçlarda bazı iyileştirmelere ihtiyaç vardır ve farklı veri örnekleri üzerinde bazı gelişmiş CNN tabanlı modelleri kontrol etmemiz gerekmektedir. |
| MCR = 1.20%, | ||||
| Sensitivity = 98.98%, | ||||
| Specificity = 98.58%, | ||||
| F1-Score = 98.82% | ||||
| 15 | InceptionV3 | Figshare | Accuracy = 98.89%, | Yazarlar, üç tümör sınıfına sahip olan Figshare veri setini kullanmışlardır; tümörleri sınıflandırmak yerine, tümör varlığını veya yokluğunu sınıflandırmışlardır ve sonuçların iyileştirilmesinin yanı sıra tümör sınıflarının kategorize edilmesine hala ihtiyaç vardır. |
| SensitivityB = 95.28%, | ||||
| SensitivityM = 94.47% | ||||
| 16 | Optimize edilmiş ResNet50 | Figshare | Accuracy = 99.03%, | Sonuçlarda daha fazla iyileştirme ile birlikte diğer performans değerlendirme parametrelerinin hesaplanması gerekirdi. |
| Recall = 99%, | ||||
| F1-Score = 99% | ||||
| 17 | Res-BRNet | Br35H | Accuracy = 98.22%, | Sonuçlarda hala iyileştirmelere ihtiyaç vardır. |
| Sensitivity = 98.11%, | ||||
| Precision = 98.22%, | ||||
| Figshare | F1-Score = 98.41% | |||
| 18 | ResNet101 + DenseNet121 | Figshare | Accuracy = 99.18%, | Sonuçlarda az miktarda iyileşme vardır ve daha fazla beyin tümörü ile ilgili veri setinin kontrol edilmesi gerekmektedir. |
| Recall = 99.11%, | ||||
| F1-Score = 99.08, | ||||
| Precision = 99.07%, | ||||
| Sartaj | Accuracy = 97.24%, | |||
| Recall = 97.58%, | ||||
| F1-Score = 97.28%, | ||||
| Precision = 97.06%, | ||||
| 19 | CNN-SVM | Brats | Accuracy = 98.02%, | SVM ile bazı önceden mevcut modellerin uygulanmasına ihtiyaç vardır ve sonuçlarda hala iyileştirmelere gerek duyulmaktadır. |
| F1-Score = 98.31%, | ||||
| Precision = 98.09%, | ||||
| Sensitivity = 98.53%, | ||||
| Specificity = 97.30%, | ||||
| Sartaj | Accuracy = 96.83%, | |||
| Precision = 95.36%, | ||||
| Sensitivity = 94.73%, | ||||
| Specificity = 97.56%, | ||||
| F1-Score = 95% | ||||
| 20 | İnce ayarlı EfficientNetB3 | Figshare | Accuracy = 98.70% | Sonuçları iyileştirmek için EfficientNetB3'ün yukarıda belirtilen varyantlarına ihtiyaç vardır. |
| Sartaj | Accuracy = 97.50% | |||
| 21 | InceptionV4 | Masoud | Accuracy = 98.7%, | Daha fazla veri seti kullanılarak sonuçlarda bazı iyileştirmeler yapılması gerekmektedir. |
| Precision = 99%, | ||||
| Sensitivity = 98%, | ||||
| Specificity = 99%, | ||||
| F1-Score = 99.1% | ||||
| 22 | VGG16 | Masoud | Accuracy = 98% | Daha fazla derin sinir ağı modeli kontrol edilerek sonuçların iyileştirilmesine ihtiyaç vardır. |
| 23 | MFR-CNN | Masoud | Accuracy = 94%, | Bu önerilen çözümde kullanılan karmaşık bir mimaridir. |
| Recall = 96%, | ||||
| F1-Score = 96%, | ||||
| Precision = 96%, |
Tablo 1: En güncel araştırma çalışmalarının karşılaştırmalı incelemesi. Tablo; mevcut araştırmaları, yaklaşımları, veri örneklerini, sonuçları ve kısıtlamaları ile birlikte özetlemektedir. Bu Tabloyu indirmek için lütfen buraya tıklayınız.
Tablo 1, mevcut yaklaşımları gözden geçirerek sonuçların iyileştirilmesindeki kısıtlılıklarını ve performanslarını çeşitli istatistiksel parametrelere göre değerlendirirken mevcut DL modellerini kullanmanın gerekliliğini, tüm bunları farklı beyin tümörü veri setlerinde daha iyi performans gösteren verimli bir çerçeve içerisinde vurgulamaktadır.
Çalışma hedefleri ve problem tanımı
Manuel yorumlama zaman alıcıdır ve gözlemciler arası değişkenlikten etkilenir; bu nedenle, MRI üzerinden beyin tümörü türlerinin hızlı ve doğru bir şekilde kategorize edilmesi klinik karar verme süreci için hayati önem taşımaktadır. Günümüzde otomatik beyin tümörü sınıflandırması için kullanılan DL yaklaşımlarının çoğu, tek bir omurga ağa veya basit karar düzeyli füzyona dayanmaktadır; bu durum, önceden eğitilmiş birden fazla mimariden gelen tamamlayıcı özellik temsillerinin tam olarak kullanılmamasına neden olmakta ve genellikle yalnızca tek bir veri seti üzerinde doğrulanarak genelleştirilebilirlik konusundaki güveni sınırlamaktadır.
Bu araştırma projesi, MRI üzerinden sağlam beyin tümörü sınıflandırması sağlamak amacıyla tamamlayıcı özellik temsillerinden yararlanan çift gövdeli bir derin öğrenme (DL) çerçevesi (EfficientNetB7 ve DenseNet121) kullanarak insan beyinlerindeki beyin kanserlerini teşhis etmek için eksiksiz ve doğru bir yöntem geliştirmeyi ve sunmayı amaçlamaktadır. Çalışma ayrıca, çerçevenin birden fazla bağımsız kamuya açık veri seti üzerindeki dayanıklılığını değerlendirmektedir. Bu yaklaşım, radyologların ve sağlık görevlilerinin beyin tümörlerini hızlı ve etkili bir şekilde teşhis etmelerine yardımcı olarak, tanıma ve sınıflandırmayı mümkün kılarak hastaların hayatlarını kurtarabilir.
Belirli bir araştırma problemini çözmek ve bu araştırma projesinin amaçlarına veya hedeflerine ulaşmak için, araştırma soruları ve bu soruları yanıtlamaya yönelik katkılar şunlardır: 1) Beyin tümörü sınıflandırması için iki önceden eğitilmiş ana ağın öznitelik düzeyinde (ara) birleştirilmesi, karar düzeyindeki (geç) ve dikkat tabanlı birleştirme tekniklerinden daha mı iyidir? 2) Önerilen sistem, bağımsız olarak elde edilmiş birçok beyin tümörü MRI veri setinde tutarlı sınıflandırma performansı sağlayacak mıdır?
Bu çalışmanın kapsamı, beş adet halka açık beyin tümörü MRI veri seti (Br35H, Figshare, Sartaj, Masoud ve BBT-Dataset) kullanılarak gerçekleştirilen görüntü düzeyinde (2D MRI kesiti) sınıflandırma ile sınırlıdır; değerlendirmeler veri setleri arası değil, bağımsız olarak yapılmıştır ve metodoloji bölümünde açıklanan spesifik mimari, ön işleme hattı ve deneysel konfigürasyon kullanılmıştır. Çalışma, hasta düzeyinde doğrulamayı veya klinik uygulama ortamındaki testleri içermemektedir.
Bu araştırma çalışmasının temel katkıları şunlardır: 1) Bu çalışmanın birincil katkısı, optimize edilmiş hiperparametrelerle birlikte DenseNet121 ve EfficientNetb7 dahil olmak üzere, daha iyi özellik çıkarımı için çift ön eğitimli model kullanmaktır. 2) Güçlü bir performans için, çift ön eğitimli modelden gelen birleştirilmiş özelliklerle entegre edilmiş, gelişmiş bir düzenlileştirme tekniğine sahip yenilikçi model mimarisi. 3) Aşırı öğrenme (overfitting) sorunlarının üstesinden gelmek, daha genel ve spesifik özellikleri öğrenmek amacıyla eğitim örneklerinin çeşitliliğini artırmak için etkili bir veri artırma stratejisi uygulanmıştır. 4) Önerilen modelin performansı; doğruluk, yanlış sınıflandırma oranı, kesinlik, negatif öngörü değeri, duyarlılık, özgüllük, F1-Skoru, yanlış negatif oranı ve yanlış pozitif oranı dahil olmak üzere çeşitli istatistiksel değerlendirme parametrelerine odaklanılarak, halka açık beş farklı beyin tümörü veri seti üzerinde değerlendirilmiştir.
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Protokol
Dünyadaki en tehdit edici hastalıklardan biri beyin tümörüdür. Doğru bir teşhis, hastaların sağkalımı açısından faydalı olabilir. Buna rağmen, beyin tümörlerini erken evrede tespit edebilecek doğru bir tanı sistemine ihtiyaç duyulmaktadır. Bu sorunu çözmek için, DenseNet121 ve EfficientNetB7 modellerine dayalı, optimize edilmiş hiperparametreler ve ince ayarlı katmanlarla donatılmış hibrit bir çift derin öğrenme mekanizması kullanılarak, beyin tümörlerinin erken evrelerinde doğru şekilde tespit edilmesi için daha güvenilir bir teknik önerilmiştir. Önerilen yaklaşım, girdi olarak 2D MRI görüntülerini alır ve binary sınıflandırma veri seti Br35H için tümör varlığı veya yokluğu tahmini, diğer dört multiclass sınıflandırma veri seti için ise tümör kategorizasyonu çıktısı verir. Bu nedenle bu bölüm, Şekil 1'de gösterildiği gibi; veri toplama, veri ön işleme, veri bölme, model seçimi, öznitelik çıkarımı, tümör tahmini ve önerilen modelin değerlendirilmesi dahil olmak üzere, veri toplama aşamasından nihai çıktıya kadar önerilen yaklaşımın ana adımlarını göstermektedir.
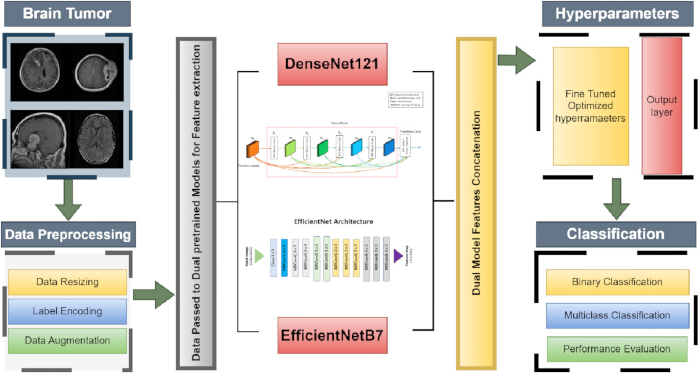
Şekil 1: Önerilen metodoloji iş akışı. Bu diyagram; veri edinimi ve ön işlemeyi, özellik çıkarımı için iki ön eğitimli modeli, bu özelliklerin birleştirilmesini ve tümör sınıflandırması ile tipi için hiperparametre ince ayarlarını içeren önerilen modelin genel mimarisini göstermektedir. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayınız.
Veri toplama
Herhangi bir deneysel araştırmada ilk adım veri edinimdir. Bunun için, beyin tümörü tespitinin teşhisi amacıyla birçok araştırmacı tarafından halihazırda kullanılmış olan Br35H24, Figshare25, Sartaj26, Masoud27 ve açık kaynaklı Kaggle28 kütüphanesinden alınan beyin tümörü MRI görüntü tabanlı veri seti dahil olmak üzere halka açık beş farklı veri seti seçilmiştir. Br35H veri seti, her bir sınıfta 1.500 adet olmak üzere sağlıklı ve sağlıksız (tümörlü) beyin görüntüleri şeklinde iki sınıftan oluşan 3.000 görüntüye sahiptir; Figshare veri seti ise tümör tipine göre üç gruba ayrılmış toplam 3.064 görüntüden oluşmaktadır: 1.426 gliom görüntüsü, 708 meningioma görüntüsü ve 930 hipofiz tümörü görüntüsü. Sartaj veri seti; gliomlar (926 görüntü), meningiomalar (937 görüntü), hipofiz tümörleri (901 görüntü) ve sağlıklı veya tümör yok (500 görüntü) olmak üzere dört tümör sınıfına ayrılmış 3.264 görüntüye sahiptir. Ayrıca Masoud veri seti de dört farklı tümör sınıfından oluşmakta olup görüntüleri yukarıda belirtilen üç veri setinden alınmıştır; toplam 7.023 görüntüden oluşan bu set daha sonra gliom (1621 görüntü), meningioma (1645 görüntü), hipofiz (1757 görüntü) ve sağlıklı veya tümör yok (2000 görüntü) şeklinde kategorize edilmiştir. Seçilen son veri seti, toplam 5.248 görüntü ile yine dört sınıftan oluşan MRI görüntü tabanlı bir veri setidir; bu set 1.312 gliom görüntüsü, 1.312 meningioma görüntüsü, 1.312 hipofiz görüntüsü ve 1.312 sağlıklı veya tümör yok görüntüsü şeklinde tümör tiplerine ayrılmıştır ve tümör tiplerine eşit şekilde bölündüğü için dengeli bir veri seti olarak kabul edilmektedir.
Veri ön işleme
Veri toplama işleminden sonraki adım, daha iyi sonuçlar elde etmek ve verilerden en iyi özelliklerin çıkarılması ile öğrenilmesini sağlayarak daha doğru sonuçlar üreten hesaplama yaklaşımları için temel olan ön işlemedir. Uygulanan ilk adım görüntü boyutlandırmasıdır. Farklı sınıflara ve aynı veri seti içinde bile farklı tümör sınıfları için farklı görüntü boyutlarına sahip, kamuya açık beş veri seti seçilmiş ve daha iyi model yorumlaması ve öğrenimi için tek tipleştirilerek 224 x 224 boyutuna getirilmiştir. Ayrıca, farklı açılardan ek örnekler oluşturularak tüm veri setlerine veri artırımı uygulanmış, böylece derin öğrenme (DL) modelleri tarafından özellik çıkarımı ve öğrenimi iyileştirilmiştir. Bunun için tüm görüntülere %7'lik bir döndürme aralığı uygulanarak görüntüler 7 dereceye kadar döndürülmüştür. Ayrıca, tüm görüntülere yatay ve dikey olarak %5 rastgele kaydırma uygulanmış, orijinal görüntülere göre yükseklik ve genişlikte %5 kaydırma yapılmıştır. Ardından görüntüler orijinal boyutlarına göre %10 yakınlaştırılmış ve son olarak tüm görüntüler yatay ve dikey olarak çevrilmiştir. Veri artırımı29 gerçekleştirmenin temel nedeni, orijinal veri örneklerinin çeşitli dönüştürülmüş versiyonları üzerinde eğitim yaparak aşırı öğrenmenin (overfitting) önüne geçmek ve modellerin genelleme yeteneğini artırmaktır. Veri setleri eğitim ve doğrulama olarak ayrılmadan önce, eğitim ve doğrulama sırasında kayıp (loss) hesaplamalarına yardımcı olan ve aynı zamanda veri örneklerini modellerin etiketleri doğru işlemesi için daha uygun hale getiren etiket kodlama (label encoding) işlemi uygulanmıştır. Ek olarak, veri seti her biri için %80'e %20 oranında30 eğitim ve doğrulama setlerine bölünmüştür ve Tablo 2 veri örneklerinin genel dağılımını ve eğitim ile doğrulama oranlarını göstermektedir.
| Veri Seti | Tümör Sınıfları | Toplam görüntü | Eğitim görüntüleri | Doğrulama görüntüleri |
| Br35H | Sağlıklı | 1500 | 1200 | 300 |
| Tümör | 1500 | 1200 | 300 | |
| Toplam görüntü | 3000 | 2400 | 600 | |
| Figshare | Gliom | 1426 | 1141 | 285 |
| Meningiom | 708 | 566 | 142 | |
| Hipofiz | 930 | 744 | 186 | |
| Toplam görüntü | 3064 | 2451 | 613 | |
| Sartaj | Gliom | 926 | 741 | 185 |
| Meningiom | 937 | 749 | 188 | |
| Tümör yok | 500 | 400 | 100 | |
| Hipofiz | 901 | 721 | 180 | |
| Toplam görüntü | 3264 | 2611 | 653 | |
| Masoud | Gliom | 1621 | 1297 | 324 |
| Meningiom | 1645 | 1316 | 329 | |
| Tümör yok | 2000 | 1600 | 400 | |
| Hipofiz | 1757 | 1405 | 352 | |
| Toplam görüntü | 7023 | 5618 | 1405 | |
| Dengelenmiş beyin tümörü veri seti (BBT-Dataset) | Gliom | 1312 | 1050 | 262 |
| Meningiom | 1312 | 1050 | 262 | |
| Tümör yok | 1312 | 1050 | 262 | |
| Hipofiz | 1312 | 1050 | 262 | |
| Toplam görüntü | 5248 | 4200 | 1048 |
Tablo 2: Veri seti dağılımı. Tablo, beyin tümörü veri setlerindeki toplam, eğitim ve doğrulama görüntü sayılarına ilişkin sınıf bazlı istatistikleri göstermektedir.
Br35H veri seti, 2400'ü eğitim ve 600'ü doğrulama için seçilmiş toplam 3000 görüntüden oluşmaktadır. Figshare veri seti 3064 görüntü içermektedir. Tüm görüntülerden 2451'i eğitim için seçilmiş, kalan 613'ü ise doğrulama için ayrılmıştır. Sartaj veri seti toplam 3264 görüntüye sahiptir; bunların 2611'i eğitimde ve kalan 653'ü doğrulamada kullanılmıştır. Masoud veri seti toplam 7023 görüntüye sahiptir; bunlardan 5618'i eğitim için, kalan 1405'i ise doğrulama için kullanılmıştır. BBT veri seti toplam 5248 görüntüye sahiptir. Toplam görüntülerden 4200'ü eğitim amaçlı, diğer kalan 1048 görüntü ise doğrulama amaçlı değerlendirilmiştir. Ek olarak, aşağıdaki Şekil 2 çeşitli beyin tümörü görüntülerini göstermektedir.
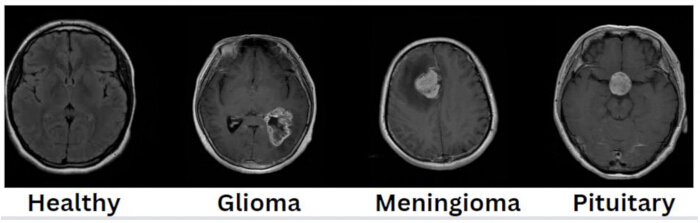
Şekil 2: Tümör tiplerini içeren beyin tümörü görüntüleri. Veri seti, dört sağlıklı beyin dokusu görüntüsü ve üç tümörlü görüntü içerir: gliom, meningiom ve hipofiz. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
Önerilen model
Önişleme aşamasını takiben, bir sonraki adım yalnızca beyin tümörü sınıflandırması için etkili bir eğitim modeli önermektir. Bu amaçla, özellikle beyin tümörlerini sınıflandırmak için verimli bir eğitim modeli önerilmiştir. Bu kapsamda, görüntülerden özellik çıkarmak için DenseNet12131,32 ve EfficientNetB733 modellerini içeren, yeni ve verimli, hibrit özellik füzyonuna dayalı önceden eğitilmiş bir model önerilmiştir; ayrıca, çıkarılan bu özellikler birleştirilmiş ve beyin tümörlerini doğru şekilde teşhis etmek amacıyla eğitilebilir ve eğitilemez katmanlar dahil olmak üzere farklı şekilde optimize edilmiş hiperparametrelere aktarılmış ve yukarıdaki ilgili bölümlerde tartışılan halka açık beş farklı veri seti üzerinde uygulanmıştır. Ayrıca, DenseNet121 modeli 2017 yılında Gao Huang ve çalışma arkadaşları tarafından geliştirilmiştir ve 121 katmandan oluşmaktadır. Bu modelin temel amacı, özelliklerin yeniden kullanımını maksimize etmeye odaklanmak ve kaybolan gradyan problemini önlemektir34. Bu modeldeki katmanlar, her biri özellikleri çıkaran ve öğrenen çoklu konvolüsyonel katmanlar içeren yoğun bloklar (dense blocks) şeklinde düzenlenmiştir. Her katman, kendisinden önceki tüm katmanların özellik haritasını girdi olarak alır ve çıktısı bu katmanların çıktılarına bağlanarak aynı bloktaki sonraki katmanlara ileri beslemeli bir şekilde girdi olarak aktarılır. Ayrıca, yoğun bloklar arasına, her biri 1 × 1 konvolüsyonel katman, bir BatchNormalization katmanı ve 2 × 2 ortalama havuzlama (average pooling) katmanlarından oluşan ve model karmaşıklığını kontrol etmek için özellik haritasını küçülten geçiş katmanları eklenmiştir. Dahası, sınıflandırma için küresel ortalama havuzlama katmanından önce SoftMax aktivasyon fonksiyonuna (AF) sahip nihai bir katman eklenmiştir. DenseNet121 modelinin temel tasarımı aşağıdaki Şekil 334'te gösterilmiştir.
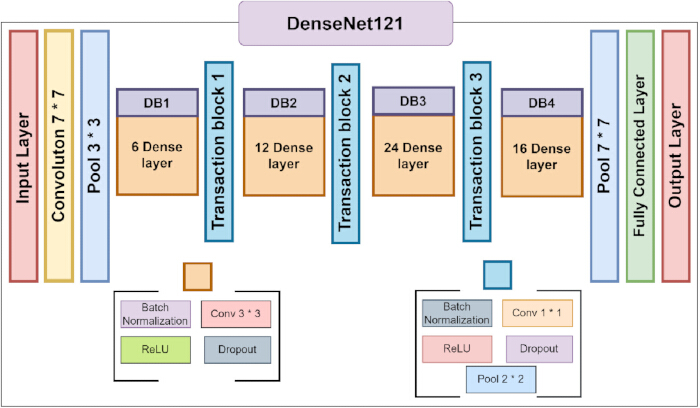
Şekil 3: DenseNet121 mimari detayı34. Bu şekil, tüm yoğun ve geçiş blokları dahil olmak üzere DenseNet121 modelinin mimari detaylarını göstermektedir. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
Ayrıca, EfficientNetB7 modeli 2019 yılında Tan ve Lee tarafından geliştirilmiştir. B0'dan B7'ye kadar varyantları olan EfficientNet ailesine ait olan bu modelin temel amacı, daha az parametre ve daha az işlem gücü kullanarak diğer modellerden daha yüksek performans sergilemekle ilgilidir. Modelin temel özelliği olan bileşik ölçeklendirme (compound scaling) aracılığıyla; model genişliği (katman başına kanal sayısı), derinliği (katman sayısı) ve çözünürlüğün tamamı hassas bir şekilde ayarlanabilmektedir. Dahası, bu model; kanalları genişletmekten sorumlu olan 1 × 1 konvolüsyonel genişleme katmanı, her kanala ayrı ayrı konvolüsyon uygulamaktan sorumlu olan derinlemesine ayrılabilir konvolüsyon (depthwise separable convolution) ve kanal sayısını orijinal haline düşüren 1 × 1 konvolüsyonel projeksiyon katmanından oluşan MBConv (mobile inverted bottleneck convolutional) bloklarını içerir. Ayrıca, her MBConv bloğu, kanal bazlı özellikleri yeniden kalibre ederek ağın en önemli olanlara odaklanmasına yardımcı olan Sıkıştırma ve Uyarma (Squeeze and Excitation - SE) bloklarından35 oluşur. Ayrıca, sigmoid veya başka bir aktivasyon fonksiyonu (AF) yerine, negatif değerlere izin vererek ReLU'dan daha iyi performans gösteren ve gradyan akışına yardımcı olan Swish fonksiyonu kullanılır. Dahası, sınıflandırma amacıyla, küresel ortalama havuzlama (global average pooling) katmanından önce SoftMax AF içeren nihai bir çıktı katmanı eklenir. Şekil 435 EfficientNetB7 modelinin temel tasarımını, Şekil 5 ise önerilen model mimarisini göstermektedir.
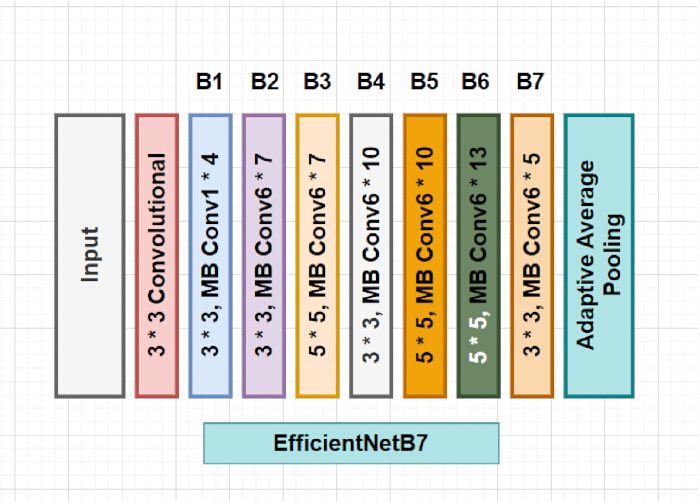
Şekil 4: EfficientNetB7 mimari detayı35. Bu şekil, tüm mobil ters darboğaz evrişimli bloklarını içeren EfficientNetB7 modelinin mimari detayını göstermektedir. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
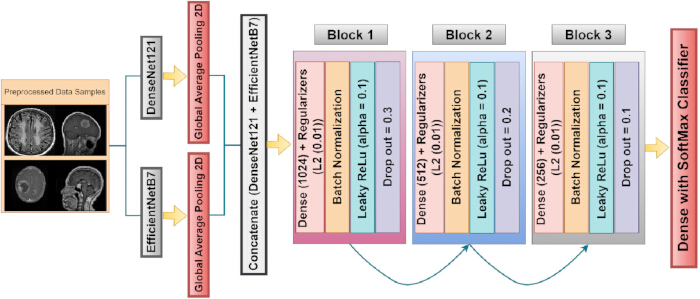
Şekil 5: Önerilen hibrit füzyon model mimarisi. Önerilen mimari, ön işlemeden geçmiş görüntülerin, farklı hiperparametrelerle özelleştirilmiş üç bloktan oluşan özellik çıkarıcıya ve ardından bir çıktı katmanına nasıl aktarıldığını göstermektedir. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
Ek olarak, ilk öznitelikler önceden eğitilmiş DenseNet121 ve EfficientNetB7 modellerinden çıkarılmıştır. Önceden eğitilmiş modellerin güncellenmiş ağırlıkları eğitilmiş modellere yüklenmiş ve modelin yeniden eğitilmesini önlemek için modellerin eğitilemez taban katmanları dondurulmuştur. Bunun, modelin geçmişteki en iyi bilgisini korumasına, yakınsamayı iyileştirmek için bu bilgileri yeni veri örnekleri ışığında uyarlamasına ve gelişmiş öznitelikleri eğitmek ve çıkarmak için ek katmanlara odaklanmasına yardımcı olması beklenmektedir. Aşağıdaki denklem 1 ve 2, DenseNet121 ve EfficientNetB7 modellerinin çalışma prensiplerini göstermektedir.
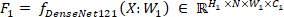 (1)
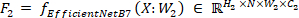 (2)
Yukarıdaki 1 ve 2 numaralı denklemler, önceden eğitilmiş modelin öznitelik çıkarma ile ilgili işleyişini göstermektedir; F1, X ile temsil edilen giriş görüntülerine işlem uygulanarak önceden eğitilmiş DenseNet121 modeli tarafından üretilen çıktı öznitelik haritalarını, F2 ise önceden eğitilmiş EfficientNetB7 modeli tarafından üretilen çıktı öznitelik haritalarını ifade eder. Ayrıca, W1 ve W2 sırasıyla DenseNet121 ve EfficientNetB7 modellerinin ilk blokları ve katmanlarıyla ilişkili öğrenilebilir parametreler veya ağırlıklardır. Dahası, ∈ RN ×H1×W1×C1 ve ∈ RN ×H2×W2×C2, sırasıyla DenseNet121 ve EfficientNetB7 modellerinin çıktı öznitelik haritalarının boyutluluğunu temsil eder ve boyutları H1 ×N×W1×C1 ile H2 ×N×W2×C2'dir; burada N, 16 olarak kabul edilen görüntülerin grup boyutunu (batch size) temsil eder. Ayrıca, H1×W1 DenseNet121 modeli için görüntülerin sırasıyla yüksekliğini ve genişliğini, H2×W2 ise EfficientNetB7 modeli için görüntülerin yüksekliğini ve genişliğini temsil eder ve 224 × 224 yükseklik ve genişlik boyutlarında seçilmiştir. C1 ve C2 sırasıyla DenseNet121 ve EfficientNetB7 modelleri için renk kanalını temsil eder. EfficientNetB7'den 2560 kanal ve DenseNet121'den 1024 kanal olarak modelden çıktı öznitelik haritaları alındıktan sonra, tüm uzamsal boyutların ortalaması alınarak uzamsal boyutu tek bir vektöre indirgemek için çıktı öznitelik haritalarına global average pooling 2D36 katmanı uygulanır; bu işlem, yorumlanabilir öznitelikler açısından daha iyi öznitelik çıkarma ve örüntü tanıma için bir sonraki katmana iletimi daha uygun hale getirir.
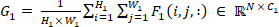 (3)
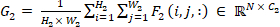 (4)
Yukarıdaki 3 ve 4 numaralı denklemler, sırasıyla DenseNet121 ve EfficientNetB7 modellerine uygulanan global average pooling 2D katmanının işleyişini göstermektedir; burada  ve
 , havuzlanmış çıktının basit bir toplamdan ziyade bir ortalama olmasını sağlamak için her iki modelde de toplam uzamsal konum sayısına bölerek toplamın normalize edilmesi işlemini göstermektedir.
 ve
 ise özellik haritalarının uzamsal boyutlar boyunca toplamını temsil ederken, i ve j her iki model için özellik haritalarını toplamak amacıyla sırasıyla yükseklik ve genişlik boyunca yinelemek için kullanılır. Ayrıca, F1(i, j, :) ve F2(i, j, :), sırasıyla DenseNet121 ve EfficientNetB7 modelleri için tüm kanallar boyunca belirli uzamsal konumlardaki (i, j) özellik haritası değerlerini temsil eder. Bu havuzlama işlemi, her görüntüdeki en önemli özellikleri korurken uzamsal bilgileri daha kompakt ve doğru bir temsile toplar. Dahası, global average pooling katmanlarının çıktıları, her örnek için tek bir özellik vektörü üretmek üzere birleştirilir; bu işlem, her iki modelin güçlü yönlerinden yararlanarak performansı artırmak için farklı modellerden gelen özellikleri birleştirmek amacıyla sıklıkla kullanılır; Denklem 5 bunun nasıl çalıştığını göstermektedir.
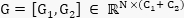 (5)
Yukarıdaki denklem 5, G1 DenseNet121 modelinin özellikler vektörünü ve G2 EfficientNetB7 modelinin özellik vektörünü temsil ettiği iki farklı model özellik vektörünün [G1, G2] birleştirme prosedürünü göstermektedir; birleştirilmiş özellik vektörünün şekli RN ×(C1+ C2) ile temsil edilirken, burada N paralel olarak ilerleyen örneklerin sayısını temsil eden grup boyutudur ve (C1+ C2) sırasıyla model 1 ve 2'den elde edilen ve paralel olarak işlenen yaklaşık 3584 olan toplam özellik sayısıdır; birleştirilmiş çıktı özellik vektörü ise G ile temsil edilir. Ayrıca, daha doğru ve verimli sonuçlar elde etmek amacıyla, daha karmaşık özellikleri çıkarmak, genellemeyi iyileştirmek ve aşırı öğrenmeyi (overfitting) önlemek için birleştirilmiş modeli modifiye eden üç farklı blok eklenmiştir. Her blok, farklı sayıda nörona sahip bir yoğun katmandan (dense layer) oluşur; birinci blok, verilerdeki geniş bir özellik yelpazesini ve daha genel kalıpları yakalamaya odaklanan, yoğun katmanlarında 1024 nöron bulunduran bloktur, ikinci blok ise boyutluluğu azaltarak ve daha spesifik kalıplara odaklanarak özellikleri özellikle rafine eden, yoğun katmanında 512 nöron bulunduran bloktur. Üçüncü blok, sadece en ilgili özelliklerin ve kalıpların daha ilgili bir görevi yerine getirmek üzere çıktı katmanına aktarılmasını sağlamak için özellikleri daha spesifik olarak damıtan, yoğun katmanında 256 nöron içeren bloktur. Ayrıca, büyük ağırlıkları cezalandırarak aşırı öğrenmeyi önlemek için her bloktaki her yoğun katmana L2 düzenlileştirme37 yaklaşımları eklenmiştir ve bu durum aynı zamanda modelin daha karmaşık hale gelmesine neden olmaktadır. Ağların, tek bir nörona bağımlı olmayan daha sağlam özellikler geliştirmesini zorlamak amacıyla, her bloktan sonra sırasıyla 1, 2 ve 3. bloklar için nöronların rastgele %30, %20 ve %10'unu yok sayan bir dropout katmanı38 eklenmiştir. Ayrıca, eğitim sürecini stabilize etmek için her yoğun katmandan sonra, aktivasyonların sabit bir aralıkta kalmasını sağlayan ve ayrıca modelin eğitim aşamasında kaybolan gradyanlar (vanishing gradients) ve patlayan gradyanlar (exploding gradients) gibi sorunlardan kaçınmasına yardımcı olan bir BatchNormalization39 katmanı uygulanmıştır. Ek olarak, bu BatchNormalization katmanı, kayıp yüzeyini (loss landscape) düzleştirerek modelin daha hızlı yakınsamasına olanak tanıyarak eğitim sürecini hızlandırmış ve optimizatörler için küresel minimuma ulaşmayı kolaylaştırmıştır. Ayrıca, her blokta doğrusal olmama (non-linearity) durumu üretmek için, modelin karmaşık kalıpları öğrenmesini sağlayan leaky ReLU aktivasyonu40 kullanılmıştır; leaky ReLU, negatif girdiler için küçük, sıfır olmayan bir gradyana izin vererek nöronun inaktif hale gelmemesini sağladığı için diğer aktivasyon fonksiyonlarına göre avantajlara sahiptir. Ayrıca, aşağıdaki denklem 6, hibrit birleştirilmiş model ile entegre edilen farklı blokların çalışma prensibini göstermektedir.
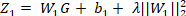 (6)
Birleştirilmiş vektör elde edildikten sonra, G, 1024 nöronlu blok 1 yoğun katmana (tam bağlantılı) aktarılır; burada W1 ağırlık matrisi, giriş vektörü G'yi 1024 boyutlu bir çıkış vektörüne dönüştürür ve çıkış vektöründeki her bir öge, giriş özelliklerinin lineer bir kombinasyonudur. Ayrıca, modelin giriş özelliklerinin çıktısını bağımsız olarak kaydırmasına olanak tanıyan b1 sapma (bias) vektörü, çıktının 1024 ögesinin her birine eklenir. Dahası, L2 düzenleme terimi olan λ||W1||22, büyük ağırlıkları cezalandırarak modelin tek bir nörona aşırı bağımlı olmasını engeller ve böylece aşırı öğrenmenin (overfitting) önüne geçilmesine yardımcı olur. Burada, sinir ağındaki belirli bir katmanın ağırlık matrisi W1 iken, ||W1||22 ağırlık matrisi W1'nin karesel L2 normunu ve λ ise tüm bloklarda 0,1 olarak ayarlanan ve uygulanan düzenleme derecesini kontrol eden düzenleme parametresini ifade eder. Denklem 6'da gösterildiği üzere, birleştirilmiş vektör G'den gelen girişe yoğun katmanın ve L2 düzenlemesinin uygulanmasının ardından Z1 yeni özellik temsili haline gelir.
Blok 1'in yoğun katmanından Z1 olarak çıktı alındıktan sonra, eğitim sürecini hızlandırmak için kullanılan BatchNormalization katmanı uygulanmıştır ve aşağıdaki denklem 7 bunun nasıl çalıştığını göstermektedir.
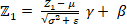 (7)
σ2, son katman Z1 çıktısının batch genelindeki varyansını temsil ederken; μ, ilk yoğun katmanda 1024 olan ve her nöron için ayrı ayrı hesaplanan Z1 çıktısının ortalamasıdır. ε ise sayısal kararlılığı sağlamak ve sıfıra bölünmeyi önlemek için eklenen küçük bir sabittir. Normalize edilmiş çıktı, öğrenilebilir ölçek parametresi γ ile model tarafından ayarlanabilirken, normalize edilmiş çıktı öğrenilebilir kaydırma parametresi β ile kaydırılabilir. Son olarak, yoğun katman çıktısına BatchNormalization katmanı uygulandıktan sonra, normalize edilmiş çıktı Z1, aktivasyonların farklı katmanlar genelinde tutarlı bir dağılıma sahip olmasını sağlayarak eğitimin stabilize edilmesine ve hızlandırılmasına yardımcı olur. BatchNormalization işleminden sonra, normalize edilmiş çıktı Z1, ağda doğrusal olmama durumu yaratarak verilerdeki karmaşık örüntülerin öğrenilmesine yardımcı olan leaky ReLu aktivasyon fonksiyonundan geçer. ReLU veya başka bir aktivasyon fonksiyonu seçmek yerine, ReLU aktivasyon fonksiyonu gibi küçük negatif değerleri 0 yapmak yerine bunları da dikkate alan ve böylece "dying ReLU" problemini aşan ReLU fonksiyonunun modifiye edilmiş versiyonu olan leaky ReLU seçilmiştir. Aşağıdaki Denklem 8 bunun nasıl çalıştığını göstermektedir.
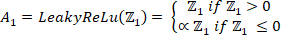 (8)
Z1, BatchNormalization katmanının çıktısını temsil eder ve doğrusal olmama işlemini gerçekleştirmek üzere Leaky ReLU'ya girdi olarak aktarılır; ∝ ise fonksiyonun negatif kısmının eğimini belirlemek için kullanılan küçük bir sabittir. Ayrıca, A1, doğrusal olmama işlemi uygulandıktan sonra elde edilen çıktıyı gösterir. Son olarak, Leaky ReLU aktivasyonundan girdi olarak alınan A1 çıktısına, denklem 9'da gösterildiği üzere bir dropout katmanı uygulanır.
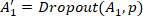 (9)
Burada A1, son ReLu aktivasyon fonksiyonundan alınan orijinal aktivasyon fonksiyonu çıktısıdır ve p, nöronların bir kısmını devre dışı bırakmak için 0 ile 1 arasında değişen ve üç blok katmanı için sırasıyla 0.3, 0.2 ve 0.1 olarak seçilen dropout oranıdır. Ayrıca A1′, bazı nöronların 0'a ayarlandığı dropout katmanının uygulanmasından sonraki modifiye edilmiş çıktıyı göstermektedir. Bunu kullanmanın temel avantajı, ko-adaptasyonu azaltmanın yanı sıra aşırı öğrenme (overfitting) sorunlarını önlemektir. Dahası, blok1'den gelen çıktı A1′, daha soyut özellikler çıkarmak için tekrar bir sonraki bloğa aktarılmış ve blok 1'deki parametrelerin aynısı uygulanmıştır; ancak yoğun katmanda 1024 yerine 512 nöron ve 0.3 yerine 0.2 dropout oranı ile bazı farklılıklar gözetilmiş, diğer operasyonel dizilimler ise aynı tutulmuştur; bu durum aşağıdaki 10 ila 13 numaralı denklemlerde açıklanmıştır.
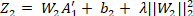 (10)
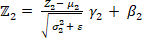 (11)
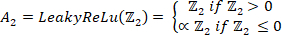 (12)
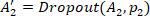 (13)
Blok 1'den alınan A1′ çıktısı, ağırlık matrisi W2'nin giriş vektörü A1′'i 512 boyutlu bir çıktı vektörüne dönüştürdüğü ve çıktı vektöründeki her bir öğenin giriş özelliklerinin doğrusal bir kombinasyonu olduğu 512 nöronlu blok 2 yoğun katmanından (tam bağlantılı) geçirilir. Ayrıca, modelin giriş özelliklerinin çıktısını bağımsız olarak kaydırmasına olanak tanıyan b2 sapma (bias) vektörü, çıktının 512 öğesinin her birine eklenir. Buna ek olarak, büyük ağırlıkları cezalandıran λ||W2||22 şeklinde L2 regülarizasyonu uygulanmıştır; bu, modelin bu spesifik bloktaki herhangi bir nörona aşırı derecede güvenmesini önleyerek aşırı öğrenmeyi (overfitting) azaltmaya hizmet eder. Burada, W2 sinir ağındaki belirli bir katmanın ağırlık matrisi, λ ise 0,1 olarak uygulanan ve regülarizasyon derecesini kontrol eden regülarizasyon parametresidir. Blok 1'den gelen girişe yoğun katman ve L2 regülarizasyonu uygulandıktan sonra ortaya çıkan yeni özellik temsili Z2 olur ve bu durum denklem 10'da gösterilmiştir.
Ayrıca, eğitim sürecini hızlandırmak için yeni özellik Z2'ye BatchNormalization katmanı uygulanmıştır; σ22 grup genelindeki varyansı temsil ederken, μ2 ise Z2 çıktısının ortalamasıdır. ε, sayısal kararlılığı sağlamak için dahil edilen küçük bir sabit iken, γ modelin normalize edilmiş çıktıyı değiştirmesine olanak tanıyan öğrenilebilir bir ölçekleme parametresidir ve β modelin normalize edilmiş çıktıyı kaydırmasına olanak tanıyan öğrenilebilir bir kaydırma parametresidir. Son olarak, Denklem 11'de gösterilen BatchNormalization katmanı uygulandıktan sonra, normalize edilmiş Z2 çıktısı, ağda doğrusal olmama durumu oluşturan ve Denklem 12'de gösterilen leaky ReLU AF'den geçirilmiştir. Burada Z2, doğrusal olmama işlemini gerçekleştirmek üzere Leaky ReLU'ya girdi olarak aktarılan BatchNormalization katmanının çıktısına aittir. A2 ise doğrusal olmama durumu uygulandıktan sonra elde edilen çıktıyı göstermektedir.
Son olarak, Denklem 13'te gösterildiği üzere, Leaky ReLU aktivasyonundan girdi olarak alınan A2 çıktısına bir dropout katmanı uygulanır. Burada A2, son ReLU aktivasyon fonksiyonundan alınan çıktıyı; p2 ise nöronların bir kısmını devre dışı bırakmak amacıyla bu blok için 0,2 olarak seçilen dropout oranını temsil eder. Ayrıca A2′, dropout katmanı uygulandıktan sonra bazı nöronların 0'a ayarlandığı modifiye edilmiş çıktıyı göstermektedir. Daha sonra, blok 2'den gelen A2′ çıktısı, daha soyut öznitelikler çıkarmak için tekrar üçüncü bloğa aktarılır ve blok 2'deki parametrelerin aynısı uygulanır; ancak yoğun katmanda 512 yerine 256 nöron ve 0,2 yerine 0,1'lik bir dropout oranı ile farklılaşır. Diğer işlemsel diziler aynıdır ve aşağıdaki 14 ile 17 arasındaki denklemlerde açıklanmıştır.
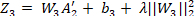 (14)
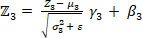 (15)
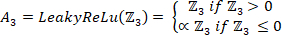 (16)
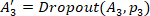 (17)
Blok 2'den A2′ şeklinde alınan çıktı, 256 nöronlu blok 3 yoğun katmanına (tam bağlantılı) aktarılır; burada ağırlık matrisi W3, giriş vektörü A2′'yi 256 boyutlu bir çıktı vektörüne dönüştürür ve çıktı vektöründeki her bir eleman, giriş özelliklerinin lineer bir kombinasyonudur. Ayrıca, modelin giriş özelliklerinin çıktısını bağımsız olarak kaydırmasına olanak tanıyan b3 sapma (bias) vektörü, çıktının 256 elemanının her birine eklenir. Dahası, büyük ağırlıkları cezalandırarak modelin tek bir nörona aşırı bağımlı olmasını engelleyen ve böylece aşırı öğrenmenin (overfitting) önüne geçmeye yardımcı olan L2 düzenlemesi uygulanır; burada λ||W3||22 formülü kullanılır. Burada W3, sinir ağındaki belirli bir katmanın ağırlık matrisidir; uygulanan düzenleme derecesi ise 0,01 olarak belirlenen λ düzenleme parametresi ile kontrol edilir. Denklem 14'te gösterildiği üzere, blok 3'ten aktarılan girişe yoğun katman ve L2 düzenlemesi uygulandıktan sonra yeni özellik temsili Z3 olur.
Ayrıca, eğitim sürecini hızlandırmak için yeni özellik Z3'e BatchNormalization katmanı uygulanmıştır; burada σ32 grup genelindeki varyansı, μ3 ise Z3 çıktısının ortalamasını temsil eder. ε ise sayısal kararlılık için eklenen küçük bir sabittir. Normalize edilmiş çıktı, model tarafından öğrenilebilir ölçek parametresi γ3 kullanılarak ayarlanabilir ve öğrenilebilir kaydırma parametresi β3 kullanılarak kaydırılabilir. Son olarak, Denklem 15'te gösterilen BatchNormalization katmanının uygulanmasının ardından, normalize edilmiş Z3 çıktısı, ağda lineer olmayan bir yapı oluşturan ve Denklem 16'da gösterilen leaky ReLU aktivasyon fonksiyonundan geçirilmiştir. Burada Z3, lineerlik dışı işlem gerçekleştirmek üzere Leaky ReLU'ya girdi olarak aktarılan BatchNormalization katmanı çıktısına aittir. A3 ise lineerlik dışı işlem uygulandıktan sonra elde edilen çıktıyı göstermektedir.
Son olarak, denklem 17'de gösterilen, Leaky ReLU aktivasyonundan girdi olarak alınan A3 çıktısına bir dropout katmanı uygulanır. Burada A3, son ReLU aktivasyon fonksiyonundan alınan çıktıyı; p3 ise nöronların bir kısmını devre dışı bırakmak için bu blok için 0,1 olarak seçilen dropout oranını temsil eder. Ayrıca A3′, dropout katmanı uygulandıktan sonra, bazı nöronların 0'a ayarlandığı modifiye edilmiş çıktıyı göstermektedir.
Ayrıca, blok 3 A3′ çıktısı, veri setindeki gerçek sınıf sayısını temsil eden K sayıda nörona sahip olan son yoğun katmandan sınıflandırma amacıyla geçirilmiştir; bu durum aşağıdaki denklem 18'de açıklanmıştır.
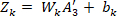 (18)
Kalın katmanla ilişkili ağırlık matrisi, 256 boyutlu A3′ vektörünü, önceki bloktan öğrenilen özellikleri temsil eden ve çıktı olarak gelen k-boyutlu vektöre dönüştürmekten sorumlu olan Wk'dir. Ayrıca, bk girdinin sıfır olduğu durumlarda aktivasyon fonksiyonunun sıfır olmayan bir çıktı vermesini sağlamak için tahmini ayarlayan sapma (bias) vektörünü temsil eder ve Zk aktivasyon fonksiyonu uygulanmadan önceki son katmanın çıktısıdır; bu çıktı her bir sınıfa karşılık gelen logitleri üretir ve son olarak logit Zk'yı her bir sınıfın olasılığına dönüştüren SoftMax41 sınıflandırıcı uygulanmıştır; bu durum denklem 19 ve 20'de gösterilmiştir.
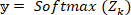 (19)
 (20)
iinci sınıfın öngörülen olasılığı yi ile, K sınıf sayısı, Zk, i iinci sınıfın logiti ve eZk, i ise iinci sınıfın logitinin eksponansiyeli ile temsil edilir. y, tüm olası sınıfların olasılık dağılımını gösterir ve olasılıkların toplamının 1 olmasını sağlar. Aşağıdaki Tablo 3, yeniden üretilebilirliği ve performansı artırmak için benimsenen mimari ayrıntılar da dahil olmak üzere, önerilen hibrit modeli eğitmek için kullanılan hiperparametre ayrıntılarını sunmaktadır.
| Hiper Parametreler | Önerilen Model (FusionNetX) |
| Görüntü boyutu | 224 × 224 |
| Omurga Mimarisi | BBA1 ve BBA2 olarak önceden eğitilmiş EfficientNetB7 ve DenseNet121 |
| Veri Artırımı | Rotasyon aralığı = 7, |
| Genişlik/yükseklik – kaydırma aralığı 0.05'e kadar, | |
| Yakınlaştırma aralığı 0.01'e kadar, | |
| Yatay/dikey – çevirme | |
| Veri bölme oranı | Sabit randome_state = 42 ile tabakalı örnekleme üzerinden eğitim için %80 ve doğrulama için %20 |
| Öznitelik çıkarımı ve füzyon | Her bir omurganın çıktısına küresel ortalama havuzlama uygulanır: BBA1 için 2560 ve BBA2 için 1024; 3584 ortak öznitelik vektörü elde etmek için birleştirilir. |
| Tam Bağlantılı Blok Kompozisyonu | 1 çıktı katmanlı 3 tam bağlantılı blok. Her blok sırasıyla L2 düzenlemesi (λ=0.01), BatchNormalization, LeakyReLU (α=0.01), (0.3, 0.2 ve 0.1) Dropout ve (1024, 512, 256) gizli boyut içerir. Füzyon kafasında ek bir Atlamalı bağlantı (Skip connection) kullanılmamıştır |
| Aktivasyon fonksiyonu | Leaky ReLU & SoftMax |
| Optimize edici ve Öğrenme oranı | Öğrenme oranı zamanlayıcısı olmaksızın sabit 0.00001 ile Adam. |
| Kayıp fonksiyonu | sparse_categorical_crossentropy |
| Yığın boyutu | 16 |
| Epoklar | Her veri seti için sabit 100 epok |
| Kullanılan platform | TensorFlow ve Keras platformları ile P100 GPU ve 16GB VRAM içeren Kaggle Notebook. |
Tablo 3: Önerilen modeli eğitmek için kullanılan hiperparametreler ve önerilen mimari detaylar.Bu tablo, ince ayarlı parametreler ve uygulama ortamıyla birlikte, önerilen modelin yapısal ve mimari detaylarını sunmaktadır.
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Sonuçlar
Bu bölüm; önerilen çift özellik füzyon modelinin Br35H, Figshare, Sartaj, Masoud ve Balanced Brain tumor veri setleri dahil olmak üzere beyin kanserleri üzerine beş açık kaynaklı veri seti üzerindeki test sonuçlarını ayrıntılı olarak açıklamaktadır ve modellerin performansı; doğruluk42,43,44, yanlış sınıflandırma oranı (MCR)45, PPV olarak da adlandırılan kesinlik46, NPV, duyarlılık...
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Tartışma
Sonuç olarak, önerilen model şu şekilde çalışmıştır: İlk olarak, herhangi bir derin öğrenme modelinin tüm önemli bilgileri korurken veri örneklerinden uygun özellikleri çıkarması ve öğrenmesi için orta karar bir boyut olan 224 × 224 görüntü boyutu seçilmiştir; ardından, veri örneklerini daha çeşitli yönlere getirerek modellerin farklı düzlemlerden veya açılardan özellik çıkarmasında önemli rol oynayan veri artırımı gerçekleştirilmiştir; burada rotasyon aralığı %7, genişlik ve yükseklik kaydırma aralığı 0,05 ve zum aralığ...
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Açıklamalar
Yazarların beyan edilecek herhangi bir durumu ve çıkar çatışması yoktur. Ayrıca, taslağın ve şekillerin oluşturulmasında herhangi bir yapay zeka aracı kullanılmamıştır.
Teşekkürler
Yazarlar, Prenses Nourah bint Abdulrahman Üniversitesi Araştırmacı Destek Projesi'nin (PNURSP2026R192), Prenses Nourah bint Abdulrahman Üniversitesi, Riyad, Suudi Arabistan tarafından sağlanan destekten dolayı minnettardır. Yazarlar ayrıca, bu araştırmaya katkıda bulunan araştırma katılımcılarına ve kurumlara teşekkür ederler.
Finansman:
Bu çalışma, Kore hükümeti (MSIT) tarafından finanse edilen Kore Ulusal Araştırma Vakfı (NRF) hibesi (No. RS-2023-00218176) ve Soonchunhyang Üniversitesi Araştırma Fonu tarafından desteklenmiştir. Prenses Nourah bint Abdulrahman Üniversitesi Araştırmacı Destek Projesi numara (PNURSP2026R192), Prenses Nourah bint Abdulrahman Üniversitesi, Riyad, Suudi Arabistan.
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Malzemeler
| Ad | Şirket | Katalog numarası | Yorumlar |
|---|---|---|---|
| Br35H Beyin Tümörü Veri Seti | Kaggle (veri seti katkıda bulunanı) | https://www.kaggle.com/datasets/ahmedhamada0/brain-tumor-detection | Genel veri seti; ikili sınıflandırma (tümör / tümör yok) 300 MRI görüntüsü |
| Figshare Beyin Tümörü Veri Seti | Kaggle / Figshare | https://doi.org/10.6084/m9.figshare.1512427 | Genel veri seti; çok sınıflı (glioma, meningioma, hipofiz tümörü) 3064 MRI görüntüsü |
| Sartaj Beyin Tümörü Sınıflandırma MRI Veri Seti | Kaggle (Sartaj Bhuvaji tarafından hazırlanan veri seti) | https://doi.org/10.34740/kaggle/dsv/12745533 | Genel veri seti; çok sınıflı (glioma, meningioma, tümör yok, hipofiz tümörü) 3264 MRI görüntüsü |
| Masoud Beyin Tümörü MRI Veri Seti | Kaggle (Masoud Nickparvar tarafından hazırlanan veri seti) | https://doi.org/10.34740/kaggle/dsv/14832123 | Genel veri seti; çok sınıflı (glioma, meningioma, tümör yok, hipofiz tümörü) 7023 MRI görüntüsü |
| BBT-Dataset (Beyin Tümörü Veri Seti) | Kaggle (veri seti katkıda bulunanı) | https://doi.org/10.34740/kaggle/dsv/6758053 | Genel veri seti; dengeli çok sınıflı beyin tümörü 5248 MRI görüntüsü |
| Python | Python Yazılım Vakfı | https://www.python.org | Programlama dili, sürüm 3.10.13 |
| TensorFlow / Keras | Google / TensorFlow geliştiricileri | https://www.tensorflow.org | Derin öğrenme çerçevesi; model kurulumu, eğitimi ve değerlendirmesi, sürüm 2.15.0 |
| EfficientNetB7 (önceden eğitilmiş) | Google / Keras Applications | https://keras.io/api/applications/efficientnet/ | ImageNet ile önceden eğitilmiş omurga; özellik çıkarma |
| DenseNet121 (önceden eğitilmiş) | Keras Applications | https://keras.io/api/applications/densenet/ | ImageNet ile önceden eğitilmiş omurga; özellik çıkarma |
| scikit-learn | scikit-learn geliştiricileri (NumFOCUS) | https://scikit-learn.org | Etiket kodlama, eğitim-test ayırımı, değerlendirme metrikleri (sınıflandırma raporu, karışıklık matrisi, ROC/AUC) |
| OpenCV (cv2) | OpenCV ekibi | https://opencv.org | Görüntü yükleme ve yeniden boyutlandırma |
| NumPy | NumPy geliştiricileri (NumFOCUS) | https://numpy.org | Sayısal hesaplama ve dizi işlemleri |
| pandas | pandas geliştirme ekibi (NumFOCUS) | https://pandas.pydata.org | Veri düzenleme ve metriklerin tablo haline getirilmesi |
Kaynaklar
- He Z, et al. A review on methods for diagnosis of breast cancer cells and tissues. Cell Prolif. 2020;53(7):e12822. doi:10.1111/cpr.12822.
- Siegel RL, Giaquinto AN, Jemal A. Cancer statistics, 2024. CA Cancer J Clin. 2024;74(1):12–49.
- Varuna Shree N, Kumar TNR. Identification and classification of brain tumor MRI images with feature extraction using DWT and probabilistic neural network. Brain Inform. 2018;5(1):23–30.
- Ghoreishi Mokri SM, Valadbeygi N, Grigoryeva V. Diagnosis of glioma, menigioma and pituitary brain tumor using MRI images recognition by deep learning in Python. EAI Endorsed Trans Intell Syst Mach Learn Appl. 2024;1:1–9.
- Sadeghi MH, et al. Deep learning in ovarian cancer diagnosis: a comprehensive review of various imaging modalities. Pol J Radiol. 2024;89:e30–e48.
- Anari S, Safarpour H, Cunneen M, Bendechache M. AR-EpiAid: an augmented reality decision support system for real-time interpretation of multimodal epilepsy data [conference paper]. Presented at: 3rd International Conference on Artificial Intelligence, Computer, Data Sciences, and Applications; Boracay Island, Philippines; 2026. https://doi.org/10.1109/ACDSA67686.2026.11468245.
- Iyortsuun NK, et al. A review of machine learning and deep learning approaches on mental health diagnosis. Healthcare (Basel). 2023;11(3):285. doi:10.3390/healthcare11030285.
- An Q, Rahman S, Zhou J, Kang JJ. A comprehensive review on machine learning in the healthcare industry: classification, restrictions, opportunities, and challenges. Sensors (Basel). 2023;23(9):4178. doi:10.3390/s23094178.
- Iqbal S, Qureshi AN, Li J, Mahmood T. On the analyses of medical images using traditional machine learning techniques and convolutional neural networks. Arch Comput Methods Eng. 2023;30:3173–3233.
- Chhimpa GR, et al. A transfer learning-driven fine-tuning of YOLOv10 for improved brain tumor detection in MRI images. Sci Rep. 2026;16:98. doi:10.1038/s41598-025-28813-w.
- Akbarian S, Seyyed-Kalantari L, Khalvati F, Dolatabadi E. Evaluating knowledge transfer in the neural network for medical images. IEEE Access. 2023;11. doi:10.1109/ACCESS.2023.3283216.
- Meena G, Mohbey KK, Acharya M, Lokesh K. An improved convolutional neural network-based model for detecting brain tumors from augmented MRI images. J Auton Intell. 2023;6:1–19.
- Ata MM, Yousef RN, Karim FK, Khafaga DS. An improved deep structure for accurately recognizing brain tumors. Comput Syst Sci Eng. 2023;46(2):1597–1616.
- Khushi HMT, et al. Performance analysis of state-of-the-art CNN architectures for brain tumour detection. Int J Imaging Syst Technol. 2024;34:e22949. doi:10.1002/ima.22949.
- Agarwal M, et al. Deep learning for enhanced brain tumor detection and classification. Results Eng. 2024;22:102117. doi:10.1016/j.rineng.2024.102117.
- Peddinti AS, Maloji S. Optimised ResNet50 for multiclass classification of brain tumors. Scalable Comput Pract Exp. 2024;25(3):1667–1680.
- Zahoor MM, et al. Brain tumor MRI classification using a novel deep residual and regional CNN. Biomedicines. 2024;12(7):1395. doi:10.3390/biomedicines12071395.
- Chen W, et al. A robust approach for multitype classification of brain tumors using deep feature fusion. Front Neurosci. 2024;18:1288274. doi:10.3389/fnins.2024.1288274.
- Suryawanshi S, Patil SB. Efficient brain tumor classification with a hybrid CNN-SVM approach in MRI. J Adv Inf Technol. 2024;15:340–354.
- Reyes D, Sánchez J. Performance of convolutional neural networks for the classification of brain tumors using magnetic resonance imaging. Heliyon. 2024;10:e25468. doi:10.1016/j.heliyon.2024.e25468.
- Bibi N, et al. A transfer learning-based approach for brain tumor classification. IEEE Access. 2024;12:111218–111238.
- Albalawi E, et al. Integrated approach of federated learning with transfer learning for classification and diagnosis of brain tumor. BMC Med Imaging. 2024;24:110. doi:10.1186/s12880-024-01261-0.
- Alkhatib AJ, et al. Diagnosing brain tumors from MRI images through a multi-fused CNN with auxiliary layers. Sustain Mach Intell J. 2024;6(1):4–13.
- Hamada A. Br35H: Brain Tumor Detection 2020 [dataset]. Kaggle; 2020. Available from: https://www.kaggle.com/datasets/ahmedhamada0/brain-tumor-detection.
- Cheng J. Brain tumor dataset [dataset]. Figshare; 2024. Available from: https://doi.org/10.6084/m9.figshare.1512427.
- Bhuvaji S. Brain Tumor Classification (MRI) [dataset]. Kaggle; cited 2026 Jul 30. Available from: https://doi.org/10.34740/kaggle/dsv/12745533.
- Nickparvar M. Brain Tumor MRI Dataset [dataset]. Kaggle; cited 2026 Jul 30. Available from: https://doi.org/10.34740/kaggle/dsv/14832123.
- Jayanti V. Brain Tumor MRIs [dataset]. Kaggle; cited 2026 Jul 30. Available from: https://doi.org/10.34740/kaggle/dsv/6758053.
- Tuteja P, et al. Augmented multimodal fusion for optimized brain tumor detection: evaluation and comparative analysis. J Vis Exp. 2025;(220):e67822. doi:10.3791/67822.
- Rasool N, et al. CNN-TumorNet: leveraging explainability in deep learning for precise brain tumor diagnosis on MRI images. Front Oncol. 2025;15:1554559. doi:10.3389/fonc.2025.1554559.
- Huang G, Liu Z, van der Maaten L, Weinberger KQ. Densely connected convolutional networks [conference paper]. Presented at: IEEE Conference on Computer Vision and Pattern Recognition; Honolulu, HI, USA; 2017. p. 4700–4708. Available from: https://openaccess.thecvf.com/content_cvpr_2017/html/Huang_Densely_Connected_Convolutional_CVPR_2017_paper.html.
- Tuteja P, Wani MA, Wani NA, Bedi J. EASE-Net: an explainable AI-based segmentation and ensemble network for interpretable brain tumor diagnosis and classification in MRI images. Arab J Sci Eng. 2026;in press. doi:10.1007/s13369-026-11350-7.
- Tan M, Le QV. EfficientNet: rethinking model scaling for convolutional neural networks [conference paper]. Presented at: 36th International Conference on Machine Learning; Long Beach, CA, USA; 2019. p. 6105–6114. Available from: https://proceedings.mlr.press/v97/tan19a.html.
- Vellaichamy AS, Swaminathan A, Varun C, Kalaivani S. Multiple plant leaf disease classification using DenseNet-121 architecture. Int J Electr Eng Technol. 2021;12(5):38–57.
- Naidji MR, Elberrichi Z. Automatic detection of COVID-19 from chest X-ray images using the EfficientNet-B7 CNN model with channel-wise attention. Int J Comput Digit Syst. 2024;15:1443–1456.
- Malla PP, Sahu S, Alutaibi AI. Classification of tumors in brain MR images using a deep convolutional neural network and global average pooling. Processes. 2023;11(3):679. doi:10.3390/pr11030679.
- Shi G, Zhang J, Li H, Wang C. Enhance the performance of deep neural networks via L2 regularization on the input of activations. Neural Process Lett. 2019;50:57–75.
- Srivastava N, et al. Dropout: a simple way to prevent neural networks from overfitting. J Mach Learn Res. 2014;15:1929–1958.
- Ioffe S, Szegedy C. Batch normalization: accelerating deep network training by reducing internal covariate shift [conference paper]. Presented at: 32nd International Conference on Machine Learning; Lille, France; 2015. p. 448–456. Available from: https://proceedings.mlr.press/v37/ioffe15.html.
- Varshney M, Singh P. Optimizing nonlinear activation functions for convolutional neural networks. Signal Image Video Process. 2021;15:1323–1330.
- Bera S, Shrivastava VK. Analysis of various optimizers on a deep convolutional neural network model in the application of hyperspectral remote-sensing image classification. Int J Remote Sens. 2020;41:2664–2683.
- Safarpour H, et al. A dual-phase segmentation framework utilizing Gumbel-Softmax and a cascaded Swin Transformer for multiclass brain tumor segmentation. Research Square. 2025:doi:10.21203/rs.3.rs-7093467/v1.
- Seyrek EC, Uysal M. A comparative analysis of various activation functions and optimizers in a convolutional neural network for hyperspectral image classification. Multimed Tools Appl. 2024;83:53785–53816.
- Maxwell AE, Warner TA, Guillén LA. Accuracy assessment in convolutional neural network-based deep-learning remote-sensing studies—part 1: literature review. Remote Sens (Basel). 2021;13(13):2450. doi:10.3390/rs13132450.
- Villon S, et al. A new method to control error rates in automated species identification with deep-learning algorithms. Sci Rep. 2020;10:10972. doi:10.1038/s41598-020-67573-7.
- Rasool N, et al. TransResUNet: revolutionizing glioma brain tumor segmentation through transformer-enhanced residual UNet. IEEE Access. 2024;12:72105–72116.
- Chen Y, et al. Evaluation efficiency of hybrid deep-learning algorithms with neural-network decision-tree and boosting methods for predicting groundwater potential. Geocarto Int. 2022;37:5564–5584.
- Alakus TB, Turkoglu I. Comparison of deep-learning approaches to predict COVID-19 infection. Chaos Solitons Fractals. 2020;140:110120. doi:10.1016/j.chaos.2020.110120.
- Ranjbarzadeh R, et al. Explainable attention-guided Swin Transformer networks for brain tumor segmentation from 3D MRI. Lect Notes Netw Syst. 2026;1730:110–128. Available from: https://lero.ie/bibliography/explainable-attention-guided-swin-transformer-networks-for-brain-tumor-segmentation-from-3d-mri/.
- Ranjbarzadeh R, et al. A global-local 3D brain tumor segmentation model using vision transformers and axial state-space modeling [conference paper]. Presented at: 3rd International Conference on Artificial Intelligence, Computer, Data Sciences, and Applications; Boracay Island, Philippines; 2026. https://doi.org/10.1109/ACDSA67686.2026.11468214.
- Hussain SS, et al. Next-generation automation in neuro-oncology: advanced neural networks for MRI-based brain tumor segmentation and classification. IEEE Access. 2025;13:41141–41158.
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.