Bu protokol; tamamlayıcı EEG temsillerini, çift uzaylı görsel hizalamayı ve difüzyon kod çözümlemesini birleştiren bir EEG-den-görüntüye yeniden yapılandırma çerçevesi olan Üç Akışlı Ayrıştırılmış Ağ'ı (TDE-Net) sunmaktadır.
Yöntem makalesi
THINGS-EEG2 Üzerinde Elektroensefalografi Tabanlı Görüntü Rekonstrüksiyonu için Adaptif Çift Alan Füzyonlu Üç Akışlı Ayrıştırılmış Ağ
Bu makalede
Özet
Özet
Non-invaziv elektroensefalografi (EEG) verilerinden görsel uyaranların yeniden yapılandırılması, sınırlı uzamsal örneklemeye rağmen kısa ve gürültülü nöral yanıtların anlamlı görsel temsilere eşlenmesini gerektirir. Mevcut EEG-görüntü yaklaşımları, yapısal ve semantik katkıları birbirinden ayıran tekrarlanabilir iş akışlarını zorunlu kılan çeşitli nöral temsiller ve üretici stratejiler kullanmaktadır. Bu protokol, EEG tabanlı görüntü yeniden yapılandırması için hesaplamalı bir çerçeve olan Üç Akışlı Ayrıştırılmış Ağ'ı (Tri-stream Disentangled Network, TDE-Net) sunmaktadır. Protokol, ön işlenmiş THINGS-EEG2 kayıtlarını kullanmakta ve EEG bilgilerini ham bir EEG çapası, örneğe özgü bir fonksiyonel grafik akışı ve çok ölçekli bir zamansal semantik akış şeklinde düzenlemektedir. Grafik akışı, grafik konvolüsyonu ve denemeler arası karşıtlı öğrenme aracılığıyla EEG kanalları arasındaki frekans alanı ilişkilerini yakalarken, semantik akış adaptif uzamsal ağırlıklandırma ve çok ölçekli zamansal konvolüsyonlar aracılığıyla görevle ilgili özellikleri çıkarmaktadır. Yapısal ve semantik özellikler, varyasyonel otokodlayıcı (VAE) ve Contrastive Language-Image Pre-training (CLIP) gizil uzaylarına ayrı ayrı eşlenmekte, geliştirme setiyle seçilen füzyon ağırlıkları kullanılarak birleştirilmekte ve Stable UnCLIP kullanılarak çözümlenmektedir. 10 katılımcı üzerinde TDE-Net, 0,8135 ortalama CLIP ikili tanımlama doğruluğuna ulaşmış ve tamamlayıcı metrikler yapısal ve özellik uzayı uyumunu kanıtlamıştır. Ablasyon ve temsil düzeyindeki analizler, bireysel akışların katkılarını daha detaylı şekilde tanımlamıştır. Bu protokol, tamamlayıcı EEG temsillerinin ve difüzyon tabanlı görsel yeniden yapılandırmanın incelenmesi için tekrarlanabilir bir çerçeve sağlamaktadır.
Giriş
Görsel algı kod çözme, beyin-bilgisayar arayüzleri (BCI'lar) ve bilişsel nörobilim alanlarında disiplinler arası bir araştırma alanıdır. Fonksiyonel manyetik rezonans görüntüleme (fMRI) gerçekçi görüntü rekonstrüksiyonuna olanak sağlamıştır1,2,3,4, ancak maliyeti, sınırlı taşınabilirliği ve hemodinamik gecikmesi bazı uygulamaları kısıtlamaktadır. Elektroensefalografi (EEG), nispeten erişilebilir enstrümantasyon ile milisaniye ölçeğinde zamansal ölçümler sağlar, ancak düşük sinyal-gürültü oranı ve sınırlı uzamsal örneklemesi, EEG'den görüntüye rekonstrüksiyonu zorlaştırmaktadır.
Yöntem karmaşıklığı, genel yanlılık-varyans dengesi ışığında yorumlanmalıdır5. Erken dönem görsel kod çözme yöntemleri sığ veya doğrusal temsiller kullanırken, daha sonraki çalışmalar kompakt konvolüsyonel, graf tabanlı ve dikkat tabanlı kodlayıcılar tanıtmıştır6,7,8,9,10,11. Çapraz modal hizalama da multimodal özellik öğreniminden12,13 gizil difüzyon modellerine ve büyük görme kodlayıcılarına14,15,16 doğru ilerlemiştir. Bu yaklaşımlar yararlı temel çizgiler oluşturur, ancak giriş temsilleri, gizil hedefleri ve kod çözücüleri farklıdır; bu nedenle sonuçlar kendi deneysel ortamları dahilinde yorumlanmalıdır.
TDE-Net'in amacı; yapısal ve semantik EEG temsillerini birbirinden ayıran, bunları tamamlayıcı görsel latent uzaylarla hizalayan ve difüzyon tabanlı görüntü yeniden yapılandırması için bu tahminleri entegre eden modüler bir EEG-görüntü yeniden yapılandırma çerçevesi sunmaktır. Yakın zamandaki EEG-görsel kod çözme çalışmaları; EEG-CLIP'te17 transformer tabanlı EEG yönlendirmeli üretimi, FSDBN'de18 dinamik beyin ağları ile ön plan farkındalıklı hizalamayı, bilgi kısıtlamalı hizalama ile bilişsel yönlendirmeli adaptif bulanıklaştırmayı19 ve çok seviyeli çift yönlü biyomimetik öğrenmeyi20 tanıtmıştır. Perceptogram ve EEG gömülmelerine dayalı yönlendirmeli difüzyon dahil olmak üzere ilgili EEG-görüntü işlem hatları, latent tahmin için ek referanslar sağlamaktadır21,22. TDE-Net, model organizasyonu açısından farklılık gösterir: ham bir EEG çapası, örne özel bir fonksiyonel grafik temsili ve zamansal bir semantik temsili açıkça birbirinden ayırır ve ardından füzyon öncesinde VAE ve CLIP uzaylarına asimetrik hizalama gerçekleştirir. Bu organizasyon, yapısal ve semantik katkıların latent uzay ve görüntü seviyesi analizleri aracılığıyla ayrı ayrı incelenmesine olanak tanır. Tek temsilli veya doğrudan hizalanmış EEG-görüntü yaklaşımlarıyla karşılaştırıldığında, bu modüler tasarım ayrı yapısal ve semantik yollar sunar, latent tahmin sırasında doğrusal bir EEG referansı korur ve her bir temsilin katkısının ablasyon ve latent uzay analizleri yoluyla bağımsız olarak değerlendirilmesine imkan verir.
TDE-Net; eşleştirilmiş EEG yanıtları ve görsel uyaranların bulunduğu, eğitim koşullarının yeterli olduğu ve semantik yeniden yapılandırmanın temel amacın olduğu kısa bir uyaran sonrası pencereye sahip deneyler için tasarlanmıştır. Kademeli organizasyonu; özellik çıkarımı, latent hizalama, füzyon ve difüzyon kodlamasının ayrı ayrı incelenmesini destekler. Doğrusal eşlemeler, çok küçük veri setleri veya minimum model karmaşıklığına öncelik veren durumlar için uygun kalırken; büyük göreve özgü veri setlerinin ve gerçek zamanlı uygulamanın mevcut olduğu durumlarda uçtan uca nöral kodlayıcılar tercih edilebilir.
Bu protokol, önerilen konfigürasyonu THINGS-EEG2 hızlı seri görsel sunum (RSVP) ortamında değerlendirmektedir. Temel katkılar arasında; ham lineer bir çapa, örne özel bir fonksiyonel grafik akışı ve çok ölçekli bir zamansal semantik akıştan oluşan üç akışlı bir EEG temsil şeması yer almaktadır. Bu tamamlayıcı temsiller, VAE ve CLIP gizli uzaylarına eşlenmekte ve ilgili tahminler difüzyon kodlamasından önce birleştirilmektedir. Çerçeve, tüm 10 THINGS-EEG2 deneği üzerinde; denek düzeyinde yeniden yapılandırma ölçümleri, ablasyon ve zamansal pencere analizleri ve temsil düzeyinde görselleştirmeler kullanılarak değerlendirilmiş, uzamsal dikkat haritaları ise kafa derisi kanalı (topografik) analizleri olarak yorumlanmıştır.
Protokol
Protokol altı ardışık aşamadan oluşmaktadır: EEG denemelerinin ve görüntü latentlerinin hazırlanması; grafik yapısal akışının oluşturulması; semantik EEG kodlayıcısının eğitilmesi; CLIP/VAE eşlemelerinin uydurulması; latent tahminlerin füzyonu ve ardından görüntü kod çözümü; ve görüntü düzeyi ile temsil düzeyi sonuçlarının değerlendirilmesi (Şekil 1).
1. EEG denemelerini ve görüntü gömmelerini hazırlayın
- Kaynak kohortu ve edinim protokolünü belgeleyin.
NOT: Kaynak kohort, normal veya düzeltilmiş-normal görme yetisine sahip 10 sağlıklı yetişkinden (ortalıЗО yaş 28,5 yıl, SD 4,0; sekiz kadın ve iki erkek) oluşmuştur. Katılımcılar yazılı onam vermiş, parasal tazminat almış ve Helsinki Deklarasyonu'na23 uygun olarak Freie Universität Berlin Eğitim ve Psikoloji Bölümü etik kurulunun onayıyla orijinal protokolü tamamlamıştır.- İkincil analiz kaynağı olarak halka açık THINGS-EEG2 veri setini kullanın.
- THINGS'den alınan, 27 üst düzey kategorinin bölümler arasında dengelendiği, 1.654 eğitim kavramı ve 200 örtüşmeyen test kavramından oluşan kaynak bölümü kullanın. 16.540 eğitim koşulu ve 200 ayrılmış test koşulu elde etmek için her eğitim kavramı için on adet doğal arka plan görüntüsü ve her test kavramı için bir görüntü seçin.
NOT: Mevcut çalışmada, hedef algılama görevi için mevcut yeniden yapılandırma analizinden hariç tutulan ayrı Buzz Lightyear yakalama görüntüleri kullanılmıştır23. - Epokları yorumlarken orijinal hızlı seri görsel sunum protokolünün zamanlamasını takip edin.
NOT: Her sekans 750 ms'lik bir boşluk aralığı ile başlamış ve ardından merkezde sunulan 20 görüntü gelmiştir. Her görüntü 7 derecelik bir görsel açı kaplamış, ekranda 100 ms kalmış ve 5 görüntü/s'ye karşılık gelen 200 ms'lik bir stimulus-onset asenkronisine sahip olmuştur. İkinci bir 750 ms'lik boşluk aralığı, katılımcıların önce göz kırptığı ve ardından bir hedef görüntünün görünüp görünmediğini bildirdiği 2 saniyeye kadar süren bir yanıt döneminden önce gelmiştir. Sekans boyunca merkezi bir hedef sabitleme noktası görünür kalmıştır23. - Veri setini düzenlerken orijinal kayıt oturumu yapısını dikkate alın. Her katılımcı tarafından tamamlanan dört kayıt oturumundan gelen verileri kullanın; her oturum yaklaşık 5 dakikalık dört test denemesi ve 15 eğitim denemesinden oluşmaktadır. Her eğitim koşulu için dört tekrarı ve her test koşulu için 80 tekrarı koruyun; bu, katılımcı başına analiz edilen 82.160 hedef olmayan görüntü denemesine karşılık gelir23.
- Orijinal THINGS-EEG2 kayıt konfigürasyonu ile edinilen EEG verilerini kullanın. Bu kayıtlar, uluslararası 10-10 sistemine göre düzenlenmiş 64 elektrotlu bir EASYCAP ve bir BrainVision actiCHamp amplifikatörü kullanılarak, çevrimiçi referans olarak Fz ve çevrimiçi 0,1–100 Hz bant geçiren filtre ile 1.000 Hz'de edinilmiştir.
- Görüntü başlangıcına göre -200 ile 800 ms arasında epoklanmış, stimülasyon öncesi aralık kullanılarak baz çizgisi düzeltmesi yapılmış, 100 Hz'e downsample edilmiş, 17 parieto-oksipital kanal ile sınırlandırılmış, hedef denemelerden temizlenmiş ve her kayıt oturumu içinde bağımsız olarak çok değişkenli gürültü normalizasyonuna tabi tutulmuş yayınlanan ön işlenmiş verileri kullanın23.
- EEG deneme tensörlerini hazırlayın
- Tüm 10 katılımcı için yayınlanan ön işlenmiş THINGS-EEG2 tensörlerini yükleyin. Her kaynak epoktan, deneme başına 80 zaman noktası elde etmek için stimülasyon sonrası 0–800 ms aralığını ve 17 parieto-oksipital kanalı seçin ve 100 Hz örnekleme hızını koruyun. Her katılımcı için 16.540 eğitim görüntüsü koşulu ve 200 ayrılmış test görüntüsü koşulundan oluşan kaynak bölümünü koruyun23 (Şekil 2).
- Graf-akışı ön eğitimi için, her görüntü koşulu için dört bağımsız eğitim tekrarını koruyun ve pozitif bir çift oluşturmak için iki tekrar örnekleyin. Ham ve semantik akışlar için, dört eğitim tekrarının ortalamasını alın ve her koşul için mevcut 80 test tekrarının ortalamasını alın.
- Orijinal MVNN hattı tarafından üretilen ön işlenmiş THINGS-EEG2 tensörlerini kullanın; uygulanan her öznitelik çıkarıcı içinde, öznitelik hesaplamasından önce belgelenmiş dosya düzeyinde Z-skorlamasını uygulayın.
NOT: Tekrarların bu asimetrik kullanımı kasıtlıdır: tekrarlanan denemeler graf-akışı kontrastif ön eğitimi için pozitif çiftler sağlarken, ham ve semantik akışlar gözetimli eşleme için koşul düzeyindeki ortalamaları kullanır. Ortaya çıkan tasarım, yapısal akıştaki tekrar düzeyindeki değişmezlik öğrenimini, ham ve semantik akışlardaki koşul düzeyindeki gizli tahmin ile birleştirir.
- Eşleştirilmiş görüntü latentlerini hazırlayın
- Eşleştirilmiş görüntü hedeflerini çıkarmak için 1.024 boyutlu CLIP vizyon kodlayıcısını ve sd2-community/stable-diffusion-2-1-unclip ile ilişkili VAE kodlayıcısını kullanın. VAE giriş görüntülerini 768 x 768 piksele yeniden boyutlandırın, VAE posterior modunu 36.864 boyutlu bir vektör (4 x 96 x 96) olarak saklayın ve görüntü-koşul sırasını koruyun.
- Üç giriş formu kaydedin: graf kontrastif öğrenimi için tekrarlanan deneme tensörleri, ham ve semantik akışlar için ortalanmış EEG tensörleri ve gözetimli eşleme için eşleştirilmiş CLIP/VAE görüntü latentleri.
- Girişleri normalize edin ve önbelleğe alın
- Ön işlenmiş EEG tensörlerini, çıkarılan graf ve semantik öznitelikleri ve eşleştirilmiş görüntü latentlerini sabit koşul sıralamasıyla önbelleğe alın.
- Ridge eşleme sırasında, öznitelik bazlı standartlaştırma parametrelerini eğitim girişlerinden tahmin edin ve bu parametreleri geliştirme ve test girişlerine uygulayın.
2. Graf yapısal akışını oluşturun
- Tekrarlanan eğitim denemelerinden grafik akışını oluşturun ve kontrastif ön eğitimden sonra düğüm düzeyindeki özellikleri dışa aktarın. Özellik hesaplaması sırasında test görüntü latentlerini kullanmadan, test özellik çıkarımı için aynı grafik oluşturma kuralını kullanın.
- EEG denemelerini frekans düzlemi grafik girişlerine dönüştürün
- Her denemeyi 80 noktalı hızlı Fourier dönüşümü (FFT) ile dönüştürün ve 100 Hz örnekleme hızında 0 Hz–48.75 Hz arasını kapsayan ilk 40 negatif olmayan frekans kutusunu (bin) tutun. Log-genlik spektrumunu 17 x 40 boyutunda bir düğüm-özellik matrisi X olarak kullanın. Her EEG örneği için, 17 kanal özellik vektörünün her çifti arasında C_ij = |corr(X_i, X_j)| değerini hesaplayın.
- Her satırda, diyagonal öz-korelasyonu ve en güçlü üç diyagonal dışı korelasyonu tutun (öz-korelasyon dahil k = 4 tutulan giriş), ardından örneğe özgü ağırlıklı fonksiyonel komşuluk A'yı tanımlamak için tutulan matrisi simetrileştirin. Grafik konvolüsyonundan önce simetrik derece normalizasyonu uygulayın.
- Eğitim ve test sırasında bu yöntemi kullanın; sabit bir grafik tanımlamak için elektrot fiziksel koordinatları kullanılmaz.
NOT: Öz-bağlantının tutulması her düğümün sinyalini korur, oysa kanal içi bağlantıların satır başına 3 ile sınırlandırılması simetrileştirme öncesinde grafik yoğunluğunu kontrol eder. Frekans düzlemi temsili, grafik oluşturma için kompakt bir genlik tabanlı açıklama sağlar ancak fazı veya tüm ince taneli faz-kilitli ERP zamanlamasını korumaz; bu zamansal yönler ham çapa ve semantik zamansal akışlarda mevcut kalmaya devam eder.
- Elektrot topolojisini spektral grafik konvolüsyonu ile birleştirin
- Katman başına 80 gizli birim, ReLU aktivasyonları, 0.3 dropout, simetrik derece normalizasyonu ve ortalama grafik havuzlama içeren beş katmanlı bir grafik konvolüsyonel ağ (GCN)24 uygulayın.
- Kontrastif hedef için 80 boyutlu iki katmanlı bir projeksiyon başlığı kullanın ve yapısal füzyon için 17 x 80 boyutundaki düğüm düzeyindeki temsili dışa aktarın. Girişe bağımlı komşuluk matrisine spektral grafik konvolüsyonu uygulayın; ayrı bir dinamik konvolüsyon operatörü eklemeyin.
- Grafik akışını denemeler arası kontrastif öğrenme ile eğitin
- Eğitim bölümü içinde, aynı görüntü koşulundan rastgele iki tekrarı pozitif çift olarak seçin ve yığındaki diğer koşullardan gelen temsilleri negatif olarak değerlendirin. τ = 0.5 sıcaklık, 32 yığın boyutu, 5 x 10⁻⁴ öğrenme hızına sahip Adam, 20 epoch, eta_min = 10–6'ya kosinüs tavlaması ve 42 rastgele tohumu ile InfoNCE kontrastif hedefini25 optimize edin.
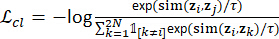 (1)
- Kontrastif hedefte kosinüs benzerliğini tanımlayın ve eşleşmiş tekrarları belirlemek için gösterge fonksiyonunu kullanın. Projeksiyon boyutunu 80'de tutun ve kontrastif kaybın her iki yönüne aynı sıcaklığı uygulayın.
- Eğitim bölümü içinde, aynı görüntü koşulundan rastgele iki tekrarı pozitif çift olarak seçin ve yığındaki diğer koşullardan gelen temsilleri negatif olarak değerlendirin. τ = 0.5 sıcaklık, 32 yığın boyutu, 5 x 10⁻⁴ öğrenme hızına sahip Adam, 20 epoch, eta_min = 10–6'ya kosinüs tavlaması ve 42 rastgele tohumu ile InfoNCE kontrastif hedefini25 optimize edin.
- Erken füzyon için düğüm düzeyindeki grafik özelliklerini dışa aktarın
- Ön eğitimden sonra grafik kodlayıcıyı dondurun ve düğüm başına 80 boyutlu 17 kanal düğüm özelliklerini dışa aktarın. VAE eşlemesi için ham-artı-grafik yapısal girişini elde etmek amacıyla bu özellikleri özellik boyutu boyunca ortalanmış ham EEG ile birleştirin.
- Sonuçtaki ham-artı-grafik özellik tensörünü kaydedin ve bunu yalnızca VAE regresyon dalının yapısal girişi olarak kullanın.
3. Semantik EEG kodlayıcıyı eğitin
- Semantik EEG kodlayıcısını ortalaması alınmış 17 kanallı, 80 noktalı EEG tensörleri üzerinde eğitin.
- Kosinüs gömme kaybını AdamW (öğrenme hızı 5 x 10⁻⁴; ağırlık azalımı 0.01), 64 grup boyutu, 50 epok, eta_min = 10–6 değerine kosinüs tavlaması, 42 rastgele tohumu ve 1.024 boyutlu bir çıktı ile optimize edin.
- Veri güdümlü adaptif uzamsal filtreleme uygulayın
- Giriş EEG tensörüne öğrenilebilir bir tensör-çarpım kanal ağırlıklandırma işlemi uygulayın ve temsili 9 derinliğe genişletin. Bu işlemi, klasik Ortak Uzamsal Desen (CSP) uzamsal filtresinin26 bir uygulaması olarak değil, veri güdümlü bir kanal ağırlıklandırma katmanı olarak değerlendirin.
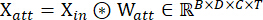 (2)
- Dokuz özellik haritası üretmek için öğrenilen kanal ağırlıklandırma işlemini kullanın, ardından bunları çok ölçekli zamansal konvolüsyon bloğuna aktarın.
- Giriş EEG tensörüne öğrenilebilir bir tensör-çarpım kanal ağırlıklandırma işlemi uygulayın ve temsili 9 derinliğe genişletin. Bu işlemi, klasik Ortak Uzamsal Desen (CSP) uzamsal filtresinin26 bir uygulaması olarak değil, veri güdümlü bir kanal ağırlıklandırma katmanı olarak değerlendirin.
- Zamansal alıcı alanları çoklu ölçeklerde modelleyin
- Aynı uzunlukta dolgu kullanarak, 5, 15 ve 31 örnek çekirdek boyutlarına sahip üç paralel zamansal konvolüsyon uygulayın. 24 zamansal özellik kanalı elde etmek için üç çıktıyı birleştirin ve grup normalizasyonu ile GELU aktivasyonu uygulayın.
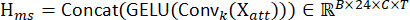 (3)
NOT: Konvolüsyonlar, daha geniş zamansal konvolüsyonel modelleme çerçevesi27 içerisinde çok ölçekli zamansal alıcı alanlar sağlar. - Üç çekirdek boyutunu çok ölçekli zamansal filtreler olarak kullanın; çıktılarını belirli ERP bileşenlerine doğrudan atamalar olarak değil, öğrenilmiş sinyal temsilleri olarak yorumlayın.
- Aynı uzunlukta dolgu kullanarak, 5, 15 ve 31 örnek çekirdek boyutlarına sahip üç paralel zamansal konvolüsyon uygulayın. 24 zamansal özellik kanalı elde etmek için üç çıktıyı birleştirin ve grup normalizasyonu ile GELU aktivasyonu uygulayın.
- Görevle ilgili özellik kanallarını yeniden kalibre edin
- Kanal yeniden kalibrasyon ilkeleriyle28 uyumlu olarak, zamansal boyuta adaptif ortalama havuzlama ve ardından Softmax normalizasyonu ile takip edilen çekirdek-7 konvolüsyon içeren derinlik dikkati uygulayın. Ortaya çıkan dikkat ağırlıklarını çok ölçekli özellik tensörü ile eleman bazında çarpın.
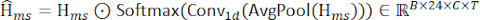 (4)
- Dikkat çıktısını uzamsal konvolüsyon bloğuna giriş olarak kullanın ve öğrenilen ağırlıkları nedensel nöral lokalizasyon olarak yorumlamayın.
- Kanal yeniden kalibrasyon ilkeleriyle28 uyumlu olarak, zamansal boyuta adaptif ortalama havuzlama ve ardından Softmax normalizasyonu ile takip edilen çekirdek-7 konvolüsyon içeren derinlik dikkati uygulayın. Ortaya çıkan dikkat ağırlıklarını çok ölçekli özellik tensörü ile eleman bazında çarpın.
- Global semantik EEG özelliğini dışa aktarın
- 1 x 1 konvolüsyonu, ardından 17 elektrot kanalını kapsayan derinlik bazlı konvolüsyon, grup normalizasyonu, GELU aktivasyonu, faktörü 2 olan ortalama havuzlama ve p = 0.5 dropout uygulayın. Sonucu düzleştirin ve 1.024 boyutlu bir semantik özellik vektörüne projekte edin.
- Ortalaması alınmış her EEG örneği için bir adet 1.024 boyutlu semantik özellik vektörü kaydedin.
4. EEG özelliklerini CLIP ve VAE latent uzaylarına eşleyin
- Her bir EEG özellik tensörünü aynı koşul indeksine sahip görüntü gizil değişkeni ile eşleştirin. CLIP ve VAE hedefleri için ayrı eşlemeler kurun ve eğitim bölümündeki tüm görüntü koşullarının, ayrılmış test bölümündekilerden farklı olduğundan emin olun.
- Bir kesim noktası ve maksimum 50.000 iterasyon ile ridge regresyonu29 uygulayın. Ham-veriden-CLIP'e ve semantik-veriden-CLIP'e eşlemeler için λCLIP = 1.000, ham-veriden-VAE'ye çapa için λVAE = 0 ve yapısal-akımdan-VAE'ye eşleme için λVAE, struct = 1.000 kullanın. Eşleme girişlerini fit-partition istatistiklerini kullanarak standartlaştırın.
NOT: Yapısal akım, ham EEG ve grafik özelliklerinin birleştirilmesidir; semantik akım ise ham özellik birleştirmesi olmaksızın semantik kodlayıcı çıktısını içerir. - Yapısal özellikleri VAE gizil uzayına eşleyin
- λVAE,struct = 1.000 ile yapısal-akımdan-VAE'ye ridge eşlemesini kurun ve 36.864 boyutlu VAE gizil değişkenini tahmin edin. Bu dal, birleştirilmiş ham EEG ve grafik temsillerini alır; ham özellikleri açıkça birleştiren tek doğrusal olmayan daldır.
- Semantik özellikleri CLIP gizil uzayına eşleyin
- λCLIP = 1.000 ile semantik-akımdan-CLIP'e ridge eşlemesini kurun ve 1.024 boyutlu CLIP temsilini tahmin edin. Semantik giriş, ham EEG ile birleştirilmez.
NOT: Bu makalede, λ ridge düzenlileştirmesini ve α bir gizil-füzyon ağırlığını temsil eder. - Gizil uzay hizalamasını örnek bazlı Pearson korelasyon katsayısı (PCC) ile değerlendirin. Füzyon ağırlığı seçimi için geliştirme koşullarını kullanın ve 200 ayrılmış test koşulunu yalnızca eşlemeler ve füzyon ağırlıkları dondurulduktan sonra değerlendirin.
- λCLIP = 1.000 ile semantik-akımdan-CLIP'e ridge eşlemesini kurun ve 1.024 boyutlu CLIP temsilini tahmin edin. Semantik giriş, ham EEG ile birleştirilmez.
5. Gizli tahminleri birleştirin ve difüzyon yeniden yapılandırmasını çalıştırın
- Sadece 16.540 eğitim koşulundan türetilen koşul düzeyinde bir geliştirme ayrımı kullanarak αVAE ve αCLIP'i seçin. Rastgele tohum (seed) 42 ile, tüm 10 denek için aynı %90 uyum indekslerini ve %10 geliştirme indekslerini kullanın; ayrılmış 200 test koşulu bu prosedürün dışında kalmalıdır.
NOT: Ridge cezaları ve yapısal koruma katsayısı, nihai ayrılmış değerlendirmeden önce konfigürasyon değerleri olarak sabitlenmiş olup 200 test koşuluna göre ayarlanmamıştır. - Her denek ve {0.00, 0.05, ..., 1.00} kümesindeki her bir aday α için, hedef-denetimli kodlayıcıyı ve ridge eşlemelerini uyum alt kümesine oturtun ve geliştirme alt kümesi üzerinde örnek bazlı ortalama gizli PCC değerini hesaplayın.
- Denek düzeyindeki PCC değerlerini 10 denek arasında eşit ağırlıkla ortalayın ve CLIP ile VAE alanı ağırlıklarını, maksimum denekler arası ortalamaya göre bağımsız olarak seçin. Nihai eğitim modellerini yeniden oturtmadan ve ayrılmış test koşullarını değerlendirmeden önce her iki değeri de dondurun.
NOT: Bu prosedür αCLIP = 0.55 ve αVAE = 0.65 değerlerini seçmiştir. - VAE alanı için, birleştirilmiş tahmini; ham-VAE çapası ile yapısal akış VAE tahmininin ağırlıklı toplamı olarak tanımlayın:
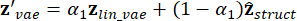 (5)
- αVAE = 0.65 olarak ayarlayın; böylece ham-VAE çapası 0.65 ve yapısal akış tahmini 0.35 oranında katkıda bulunsun. Bu değeri her denek ve test koşulu için sabit tutun.
- CLIP alanı için, birleştirilmiş tahmini; ham-CLIP çapası ile semantik akış CLIP tahmininin ağırlıklı toplamı olarak tanımlayın:
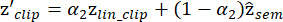 (6)
- αCLIP = 0.55 olarak ayarlayın; böylece ham-CLIP çapası 0.55 ve semantik akış tahmini 0.45 oranında katkıda bulunsun. Bu değeri her denek ve test koşulu için sabit tutun.
NOT: Birleştirme işlemini, topluluk kombinasyonunun30 genel anlamında gizli tahminlerin sabit ağırlıklı bir topluluğu olarak yorumlayın. Bunu, aşırı öğrenmede (overfitting) garanti edilen bir azalma veya tüm metrikler genelinde tekdüze olarak optimal bir çözüm olarak tanımlamayın. - sd2-community/stable-diffusion-2-1-unclip adresinden fp16 varyasyon ağırlıklarıyla dondurulmuş Stable UnCLIP görüntüden-görüntüye hattını (pipeline) yükleyin. Birleştirilmiş CLIP gömmesini (embedding) semantik koşul, birleştirilmiş VAE gizli değişkenini (latent) ise yapısal başlangıç olarak kullanın.
NOT: Dekoder, gürültüden arındırma difüzyonu ve sınıfsız yönlendirme (classifier-free guidance) ilkelerini takip eder31,32. - Difüzyon gizli değişkenlerine gürültülü yapısal başlangıç uygulayın. Her bir 36.864 boyutlu VAE tahminini, varyasyonel otokodlayıcı gizli formülasyonuna33 uygun olarak 4 x 96 x 96 şeklinde yeniden boyutlandırın ve yapısal gizli değişkeni yapısal ölçek gamma = 0.02 ile çarptıktan sonra Gauss gürültüsü ekleyin. Raporlanan yeniden yapılandırma prosedürü için difüzyon eğitim zaman adımları T_diff = 1.000 ve sabit bir difüzyon tohumu 0 kullanın.
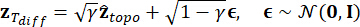 (7)
- Gürültülü başlangıçtaki yapısal koruma katsayısı gamma'yı 0.02 olarak ayarlayın ve bu değeri tüm test koşulları için sabit tutun. Elde edilen gizli değişkeni, gerçek değer (ground-truth) görüntü bilgisini kullanmadan dekodere iletin.
- Çapraz dikkat (cross-attention) yönlendirmesi uygulayın ve görüntü gizli değişkenini dekode edin. Birleştirilmiş 1.024 boyutlu CLIP vektörünü, hattın kullandığı 1.024 boyutlu koşullandırma uzantısıyla birleştirin, sınıfsız yönlendirme (CFG) için başa sıfır negatif-koşul vektörü ekleyin ve 7.5 yönlendirme ölçeğiyle dekode edin. Hattın varsayılanı olan 20 gürültüden arındırma adımı kullanın ve her test koşulu için bir PNG görüntüsü kaydedin.
- Yeniden yapılandırılmış görüntüyü orijinal test-koşul indeksiyle kaydedin ve sonraki tüm metrik hesaplamaları için aynı indeksi koruyun.
NOT: Tablo 1, raporlanan iş akışında kullanılan veri bölümlendirme, ön işleme, grafik oluşturma, model eğitimi, gizli eşleme, birleştirme ve dekoder ayarlarını özetlemektedir. Ekli çalışma sayfası, aynı parametre özetini makine tarafından okunabilir bir formatta sunmaktadır.
6. Rekonstrüksiyon ve temsil düzeyi hizalamasını değerlendirin
- Piksel korelasyonu (PixCorr) ve yapısal benzerlik (SSIM) ile düşük seviyeli sadakati hesaplayın. AlexNet Katman 2, AlexNet Katman 5, Inception-v3 ve OpenAI CLIP ViT-L/14 ikili tanımlama doğruluklarını hesaplayın; düşük değerlerin daha yakın özellik temsillerini gösterdiği EfficientNet (EffNet) ve SwAV korelasyon mesafelerini hesaplayın.
- CLIP analizi için, 200 rekonstrüktif görüntüden çıkarılan özellikler ile karşılık gelen 200 gerçek (ground-truth) görüntü arasındaki korelasyon matrisini oluşturun. Her rekonstrüksiyon için, doğru görüntü korelasyonunu diğer 199 görüntüyle olan korelasyonlarla karşılaştırın ve CLIP ikili tanımlama doğruluğunu elde etmek için sonuçlanan 200 x 199 ikili karşılaştırmanın ortalamasını alın.
- 8, 16, ..., 80 zaman noktasında sona eren genişleyen pencereler için, ham EEG ridge eşlemelerini uydurun ve 200 sub-01 test koşulu üzerinden tahmin edilen ve gerçek CLIP ve VAE latentleri arasındaki örnek bazlı ortalama PCC'yi hesaplayın. Tam pencere semantic-stream-only CLIP ve VAE tahminlerini kesikli referans seviyeleri olarak kullanın.
- Kosinüs benzerliğini kullanarak L2-normalize edilmiş CLIP özelliklerinden temsili benzerlik matrisleri (RSM'ler) oluşturun. Her iki matrisi de Öklid mesafesi kullanılarak gerçek CLIP gömme (embedding) değerlerinin Ward hiyerarşik kümelemesi ile sıralayın.
- İki boyutlu görselleştirme için, gerçek gömme değerlerinden beş k-means kümesi türetin ve gerçek ile tahmin edilen özelliklere bir ortak PCA-50 artı t-dağılımlı stokastik komşuluk gömme (t-SNE) projeksiyonu uygulayın; t-SNE'yi yalnızca kalitatif görselleştirme için kullanın.
- Beyazlatılmış EEG modellerini ve saçlı deri kanal model ağırlıklarını etiketli kanallar, açık renk ölçekleri ve yeniden üretilebilir sıralama kurallarıyla görselleştirin. Bu grafikleri, kortikal kaynak yerelleştirmesi, anatomik aktivasyon veya nedensellik kanıtı olarak değil, ölçülen saçlı deri sinyallerinin ve model parametrelerinin yardımcı analizleri olarak yorumlayın.
Sonuçlar
TDE-Net altı tamamlayıcı perspektiften değerlendirilmiştir: yeniden yapılandırma performansı, temsili görsel sonuçlar, bileşen katkısı, zamansal bağımlılık, semantik temsili yapı ve saç derisi kanalı dikkati. Düşük seviyeli sadakat PixCorr ve SSIM kullanılarak, öznitelik alanı hizalaması AlexNet, Inception-v3, CLIP, EffNet ve SwAV ölçümleriyle ve denek düzeyindeki performans ise 10 THINGS-EEG2 deneğinin tamamından elde edilen sonuçlarla değerlendirilmiştir. Aksi belirtilmedikçe, her nitel şekil ilgili deneği ve test koşulu alt kümesini tanımlamaktadır.
Rekonstrüksiyon performansı ve temsili sonuçlar
Dahili bir referans model olarak, ek olarak hafif bir konvolüsyonel-dikkat EEG kodlayıcı temel modeli uyguladık. Bu model, her denemeden tek bir 1024 boyutlu EEG temsili çıkarır ve önerilen yöntemle aynı ridge regresyonu ve difüzyon kod çözme protokolünü kullanarak bunu CLIP ve VAE latent uzaylarına bağımsız olarak eşler. İzleyen bölümlerde bu model Baseline olarak adlandırılmıştır. Kodlayıcı, yerel uygulamada kullanılan, 373.950 eğitilebilir parametreye ve 1.024 boyutlu bir çıktıya sahip LMDA tarzı konvolüsyonel-dikkat semantik referanstır.
Tablo 2, TDE-Net'i, bildirilen metrikler üzerinden dahili konvolüsyonel-dikkat baz hattı ve temsili EEG tabanlı görüntü rekonstrüksiyon yöntemleri ile karşılaştırmaktadır. Tutarlı bir değerlendirme için yöntemler, kendilerine özgü mimarileri korunarak aynı THINGS-EEG2 bölümü, 17 kanallı giriş, ön işleme, ayrılmış test koşulları ve metrik tanımlarını kullanan birleşik bir deneysel çerçeve içinde uygulanmıştır. On denekli özet genelinde TDE-Net; PixCorr için 0.2531 ± 0.0138, SSIM için 0.3388 ± 0.0025, AlexNet Layer 2 için 0.8777 ± 0.0115, AlexNet Layer 5 için 0.9153 ± 0.0116, Inception-v3 için 0.7606 ± 0.0213, CLIP ikili tanımlama doğruluğu için 0.8135 ± 0.0074, EffNet mesafesi için 0.8285 ± 0.0122 ve SwAV mesafesi için 0.5085 ± 0.0101 ortalama ± SD değerlerine ulaşmıştır. Denek düzeyindeki özet, tek denekli kalitatif örnekleri tamamlamaktadır.
CLIP değeri, kosinüs benzerliği veya genel bir CLIP özellik puanından ziyade, ikili tanımlama doğruluğunu ifade eder. Semantik akış, bir CLIP-uzayı hedefine doğru eğitildiği için, bu ölçüm hem semantik yeniden yapılandırmayı hem de tek bir dal hedefiyle olan uyumu yansıtır. Bu nedenle; düşük seviyeli sadakat ve özellik-uzayı uyumunun tamamlayıcı yönlerini karakterize eden PixCorr, SSIM, AlexNet, Inception-v3, EffNet ve SwAV ile birlikte değerlendirilir.
Denek düzeyindeki performansı karakterize etmek için, her denek için aynı 200 ayrılmış görüntü koşulunu kullanarak, sub-01'den sub-10'a kadar olan deneklere tam TDE-Net test prosedürünü uyguladık. Tablo 3, her denek için sekiz değerlendirme ölçütünün tamamını, denekler arası ortalama ve örnek SD ile birlikte sunmaktadır. Ortalama CLIP ikili tanımlama doğruluğu 0,8135 (SD, 0,0074) idi. Ortalama PixCorr ve SSIM değerleri sırasıyla 0,2531 ve 0,3388 idi. AlexNet Katman 2 ve Katman 5 doğrulukları ortalama 0,8777 ve 0,9153 olurken, Inception-v3 doğruluğu ortalama 0,7606 idi. Düşük değerlerin daha iyi olduğu EffNet ve SwAV mesafeleri sırasıyla ortalama 0,8285 ve 0,5085 idi. Bu ölçümler genelindeki sınırlı denek düzeyindeki dağılım, 10 THINGS-EEG2 deneği arasında karşılaştırılabilir nicel yeniden yapılandırma davranışı olduğunu göstermektedir.
Şekil 3, 10 deneğin tamamı için aynı yedi dışarıda tutulan durum indeksine (1, 32, 62, 86, 87, 108 ve 175; sıfır tabanlı dosya numaralandırması) ait yeniden yapılandırmaları sunmaktadır. Üst satır gerçek uyaranları, sonraki satırlar ise sub-01'den sub-10'a kadar olan deneklerin ilgili yeniden yapılandırmalarını göstermektedir. Yeniden yapılandırmalar, uyaranların ortak anlamsal kategorilerini ve karakteristik görsel özniteliklerini korurken; nesnenin detaylı kimliği, şekli ve yerel dokusu denekler arasında farklılık göstermektedir. Bu düzen, Tablo 3'te özetlenen denekler arası sonuçların kalitatif bir karşılığını sağlamaktadır.
Şekil 4, belirlenmiş alt-01 test koşulları için altı kalitatif yeniden yapılandırmayı sunmaktadır. Satırlar; temel gerçek uyaranı, yerel uygulamamız tarafından oluşturulan bir Perceptogram karşılaştırıcısını21 ve TDE-Net yeniden yapılandırmasını göstermektedir. Örnekler; nesne kategorisinin, şeklin, rengin ve arka plan özniteliklerinin korunduğunu, buna karşın ince taneli kimlik ve arka plan detaylarının yöntemler arasında farklılık gösterdiğini vurgulamaktadır.
Ek Şekil 1, THINGS-EEG223 içindeki 200 sub-01 test koşulu arasından seçilen en iyi, medyan ve en kötü yeniden yapılandırma gruplarını sunmaktadır. Koşullar, dondurulmuş birleştirilmiş EEG-öngörülü CLIP gömmesi ile karşılık gelen gerçek görüntü CLIP gömme vektörü arasındaki kosinüs uyumuna göre sıralanmıştır. Görüntülenen gruplar, bu denek için gözlemlenen semantik uyum aralığını göstermektedir.
Bileşen katkısı ve füzyon davranışı
Tablo 4, aynı değerlendirme prosedürü altında elde edilen denekler arası ortalama değerlere dayalı olarak, yapısal ve semantik akışların kademeli bir ablasyonunu sunmaktadır. Lineer Çapa, ridge regresyonu kullanarak ön işlemeden geçmiş EEG verilerinden CLIP ve VAE latentlerini doğrudan tahmin eder ve ablasyon çalışması için kontrollü başlangıç noktası görevi görür. Bu yaklaşım, Perceptogram21 dahil olmak üzere önceki EEG'den görüntüye çalışmalarında kullanılan genel lineer latent-eşleme ilkesini takip ederken; mevcut iş akışının ön işleme, düzenlileştirme, kod çözme ve değerlendirme ayarlarını kullanır. Bu tasarım; yapısal akışın, semantik akışın ve çift-uzay füzyonunun ortak bir lineer referansa göre incelenmesine olanak tanır.
Linear Anchor'dan başlayarak, yapısal akışın eklenmesi SSIM değerini 0,331'den 0,339'a ve AlexNet Tabaka 5 doğruluğunu 0,913'ten 0,932'ye yükseltmiş olsa da, AlexNet Tabaka 2 doğruluğu 0,889'dan 0,886'ya hafifçe düşmüştür. Bunun yerine anlamsal akışın eklenmesi, yüksek bir AlexNet Tabaka 2 doğruluğunu (0,888) korurken en yüksek PixCorr (0,237) değerini üretmiş, EffNet ve SwAV mesafelerini ise sırasıyla 0,865 ve 0,531'e indirmiştir. Her iki akış çift alan füzyonu aracılığıyla dahil edildiğinde, TDE-Net en yüksek Inception-v3 (0,761) ve CLIP ikili tanımlama doğruluklarına (0,814) ulaşmış; aynı zamanda en düşük EffNet (0,829) ve SwAV (0,509) mesafelerini gerçekleştirmiştir. AlexNet Tabaka 2 doğruluğu (0,878), Linear Anchor'ın altında kalmış ve SSIM değeri (0,339), yapısal akış konfigürasyonunun hafifçe altında kalmıştır. Genel olarak, denekler arası ablasyon sonuçları, yapısal ve anlamsal akışların yeniden yapılandırmanın farklı yönlerini etkilediğini, bunların füzyonunun ise öncelikle anlamsal tanımlamayı ve derin özellik uzayı tutarlılığını güçlendirdiğini göstermektedir.
Şekil 5, α = 0.00–1.00 aralığında 0.05'lik artışlarla iki füzyon ağırlığına karşı geliştirme setinin duyarlılığını göstermektedir. CLIP-alanı eğrisi maksimumuna αCLIP = 0.55 değerinde ulaşırken, VAE-alanı eğrisi maksimumuna αVAE = 0.65 değerinde ulaşmaktadır. Komşu adaylar için benzer PCC değerleri gözlemlenmişken, maksimumlar iki gizli alan için farklı ağırlıklarda ortaya çıkmıştır.
EEG sinyallerinin zamansal katkısı
Şekil 6, sub-01'de (n = 200 test koşulu) 8, 16, ..., 80 zaman noktasında sona eren ham EEG pencereleri için koşul başına ortalama gizli PCC değerlerini göstermektedir. CLIP ve VAE eğrileri, analiz penceresi genişledikçe artmakta ve daha sonraki pencerelerde plato çizmektedir. Kesikli çizgiler, ilgili tam pencere yalnızca-semantik-akış referans değerlerini belirtmektedir. Bu analiz, rapor edilen eşleme protokolü altındaki zamansal pencere bağımlılığını karakterize etmektedir.
Semantik hizalama ve temsil düzeyi analizi
Şekil 7, 200 sub-01 test koşulu genelinde ham CLIP çapa ve dondurulmuş birleştirilmiş CLIP tahmini için örnek bazlı CLIP latent PCC değerlerini karşılaştırmaktadır. Gauss çekirdek yoğunluk tahminlerinde Scott bant genişliği kullanılmıştır ve dikey kesikli çizgiler örnek ortalamalarını belirtmektedir. Birleştirilmiş dağılım, ham çapaya kıyasla PCC değerinde yaklaşık 0,013'lük bir ortalama artış göstermektedir. Görüntü düzeyindeki CLIP ikili tanımlama doğruluğu Tablo 2'de ayrı olarak raporlanmıştır.
Şekil 8, gerçek görüntü CLIP gömmeleri ile birleştirilmiş EEG-tahminli CLIP gömmeleri için kosinüs benzerliği RSM'lerini karşılaştırmaktadır. Her iki matris de ortak bir veri aralığını ve gerçek CLIP gömmeleri arasındaki Öklid mesafelerinden türetilen bir Ward sıralamasını paylaşmaktadır. Artık paneli, temsilsel uyumun bir görselleştirmesini sağlayarak, maksimum mutlak artık tarafından tanımlanan simetrik bir ölçekte tahmin edilen RSM eksi gerçek RSM'yi göstermektedir.
Ek Şekil 2, 200 gerçek değer (ground-truth) ve 200 EEG tarafından tahmin edilen CLIP gömmelerinin ortak bir projeksiyonunu sunmaktadır. Beş etiket, L2-normalize edilmiş gerçek değer gömmelerinin k-ortalama kümelemesiyle (n_init = 50; seed = 7) elde edilmiştir. Birleştirilmiş gerçek değer ve tahmin edilen öznitelikler PCA ile 50 boyuta indirgenmiş ve perplexity 28, Öklid mesafesi ve seed 12 kullanılarak t-SNE ile ortaklaşa projekte edilmiştir. Projeksiyon, iki temsil setinin organizasyonuna dair nitel bir görünüm sağlamaktadır.
EEG paterni ve uzamsal dikkat yorumlanabilirliği
Ek Şekil 3, açık bir kavram-etiket eşlemesi kullanarak test kavramlarını Hayvanlar, Gıda/bitki ile ilgili kavramlar ve Diğer nesneler şeklinde gruplandırmaktadır. Her grup içerisinde satırlar, beyazlatılmış gerçek değer CLIP gömmeleri (embeddings) üzerinde Ward kümelemesi ile sıralanmış ve okunurluğu sağlamak adına en fazla 30 kavram olacak şekilde tekdüze örneklenmiştir. Isı haritası, -1 ile 1 ölçeğinde kırpılmış, normalize edilmiş beyazlatılmış EEG genliklerini göstermektedir; CLIP gömmeleri yalnızca grup içi sıralamayı belirlemek için kullanılmıştır.
Ek Şekil 4, seçilen 17 elektrot üzerinden normalize edilmiş mutlak semantik akış kanal ağırlıklarının standart 10–20 kafa derisi topografyasını göstermektedir. Harita, ölçülen kafa derisi kanalları genelindeki göreceli model ağırlıklandırmasını özetler ve kanal düzeyinde bir model ağırlığı görselleştirmesi olarak yorumlanır.
Bu çalışma, kimliksizleştirilmiş THINGS-EEG2 veri setinin ikincil bir hesaplamalı analizidir. Kaynak EEG kayıtları, ön işleme tabi tutulmuş EEG dizileri, uyaran meta verileri ve görüntüleri ile dinlenme durumu dosyalarına https://osf.io/3jk45/ adresindeki THINGS-EEG2 projesi ve Figshare+ (https://doi.org/10.25452/figshare.plus.18470912) üzerinden erişilebilir. Orijinal veri toplama ve ön işleme yazılımı https://github.com/gifale95/eeg_encoding adresinde mevcuttur. EEG verilerinin ve uyaran görüntülerinin erişimi ve yeniden kullanımı, kaynak depolar tarafından belirtilen lisanslar ve atıf gerekliliklerine tabidir.
Hizalama, füzyon, yeniden yapılandırma, değerlendirme ve görselleştirme betiklerini içeren TDE-Net uygulaması, https://github.com/Yuan-ui198/TDE-Net adresinde mevcuttur. Bu makaleye karşılık gelen versiyon, c99325d7f9e090ddd7cd5816aeabda7a9b9364da commit'i (https://github.com/Yuan-ui198/TDE-Net/tree/c99325d7f9e090ddd7cd5816aeabda7a9b9364da) ile sabitlenmiştir. Mevcut çalışma için tanımlanabilir yeni katılımcı verisi toplanmamıştır.
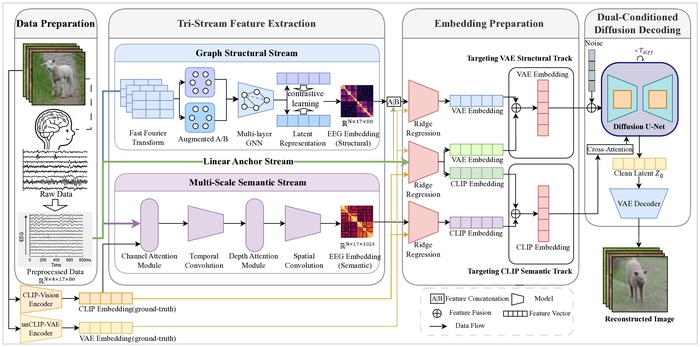
Şekil 1: TDE-Net'in şeması. Diyagram; ham EEG çapayı, örneğe özgü fonksiyonel grafik akışını, semantik temporal akışı, VAE ve CLIP'e çift alan eşlemesini, ağırlıklı füzyonu ve çift koşullu Stable UnCLIP kod çözümlemesini göstermektedir. Uygulanabilir olan yerlerde tensör boyutları belirtilmiştir. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayınız.
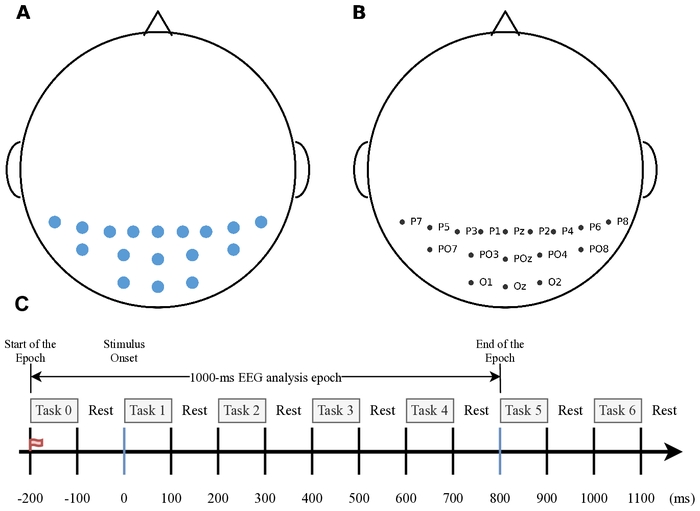
Şekil 2: EEG elektrot seçimi ve deneysel zamanlama. (A) Orijinal 64 kanallı kayıt içerisinden seçilen 17 parieto-oksipital elektrodun uzaysal dağılımı. (B) Elektrot etiketleri: Pz, P3, P7, O1, Oz, O2, P4, P8, P1, P5, PO7, PO3, POz, PO4, PO8, P6 ve P2. (C) RSVP zamanlaması ve EEG epok tanımının şeması. Şemada, “Task” bir görüntü sunum aralığını, “Rest” ise görüntüler arası aralığı belirtir; numaralandırılmış Task blokları farklı deneysel koşulları değil, birbirini takip eden sunum aralıklarını göstermektedir. Her görüntü 100 ms süreyle ve 200-ms uyaran başlangıç asenkronisi ile sunulmuştur. EEG epoku, uyaran başlangıcına göre -200 ile 800 ms aralığına yayılmış olup, bu durum 1000-ms'lik bir EEG analiz epokuna karşılık gelmektedir. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
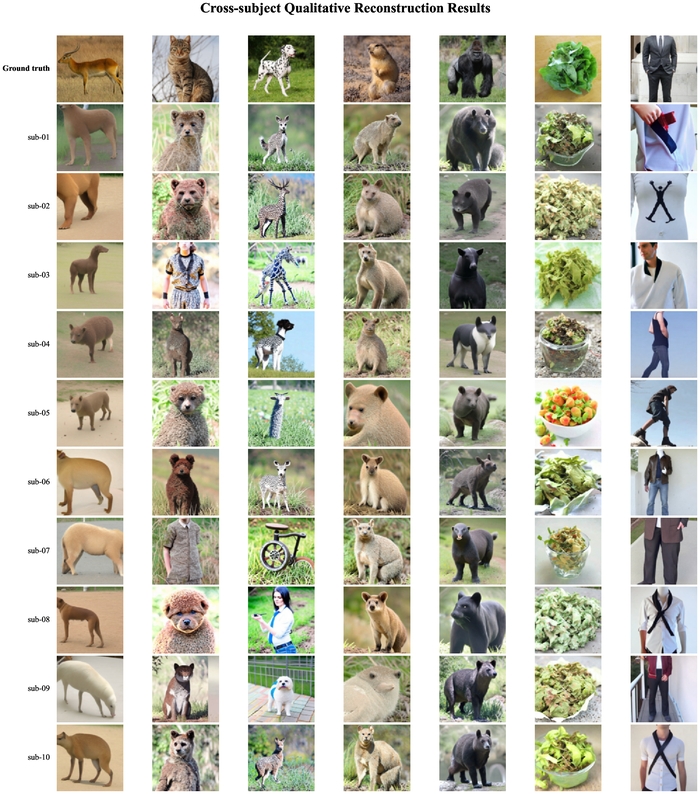
Şekil 3: Yedi adet ayrılmış görüntü koşulu için denekler arası kalitatif yeniden yapılandırma sonuçları. sub-01'den sub-10'a kadar olan denekler için aynı sıfır tabanlı koşul indeksleri (1, 32, 62, 86, 87, 108 ve 175) kullanılmıştır. Üst satır, görüntüleri THINGS görüntü veritabanından34 alınan THINGS-EEG2 test setindeki karşılık gelen temel gerçek (ground-truth) görüntü örneklerini göstermekte, geri kalan satırlar ise her bir denek için TDE-Net yeniden yapılandırmalarını göstermektedir. Şekil, ortak semantik içeriği ve denek düzeyindeki varyasyonu örneklemektedir; nicel denekler arası sonuçlar Tablo 3'te raporlanmıştır. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
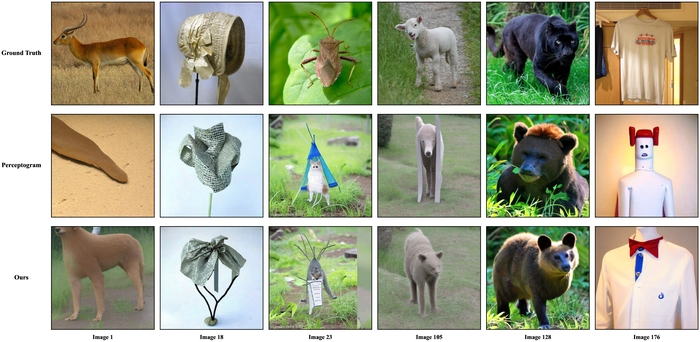
Şekil 4: Belirlenen alt-01 test koşullarının altısı için kalitatif yeniden yapılandırma karşılaştırması. Satırlar gerçek uyaranı, yerel uygulama tarafından oluşturulan bir karşılaştırıcı yeniden yapılandırmayı ve TDE-Net yeniden yapılandırmasını göstermektedir; sütunlar ise bireysel koşul indekslerine karşılık gelmektedir. Gerçek görüntü örnekleri THINGS görüntü veri tabanından alınmıştır34. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
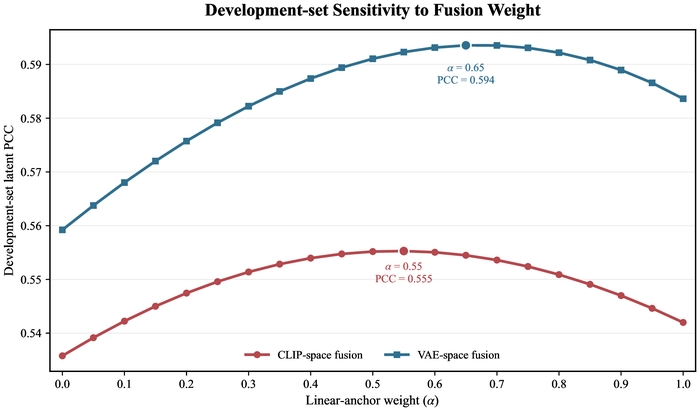
Şekil 5: Gizli-füzyon ağırlıklarının geliştirme seti duyarlılığı. Yatay eksen doğrusal-çapa ağırlığı α'yı, tamamlayıcı akış ağırlığı 1 - α'yı ve dikey eksen geliştirme seti gizli PCC değerini belirtir. Aday değerler 0,05'lik artışlarla 0,00 ile 1,00 arasında değişmektedir. CLIP ve VAE uzayı ağırlıkları, 10 denek genelindeki maksimum eşit ağırlıklı ortalama denek düzeyi PCC değerine göre bağımsız olarak seçilerek αCLIP = 0,55 ve αVAE = 0,65 elde edilmiştir. PCC, Pearson korelasyon katsayısı. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
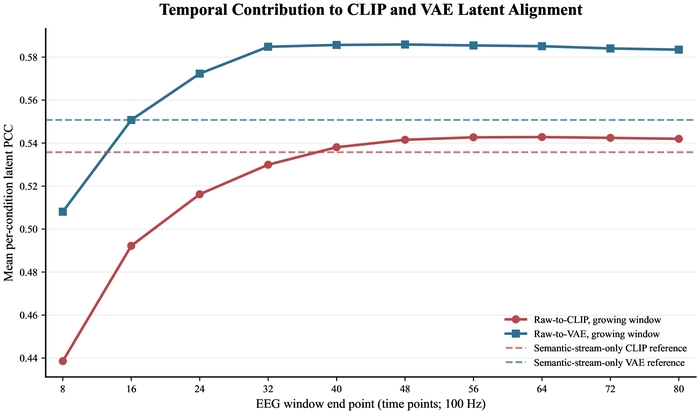
Şekil 6: sub-01'de gizli hizalamanın zamansal pencere analizi (n = 200 ayrılmış koşul). Düz eğriler, EEG penceresi bitiş noktası 100 Hz'de 8'den 80 zaman noktasına genişlerken, ham-CLIP ve ham-VAE ridge tahminleri için örnek bazlı ortalama PCC değerlerini göstermektedir. Kesikli çizgiler, tam pencere semantik akım tabanlı CLIP ve VAE referans değerlerini belirtmektedir. PCC, Pearson korelasyon katsayısı. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
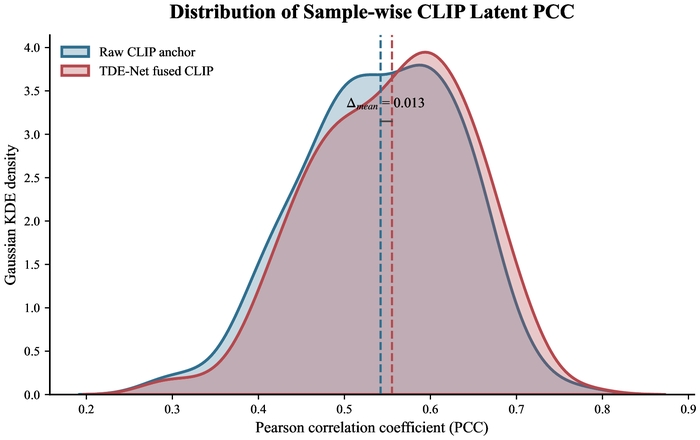
Şekil 7: sub-01'de örnek bazlı CLIP latent hizalamasının dağılımı (n = 200 ayrılmış koşul). Eğriler, ham CLIP çapa noktası ve dondurulmuş TDE-Net-füzyonlu CLIP tahmini için Scott bant genişliği kullanılarak hesaplanmış Gauss çekirdek yoğunluk tahminleridir. Dikey kesikli çizgiler örnek ortalamalarını belirtmekte olup, açıklama bunların farkını göstermektedir. PCC, Pearson korelasyon katsayısı; KDE, çekirdek yoğunluk tahmini. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
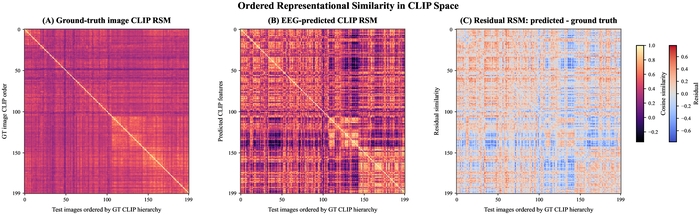
Şekil 8: sub-01 için CLIP uzayındaki sıralanmış temsili benzerlik (n = 200 ayrılmış koşul). (A) L2-normalize edilmiş gerçek görüntü CLIP gömmelerinin kosinüs benzerliği RSM'si. (B) Birleştirilmiş EEG-tahminli CLIP gömmelerinin kosinüs benzerliği RSM'si, panel A ile aynı sıralama ve renk ölçeği kullanılarak gösterilmiştir. (C) Tahmin edilen değerden gerçek değerin çıkarılmasıyla hesaplanan artık RSM, maksimum mutlak artık tarafından tanımlanan simetrik bir ölçekte gösterilmiştir. Sıralama, gerçek CLIP gömmelerinin Öklid mesafesi ve Ward bağlama yöntemiyle elde edilmiştir. RSM, temsili benzerlik matrisi. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
| Bileşen | Parametre | Kurulum |
| Veriler ve ön işleme | Veri seti bölümlendirme | 16.540 eğitim ve 200 ayrılmış test koşulu; %90/%10 uyumlama/geliştirme ayrımı (seed 42) |
| EEG girişi | 17 pariyeto-oksipital kanal; 0-800 ms; 100 Hz; 80 zaman noktası | |
| Spektral temsil | 80 noktalı FFT; 40 pozitif frekans kutusu; 0-50 Hz logaritmik genlik spektrumu | |
| Yapısal akış | Graf oluşturma | Örneğe özgü mutlak Pearson korelasyonu; düğüm başına ağırlıklı ilk k = 4 komşu; simetrizasyon ve öz-döngüler |
| GCN mimarisi | 5 katman; 80 gizli birim; ReLU; dropout 0,3; simetrik derece normalizasyonu; ortalama havuzlama | |
| Kontrastif amaç fonksiyonu | 80 boyutlu projeksiyon başlığı; InfoNCE sıcaklığı τ = 0.5 | |
| Eğitim | Adam; öğrenme oranı 5 × 10⁻⁴; grup boyutu 32; 20 epok; kosinüs tavlama; minimum öğrenme oranı 10⁻⁶; tohum 42 | |
| Semantik akış | Mimari | Zamansal çekirdekler 5/15/31; derinlik 9; 24 özellik kanalı; dropout 0,5; çıktı boyutu 1.024 |
| Eğitim | AdamW; öğrenme oranı 5 × 10⁻⁴; ağırlık azalması 0,01; grup boyutu 64; 50 epok; kosinüs tavlaması; minimum öğrenme oranı 10⁻⁶; tohum 42 | |
| Gizli haritalama | Ridge regresyonu | Kesişim noktası uyduruldu; maksimum iterasyon sayısı 50.000; girdiler uydurma-bölümleme istatistikleri kullanılarak standardize edildi |
| Düzenlileştirme | CLIP cezası λ = 1.000; ham VAE cezası λ = 0; yapısal VAE cezası λ = 1,000 | |
| Hedef boyutları | CLIP: 1.024; VAE: 36.864 | |
| Füzyon ve kod çözme | Füzyon ağırlıkları | CLIP çapa ağırlığı α = 0,55; VAE çapa ağırlığı α = 0,65; geliştirme verileri üzerinden seçilmiş ve test aşaması öncesinde sabitlenmiştir |
| Difüzyon modeli | sd2-community/stable-diffusion-2-1-unclip; yapısal ölçek γ = 0,02; difüzyon zaman adımları T = 1.000 | |
| Örnekleme | 20 gürültü giderme adımı; kılavuz ölçeği 7,5; difüzyon tohumu 0 |
Tablo 1: TDE-Net için konsolide parametre özeti. Tablo; bildirilen deneyler boyunca kullanılan veri bölümlemesi, ön işleme, fonksiyonel komşuluk inşası, grafik ve semantik kodlayıcı ayarları, latent-eşleme cezaları, füzyon ağırlıkları ve difüzyon-kod çözme ayarlarını listelemektedir.
| Yöntem | PixCorr | SSIM | AlexNet(2) | AlexNet(5) | Inception | CLIP | EffNet | SwAV |
| Temel Hat (Baseline) | 0.141 | 0.321 | 0.823 | 0.878 | 0.704 | 0.739 | 0.898 | 0.564 |
| EEGImageDecode | - | 0.345 | 0.776 | 0.866 | 0.734 | 0.786 | - | 0.582 |
| Perceptogram (unCLIP) | 0.223 | 0.370 | 0.875 | 0.915 | 0.749 | 0.806 | 0.870 | 0.530 |
| TDE-Net (Bizimki) | 0.253 ± 0.014 | 0.339 ± 0.003 | 0.878 ± 0.012 | 0.915 ± 0.012 | 0.761 ± 0.021 | 0.814 ± 0.007 | 0.829 ± 0.012 | 0.509 ± 0.010 |
Tablo 2: Kantitatif yeniden yapılandırma sonuçları. Karşılaştırma yöntemleri olan dahili konvolüsyonel-dikkat Baseline ve TDE-Net; yöntem spesifik mimarileri korunarak, aynı THINGS-EEG2 bölümü, 17 kanallı giriş, ön işleme, dışarıda tutulan test koşulları ve metrik tanımlarının kullanıldığı ortak bir deneysel çerçeve içinde değerlendirilmiştir. Mevcut model, 10 deneğe göre ortalama ± SD olarak özetlenmiştir. PixCorr, SSIM, AlexNet Katman 2, AlexNet Katman 5, Inception-v3 ve CLIP, yüksek değerin daha iyi olduğu ölçümlerdir; EffNet ve SwAV ise düşük değerin daha iyi olduğu korelasyon mesafeleridir. CLIP sütunu, OpenAI CLIP ViT-L/14 modeli kullanılarak elde edilen ikili tanımlama doğruluğunu raporlamaktadır.
| Denek | PixCorr | SSIM | AlexNet L2 | AlexNet L5 | Inception | CLIP | EffNet | SwAV |
| sub-01 | 0.2260 | 0.3361 | 0.8831 | 0.9203 | 0.7533 | 0.8120 | 0.8567 | 0.5285 |
| sub-02 | 0.2488 | 0.3378 | 0.8699 | 0.9053 | 0.7268 | 0.8074 | 0.8335 | 0.5167 |
| sub-03 | 0.2564 | 0.3397 | 0.8728 | 0.9070 | 0.7658 | 0.8143 | 0.8268 | 0.5096 |
| sub-04 | 0.2420 | 0.3356 | 0.8598 | 0.9034 | 0.7854 | 0.8112 | 0.8255 | 0.5091 |
| sub-05 | 0.2499 | 0.3385 | 0.8760 | 0.8963 | 0.7251 | 0.8016 | 0.8394 | 0.5189 |
| sub-06 | 0.2621 | 0.3395 | 0.8910 | 0.9331 | 0.7818 | 0.8215 | 0.8202 | 0.5009 |
| sub-07 | 0.2489 | 0.3378 | 0.8643 | 0.9185 | 0.7704 | 0.8200 | 0.8222 | 0.5017 |
| sub-08 | 0.2786 | 0.3425 | 0.8951 | 0.9216 | 0.7524 | 0.8245 | 0.8214 | 0.5010 |
| sub-09 | 0.2609 | 0.3370 | 0.8775 | 0.9238 | 0.7662 | 0.8055 | 0.8250 | 0.5009 |
| sub-10 | 0.2571 | 0.3433 | 0.8871 | 0.9240 | 0.7792 | 0.8175 | 0.8140 | 0.4977 |
| Ortalama | 0.2531 | 0.3388 | 0.8777 | 0.9153 | 0.7606 | 0.8135 | 0.8285 | 0.5085 |
| Ortalama ± SD | 0.2531 ± 0.0138 | 0.3388 ± 0.0025 | 0.8777 ± 0.0115 | 0.9153 ± 0.0116 | 0.7606 ± 0.0213 | 0.8135 ± 0.0074 | 0.8285 ± 0.0122 | 0.5085 ± 0.0101 |
| %95 GA | 0.2432-0.2630 | 0.3370-0.3406 | 0.8695-0.8859 | 0.9070-0.9236 | 0.7454-0.7759 | 0.8082-0.8189 | 0.8198-0.8372 | 0.5013-0.5157 |
Tablo 3: TDE-Net için denekler arası nicel sonuçlar. Her denek 200 ayrılmış test koşuluna katkıda bulunur. Tabloda sub-01'den sub-10'a kadar olan denekler için sekiz metrik ve ardından denekler arası ortalama, örnek standart sapma (SD) ve %95 GA raporlanmıştır. CLIP, OpenAI CLIP ViT-L/14 ikili tanımlama doğruluğunu; EffNet ve SwAV ise düşük değerin daha iyi olduğu korelasyon mesafelerini ifade eder.
| Yöntem | PixCorr | SSIM (Yapısal Benzerlik İndeksi) | AlexNet(2) | AlexNet(5) | Başlangıç | CLIP | EffNet | SwAV |
| Lineer Ankraj | 0.2157 | 0.3309 | 0.8891 | 0.9128 | 0.7493 | 0.7967 | 0.8683 | 0.5394 |
| Lineer + Yapı-Akışı | 0.2318 | 0.3393 | 0.8861 | 0.9319 | 0.7439 | 0.7996 | 0.8657 | 0.5359 |
| Lineer + Yarı-Akış | 0.2372 | 0.3382 | 0.8879 | 0.9228 | 0.7447 | 0.8026 | 0.8655 | 0.5307 |
| TDE-Net (Bizim Yaklaşımımız) | 0.2531 | 0.3388 | 0.8777 | 0.9153 | 0.7607 | 0.8135 | 0.8285 | 0.5085 |
Tablo 4: Protokol Bölüm 6'da açıklanan değerlendirme prosedürü kapsamında denekler arası ortalama değerler olarak raporlanan ablasyon sonuçları. Lineer Çapa (Linear Anchor), yerel olarak değerlendirilen bir dahili doğrudan ridge-eşleme referansıdır; yapısal, anlamsal ve tam konfigürasyonlar aynı koşul indekslerini ve metrik tanımlamalarını kullanır. PixCorr, SSIM, AlexNet Katman 2, AlexNet Katman 5, Inception-v3 ve CLIP, yüksek değerin daha iyi olduğu ölçümlerdir; EffNet ve SwAV ise düşük değerin daha iyi olduğu korelasyon mesafeleridir. Değerler virgülden sonra üç basamak olarak gösterilmiştir.
Ek Şekil 1: sub-01 için CLIP-uyum aralığını kapsayan temsili yeniden yapılandırma vakaları. Ayrılan 200 koşul, birleştirilmiş EEG-tahminli ve gerçek CLIP gömmeleri arasındaki kosinüs benzerliğine göre sıralanmıştır; en iyi altı, orta seviye altı ve en kötü altı vaka gösterilmiştir. Her sütun, THINGS-EEG2 test setinden bir gerçek görüntü örneğini TDE-Net yeniden yapılandırmasıyla eşleştirir. Gerçek görüntüler THINGS görüntü veritabanından alınmıştır34. Lütfen bu dosyayı indirmek için buraya tıklayın.
Ek Şekil 2: Sub-01'deki gerçek değer ve EEG ile tahmin edilen CLIP temsillerinin ortak görselleştirmesi (temsil başına n = 200 koşul). (A) Gerçek değer CLIP temsilleri. (B) EEG ile tahmin edilen CLIP temsilleri. Renkler, L2-normalize edilmiş gerçek değer CLIP gömmelerine uydurulan beş k-means kümesini belirtir (k = 5, n_init = 50, seed = 7). Kümeler veri odaklı gruplardır ve önceden tanımlanmış anlamsal kategorilere karşılık gelmezler. Gerçek değer ve tahmin edilen gömmeler birleştirilmiş, PCA ile 50 boyuta indirgenmiş ve t-SNE (perplexity = 28, learning rate = auto, Öklid metriği, seed = 12) ile ortaklaşa yansıtılmıştır. PCA, temel bileşen analizi; t-SNE, t-dağılımlı stokastik komşu gömme. Lütfen bu dosyayı indirmek için buraya tıklayın.
Ek Şekil 3: sub-01 için geniş görüntü-konsept kategorilerine göre gruplandırılmış EEG paternleri. Konseptler Hayvanlar, Gıda/bitki ile ilgili konseptler veya Diğer nesneler şeklinde atanmıştır. Her kategori içinde satırlar, beyazlatılmış ground-truth CLIP gömmelerinin Ward hiyerarşik sıralamasını takip eder ve okunabilirlik için en fazla 30 konsept olacak şekilde tekdüze olarak örneklenmiştir. Sütunlar, kanal başına 80 zaman noktasıyla 17 EEG kanalını göstermektedir. Renk ölçeği (-1 ile 1 arası), kırpılmış, normalize edilmiş beyazlatılmış EEG genliğini temsil eder. Lütfen bu dosyayı indirmek için buraya tıklayın.
Ek Şekil 4: Semantik-akış saç derisi kanal dikkat topografyası. Renkler, standart 10–20 saç derisi projeksiyonundaki seçili 17 elektrot boyunca öğrenilmiş kanal ağırlık parametrelerinin normalize edilmiş bağıl büyüklüklerini göstermektedir; elektrot noktaları ve etiketleri ölçüm konumlarını belirlemektedir. Ölçek 0 ile 1 arasında değişmekte ve modelin öğrenilmiş bağıl kanal ağırlıklandırmasını özetlemektedir. Bu dosyayı indirmek için lütfen buraya tıklayın.
Tartışma
Bu çalışma; EEG ön işleme, yapısal ve semantik temsil öğrenimi, CLIP/VAE gizli eşleme, füzyon ve difüzyon kod çözme aşamalarını birbirinden ayıran modüler bir hesaplama iş akışı sunmaktadır. Bu aşamalı organizasyon, ara çıktıların üretilen görüntülerden bağımsız olarak incelenmesine olanak tanır ve kompakt EEG kodlayıcılardan çapraz modlu ve difüzyon tabanlı yeniden yapılandırma yöntemlerine doğru giden genel ilerlemeyi takip eder6,11,12,13,14,15,16,,17,18,19,20,21,22. Denekler arası analiz, on denekli ayrılmış değerlendirme seti için denek düzeyindeki değerleri, denekler arası ortalama ve örnek SD ile birlikte raporlamaktadır. Tablo 4'teki adım adım ablasyon çalışmasıyla birlikte bu analiz, bildirilen işlem hattı içindeki akışa özgü etkileri ve denekler arası varyasyonu nicelleştirmektedir.
Kritik adımlar ve sorun giderme
En önemli uygulama kontrolleri; bölme izolasyonu, tutarlı normalizasyon, koşul-indeks koruması ve ayrı CLIP/VAE eşlemeleridir. Füzyon ağırlıkları, geliştirme koşulları üzerinde seçilmeli ve test rekonstrüksiyonundan önce dondurulmalıdır. Performans beklenmedik şekilde düşük olduğunda, önce dizi sırası ve boyutları doğrulanmalı, ardından ham ve dala özgü latent PCC, füzyon meta verileri ve görüntü düzeyindeki metrik çıktıları incelenmelidir. Latent hizalama hatası, yukarı akışlı bir eşleme sorununa işaret ederken, kararlı latentlere rağmen değişkenlik gösteren görüntüler stokastik veya dekodere bağlı davranışları yansıtabilir14,21,22,29.
Elektrot montajının, örnekleme hızının veya zamansal pencerenin değiştirilmesi; grafik oluşturma, spektral özellikler ve zamansal çekirdeklerde buna uygun değişiklikler gerektirir. Tek bir skor piksel sadakatini, yapıyı ve nesne düzeyindeki uyumu tam olarak karşılamadığı için, yeniden oluşturma kalitesi tamamlayıcı düşük seviyeli ve semantik ölçümlerle değerlendirilmelidir6,11,21,22,23. Burada kullanılan CLIP ölçütü ikili tanımlama doğruluğudur, buna karşın Şekil 7 ve Şekil 8 gizil düzeyli PCC kullanmaktadır; bu nicelikler birbirinin yerine kullanılamaz.
TDE-Net'in modüler organizasyonu, tamamlayıcı EEG temsillerinin görsel yeniden yapılandırmanın yapısal ve anlamsal yönlerine farklı şekilde katkıda bulunup bulunmadığını incelemek için bir çerçeve sunar. Bu yaklaşım, yalnızca nihai yeniden yapılandırılmış görüntülere dayanmadan; EEG özellik temsillerinin, gizli hedeflerin ve üretken dekoderlerin sistematik olarak karşılaştırılmasını kolaylaştırabilir. Alternatif yaklaşımlar arasında doğrudan doğrusal EEG-gizli eşlemesi, tek akışlı konvolüsyonel veya dikkat tabanlı kodlayıcılar, graf tabanlı temsiller ve uçtan uca nöral kod çözme çerçeveleri yer almaktadır6,7,8,9,10,11,17,18,19,20,21,22. Mevcut iş akışı, özellikle görsel algı kod çözme, nöral temsil analizi ve ara EEG-gizli tahminlerin ayrıştırılmasının hangi bileşenlerin yeniden yapılandırma performansına katkıda bulunduğunu karakterize etmeye yardımcı olduğu non-invaziv beyin-bilgisayar arayüzleri araştırmaları için yararlı olabilir.
Kısıtlamalar
Temel sınırlamalar; sabit THINGS-EEG2 RSVP edinimi, seçilen 17 paryeto-oksipital kanal, denek özel eşlemeler, tek bir difüzyon kod çözücü ve kalitatif yorumlanabilirlik analizleridir21,22,23. 10 denekli özet, veri seti içi denek değişkenliğini ele almaktadır, ancak veri setleri arası veya paradigmalar arası transferi kanıtlamamaktadır. Üretilen görüntüler, EEG girdisi tarafından desteklenmeyen makul detaylar içerebilir ve RSM, t-SNE, EEG-örüntüsü ve dikkat görünümleri nedensel nöral mekanizmaları kanıtlamaz. Kademeli ablasyon; paylaşılan ham EEG çıpası, gizil hedefler, difüzyon kod çözücü ve değerlendirme protokolü altında yapısal akışın, semantik akışın ve çift uzay füzyonunun katkılarını karakterize eder.
Gelecekteki yönelimler
Bu kısıtlamalar dahilinde sonuçlar, difüzyon kod çözme işlemi öncesinde tamamlayıcı EEG temsillerinin ayrı semantik ve görüntü-latent uzaylarında değerlendirilmesini desteklemektedir. Gelecekteki çalışmalar; bağımsız veri setlerini, denek adaptasyonunu, belirsizlik tahminlerini, alternatif kanal dizilimlerini ve desteklenmeyen görsel detaylar üzerinde daha güçlü kontrollere sahip kod çözücüleri test etmelidir14,15,16,17,18,19,20,21,22,23. Mevcut bulguların daha geniş nörobilim veya beyin-bilgisayar arayüzü ortamlarına genişletilmesinden önce bu tür çalışmalara ihtiyaç duyulmaktadır.
Sonuç:
TDE-Net, ham bir EEG ankrajını yapısal ve anlamsal EEG temsilleriyle birleştirir, bunları VAE ve CLIP latent uzaylarıyla ayrı ayrı hizalar ve sonuçtaki öngörüleri difüzyon kodlamasından önce entegre eder. 10 THINGS-EEG2 katılımcısında, yeniden oluşturulan görüntüler, görüntülenen uyaranlarla ölçülebilir piksel düzeyinde, yapısal ve anlamsal uyum göstermiştir; kademeli ablasyon ise yapısal akışın, anlamsal akışın ve çift uzay füzyonunun etkilerini birbirinden ayırmıştır. Ara EEG özelliklerini, latent öngörüleri, füzyon çıktılarını ve nihai yeniden oluşturmaları ortaya koyan bu protokol, EEG tabanlı görsel yeniden oluşturmayı araştırmak ve bunun bağımsız veri setlerine ve edinim ortamlarına gelecekteki genişlemesini değerlendirmek için tekrarlanabilir bir çerçeve sunmaktadır.
Açıklamalar
Yazarlar, bu çalışmayı etkileyebilecek herhangi bir rakip finansal çıkar veya kişisel ilişki beyan etmemektedir. Yazarlar, taslak metinde, kodda, veri analizinde veya şekil hazırlama sürecinde herhangi bir üretken yapay zeka aracı kullanılmadığını beyan ederler.
Teşekkürler
Bu araştırma, Çin Ulusal Doğal Bilimler Vakfı (Hibe No. 62433002 ve Hibe No. 62476014), Ulusal Bilim ve Teknoloji Ana Projesi (No. 2021ZD0113703), Pekin Belediye Sosyal Bilimler Vakfı Yıllık Planlama Projesi (No. 23GLB014), Pekin Belediye Kurumlarının Üst Düzey Yenilikçi Ekiplerinin Kurulumu ve Desteklenmesi Projesi (Hibe No. BPHR20220104) ve Pekin Bilim İnsanları Programı (Hibe No. 099) tarafından finanse edilmiştir.
Malzemeler
| Ad | Şirket | Katalog numarası | Yorumlar |
|---|---|---|---|
| Accelerate | Hugging Face | 0.30.1 | Difüzyon hattı cihaz yönetimi; https://github.com/huggingface/accelerate |
| CLIP ViT-L/14 | OpenAI | ViT-L/14; openai-clip 1.0.1 | Semantik hedefler ve CLIP ikili tanımlama için kullanılan görüntü-özellik kodlayıcı; https://github.com/openai/CLIP |
| Diffusers | Hugging Face | 0.32.2 | Stable UnCLIP hattı uygulaması; https://github.com/huggingface/diffusers |
| Matplotlib | Matplotlib Development Team | 3.10.6 | Bilimsel şekil oluşturma; https://matplotlib.org/ |
| MNE-Python | MNE Developers | 1.11.0 | Standart 10-20 montaj ve kafa derisi-kanal topografyası; https://mne.tools/ |
| NumPy | NumPy Developers | 2.3.4 | EEG dizileri, gizli gömmeler, füzyon ve metrik toplama; https://numpy.org/ |
| NVIDIA GeForce RTX 4070 Laptop GPU | NVIDIA | 8 GB; driver 595.97 | Yerel kodlayıcı eğitimi ve difüzyon yeniden yapılandırması için kullanılan GPU. |
| Pillow | Python Imaging Library Fork | 11.1.0 | Görüntü yükleme, yeniden boyutlandırma ve dışa aktarma; https://python-pillow.org/ |
| Python | Python Software Foundation | 3.12.12 | Birincil çalışma zamanı ortamı; https://www.python.org/ |
| PyTorch | PyTorch Foundation | 2.9.1+cu128 | EEG kodlayıcı eğitimi ve sinir ağı çıkarımı; https://pytorch.org/ |
| scikit-image | scikit-image Developers | 0.25.2 | SSIM ve görüntü-işleme yardımcı programları; https://scikit-image.org/ |
| scikit-learn | scikit-learn Developers | 1.7.2 | Ridge regresyonu, k-means, PCA ve t-SNE; https://scikit-learn.org/ |
| SciPy | SciPy Developers | 1.16.3 | Korelasyon, istatistiksel mesafe ve hiyerarşik kümeleme; https://scipy.org/ |
| Seaborn | Seaborn Developers | 0.13.2 | Gauss çekirdek yoğunluğu görselleştirmesi; https://seaborn.pydata.org/ |
| Semantic-stream EEG encoder | TDE-Net yazarları; LMDA-Net'ten uyarlanmıştır | Repository commit c99325d | Çok ölçekli zamansal semantik temsil; uygulama ve kontrol noktası meta verileri kod deposunda sağlanmıştır. |
| Stable Diffusion 2.1 UnCLIP | Stability AI / SD2 Community | sd2-community/stable-diffusion-2-1-unclip | Dondurulmuş difüzyon kod çözücü; https://huggingface.co/sd2-community/stable-diffusion-2-1-unclip |
| Structural-stream EEG encoder | TDE-Net yazarları | Repository commit c99325d | Kendi kendine gözetimli grafik temsili; ham EEG ve grafik özellikleri yalnızca VAE-uzayı yapısal eşleşmesi için birleştirilmiştir. |
| TDE-Net hizalama, füzyon, değerlendirme ve görselleştirme betikleri | Yuan-ui198 | commit c99325d7f9e090ddd7cd581 6aeabda7a9b9364da | https://github.com/Yuan-ui198/TDE-Net/tree/c99325d7f9e0 90ddd7cd5816aeabda7a9b9364da |
| THINGS veri tabanı | Hebart et al. | doi:10.1371/journal.pone.0223792 | Doğal nesne uyaran kaynağı; https://things-initiative.org/ |
| THINGS-EEG2 veri seti | Gifford et al. | doi:10.1016/j.neuroimage.2022.119754 | 10 denekten alınan 64 kanallı EEG; bu çalışma 17 parieto-oksipital kanalı seçer; https://osf.io/anp5v/ |
| timm | Ross Wightman ve katkıda bulunanlar | 1.0.22 | Özellik değerlendirmesi tarafından kullanılan önceden eğitilmiş görme modeli yardımcı programları; https://github.com/huggingface/pytorch-image-models |
| torchvision | PyTorch Foundation | 0.24.1+cu128 | AlexNet, Inception-v3 ve EfficientNet değerlendirme omurgaları; https://pytorch.org/vision/ |
| tqdm | tqdm Developers | 4.67.1 | Özellik çıkarımı, yeniden yapılandırma ve değerlendirme için ilerleme raporlaması; https://tqdm.github.io/ |
| Transformers | Hugging Face | 4.37.2 | Önceden eğitilmiş model bileşenleri için arayüzler; https://github.com/huggingface/transformers |
Kaynaklar
- Shen G, Horikawa T, Majima K, Kamitani Y. Deep image reconstruction from human brain activity. PLoS Comput Biol. 2019;15(1):e1006633. doi:10.1371/journal.pcbi.1006633.
- Chen Z, Qing J, Xiang T, Yue W, Zhou JH. Seeing beyond the brain: conditional diffusion model with sparse masked modeling for vision decoding. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2023. p. 22710-22720. Available from: https://openaccess.thecvf.com/content/CVPR2023/html/Chen_Seeing_Beyond_the_Brain_Conditional_Diffusion_Model_With
_Sparse_Masked_Modeling_CVPR_2023_paper.html - Takagi Y, Nishimoto S. High-resolution image reconstruction with latent diffusion models from human brain activity. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2023. p. 14453-14463. Available from: https://openaccess.thecvf.com/content/CVPR2023/html/Takagi_High-Resolution_Image_Reconstruction_With_Latent_Diffusion_Models_
From_Human_Brain_CVPR_2023_paper.html - Scotti PS et al. Reconstructing the mind's eye: fMRI-to-image with contrastive learning and diffusion priors. Adv Neural Inf Process Syst. 2023;36:24705-24728. doi:10.52202/075280-1073.
- Geman S, Bienenstock E, Doursat R. Neural networks and the bias/variance dilemma. Neural Comput. 1992;4(1):1-58. doi:10.1162/neco.1992.4.1.1.
- Lawhern VJ et al. EEGNet: a compact convolutional neural network for EEG-based brain-computer interfaces. J Neural Eng. 2018;15(5):056013. doi:10.1088/1741-2552/aace8c.
- Kostas D, Aroca-Ouellette S, Rudzicz F. BENDR: using transformers and a contrastive self-supervised learning task to learn from massive amounts of EEG data. Front Hum Neurosci. 2021;15:653659. doi:10.3389/fnhum.2021.653659.
- Song Y, Zheng Q, Liu B, Gao X. EEG Conformer: convolutional transformer for EEG decoding and visualization. IEEE Trans Neural Syst Rehabil Eng. 2023;31:710-719. doi:10.1109/TNSRE.2022.3230250.
- Cui CM et al. "Pre-Train, Prompt" framework to boost graph neural networks performance in EEG analysis. IEEE J Biomed Health Inform. 2025;29(7):4847-4860. doi:10.1109/JBHI.2025.3541058.
- Meng X, Qiu S, Wan S, Cheng K, Cui L. A motor imagery EEG signal classification algorithm based on recurrence plot convolution neural network. Pattern Recognit Lett. 2021;146:134-141. doi:10.1016/j.patrec.2021.03.023.
- Miao Z, Zhao M, Zhang X, Ming D. LMDA-Net: a lightweight multi-dimensional attention network for general EEG-based brain-computer interfaces. Neuroimage. 2023;276:120209. doi:10.1016/j.neuroimage.2023.120209.
- Zhang S, Tang C, Guan C. Visual-to-EEG cross-modal knowledge distillation for continuous emotion recognition. Pattern Recognit. 2022;130:108833. doi:10.1016/j.patcog.2022.108833.
- Palazzo S et al. Decoding brain representations by multimodal learning of neural activity and visual features. IEEE Trans Pattern Anal Mach Intell. 2021;43(11):3833-3849. doi:10.1109/TPAMI.2020.2995909.
- Rombach R, Blattmann A, Lorenz D, Esser P, Ommer B. High-resolution image synthesis with latent diffusion models. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2022. p. 10684-10695. Available from: https://openaccess.thecvf.com/content/CVPR2022/html/Rombach_High-Resolution_Image_Synthesis_With_Latent_Diffusion_Models_CVPR
_2022_paper.html - Radford A et al. Learning transferable visual models from natural language supervision. In: Proceedings of the 38th International Conference on Machine Learning. PMLR. 2021;139:8748-8763. Available from: https://proceedings.mlr.press/v139/radford21a.html
- Bai Y et al. DreamDiffusion: high-quality EEG-to-image generation with temporal masked signal modeling and CLIP alignment. In: Computer Vision - ECCV 2024. Cham: Springer; 2024. p. 472-488. doi:10.1007/978-3-031-72751-1_27.
- Cao X, Gong P, Zhang L, Zhang D. EEG-CLIP: a transformer-based framework for EEG-guided image generation. Neural Netw. 2026;194:108167. doi:10.1016/j.neunet.2025.108167.
- Liu Y et al. FSDBN: foreground-aware EEG-visual alignment via dynamic brain networks. arXiv [Preprint]. 2026. Available from: https://arxiv.org/abs/2607.18344
- Yin F, Zheng C, Gong P, Guan D, Zhu Q. Neural visual decoding via cognitive-guided adaptive blurring and information-constrained alignment. arXiv [Preprint]. 2026. Available from: https://arxiv.org/abs/2605.16418
- Liu J, Gong P, Zheng C, Liu Y, Zhu Q. Multi-level bidirectional biomimetic learning for EEG-based visual decoding. arXiv [Preprint]. 2026. Available from: https://arxiv.org/abs/2605.04680
- Fei T et al. Perceptogram: reconstructing visual percepts and presumptive electrode preference from EEG. arXiv [Preprint]. 2024. Available from: https://arxiv.org/abs/2404.01250
- Li D, Wei C, Li S, Zou J, Liu Q. Visual decoding and reconstruction via EEG embeddings with guided diffusion. Adv Neural Inf Process Syst. 2024;37:102822-102864. doi:10.52202/079017-3266.
- Gifford AT, Dwivedi K, Roig G, Cichy RM. A large and rich EEG dataset for modeling human visual object recognition. Neuroimage. 2022;264:119754. doi:10.1016/j.neuroimage.2022.119754.
- Kipf TN, Welling M. Semi-supervised classification with graph convolutional networks. In: International Conference on Learning Representations. 2017. Available from: https://openreview.net/forum?id=SJU4ayYgl
- Chen T, Kornblith S, Norouzi M, Hinton G. A simple framework for contrastive learning of visual representations. In: Proceedings of the 37th International Conference on Machine Learning. PMLR. 2020;119:1597-1607. Available from: https://proceedings.mlr.press/v119/chen20j.html
- Ramoser H, Muller-Gerking J, Pfurtscheller G. Optimal spatial filtering of single trial EEG during imagined hand movement. IEEE Trans Rehabil Eng. 2000;8(4):441-446. doi:10.1109/86.895946.
- Bai S, Kolter JZ, Koltun V. An empirical evaluation of generic convolutional and recurrent networks for sequence modeling. arXiv [Preprint]. 2018. Available from: https://arxiv.org/abs/1803.01271
- Woo S, Park J, Lee JY, Kweon IS. CBAM: convolutional block attention module. In: European
Conference on Computer Vision. Cham: Springer; 2018. p. 3-19. Available from:
https://doi.org/10.1007/978-3-030-01234-2_1 - Hoerl AE, Kennard RW. Ridge regression: biased estimation for nonorthogonal problems. Technometrics. 1970;12(1):55-67. doi:10.1080/00401706.1970.10488634.
- Zhou ZH. Ensemble Methods: Foundations and Algorithms. Boca Raton: Chapman and Hall/CRC; 2012.
- Ho J, Jain A, Abbeel P. Denoising diffusion probabilistic models. Adv Neural Inf Process Syst. 2020;33:6840-6851. Available from: https://proceedings.neurips.cc/paper/2020/hash/4c5bcfec8584af0d967f1ab10179ca4b-Abstract.html
- Ho J, Salimans T. Classifier-free diffusion guidance. arXiv [Preprint]. 2022. Available from: https://arxiv.org/abs/2207.12598
- Kingma DP, Welling M. Auto-encoding variational Bayes. In: International Conference on Learning Representations. 2014. Available from: https://openreview.net/forum?id=33X9fd2-9FyZd
- Hebart MN et al. THINGS: a database of 1,854 object concepts and more than 26,000 naturalistic object images. PLoS One. 2019;14(10):e0223792. doi:10.1371/journal.pone.0223792.
Yeniden basım ve izinler
Bu makale yayımlandı
Video yakında