基因报告基因检测是一种成熟且强大的工具,用于解析DNA序列与其基因调控活性之间的关系。将候选调控元件与携带可识别序列标签的报告基因相偶联,可实现这些检测的大规模平行化。
本文内容
勘误通知
Important: There has been an erratum issued for this article. View Erratum Notice
摘要
摘要
基因报告基因检测是一种成熟且强大的工具,用于解析DNA序列与其基因调控活性之间的关系。然而,由于需要对每个目标序列分别进行克隆,并利用蛋白质荧光或酶活性作为调控活性的替代指标来检测其功能,该检测方法的潜在通量一直受到限制。近年来,高通量DNA合成与测序技术的进步使得克服这些限制成为可能,通过多重化方式构建和分析大规模报告基因文库。本方案描述了一种大规模并行报告基因检测(Massively Parallel Reporter Assay, MPRA)的实施方法,可在单个细胞培养皿中直接比较数十万个假定调控序列的活性。
引言
大规模并行报告基因检测(Massively Parallel Reporter Assays, MPRA)能够对成千上万至数十万条DNA序列的转录调控活性进行多重化测量1-7。在最常见的实施方式中,通过将每条目标序列与一个合成报告基因相连接来实现多重检测,该报告基因在其开放阅读框(ORF)下游包含一个可识别的序列标签(图1)。在转染、RNA提取并对报告基因转录本的3’端进行深度测序后,可通过各序列标签的相对丰度推断其对应序列的相对活性。

图1. MPRA 概述。 通过将假定的调控序列与合成报告基因连接,构建MPRA报告载体文库,该报告基因包含一个“惰性”开放阅读框(如GFP或luciferase)及其下游的识别序列标签。将该文库转染 大规模 将报告基因mRNA导入培养细胞群体,随后回收转录的报告基因mRNA。利用深度测序技术对报告mRNA和转染质粒中每种标签的出现次数进行计数。通过mRNA计数与质粒计数的比值,可推断相应调控序列的活性。经Melnikov许可改编, 等2.
MPRA 可适用于多种实验设计,包括:1)对单个基因调控元件进行全面的诱变分析;2)在目标基因座范围内扫描新的调控元件;3)检测自然遗传变异对一组假定的启动子、增强子或沉默子的影响;以及 4)半理性设计合成调控元件。序列变异文库可通过多种方法构建,包括在可编程微阵列上进行寡核苷酸文库合成(OLS)2,3,6,7、使用简并寡核苷酸组装1,4、组合连接法8以及基因组 DNA 片段化5。
本方案描述了利用 OLS 方法及 pMPRA1 与 pMPRAdonor1 载体(Addgene 编号分别为 49349 和 49352;http://www.addgene.org)构建启动子变异体文库的过程,将该文库瞬时转染至培养的哺乳动物细胞,随后通过深度测序分析其关联标签(Tag-Seq)来定量测定启动子活性。该方案的早期版本曾用于 Melnikov et al. Nature Biotechnology 30, 271-277 (2012) 以及 Kheradpour et al. Genome Research 23, 800-811 (2013) 所报道的研究中。
方案
1. 序列设计与合成
- 开始进行MPRA时,首先设计并合成待检测调控活性的序列。为了与pMPRA载体系列兼容,每个序列应按照以下模板设计:5’-ACTGGCCGCTTCACTG-var-GGTACCTCTAGA-tag-AGATCGGAAGAGCGTCG-3’,其中var表示待检测的序列,tag表示一个或多个用于识别的标签。
- 两个可变区域(var和tag)之间由一对KpnI(GGTACC)和XbaI(TCTAGA)限制性酶切位点分隔,以便于将报告基因片段定向连接于两者之间。此外,通过PCR将引入两个不同的SfiI(GGCCNNNNNGGCC)位点,以实现向pMPRA载体骨架的定向连接。可变区域中不得含有上述任何限制性酶切位点的额外拷贝。如有必要,可替换其中一种或多种限制性内切酶,前提是所选替代酶满足以下两个条件:1)能够在DNA分子末端附近高效切割;2)在载体序列其他位置无切割位点。详见“讨论”部分的更多细节。
- 从商业供应商处获取表1中列出的所需引物。
| MPRA_SfiI_F | GCTAAGGGCCTAACTGGCCGCTTCACTG |
| MPRA_SfiI_R | GTTTAAGGCCTCCGTGGCCGACGCTCTTC |
| TAGseq_P1 | AATGATACGGCGACCACCGAGATCTACACT CTTTCCCTACACGACGCTCTTCCGATCT |
| TAGseq_P2 | CAAGCAGAAGACGGCATACGAGAT[index]GTGAC TGGAGTTCAGACGTGTGCTCTTCCGATCTCGAG GTGCCTAAAGG |
表1. 引物序列。 [index] 表示用于多重测序的6到8个核苷酸的索引序列。需获得至少8种带有不同索引的TagSeq-P2引物。所有引物均应通过HPLC或PAGE进行纯化。
- 寡核苷酸文库可从商业供应商或核心设施获得,也可根据制造商说明使用可编程的基于微阵列的寡核苷酸合成仪制备。将OLS产物重悬于100 µl TE 0.1缓冲液中。
- 在10% TBE-尿素变性聚丙烯酰胺凝胶上电泳分析寡核苷酸文库。每泳道上样约1 pmol,并用对单链DNA敏感的荧光染料染色以评估其质量(图2A)。
- 若可观察到对应于全长寡核苷酸的清晰条带(图2A,泳道1和2),则切下相应的丙烯酰胺凝胶条带,加入100 µl TE 0.1缓冲液中,室温振荡过夜洗脱寡核苷酸;否则,直接使用原始OLS悬液进行后续操作。
- 采用乳液PCR9扩增寡核苷酸文库并添加SfiI接头。
- 按照表2所述配制50 µl PCR反应体系。然后与Micellula DNA Emulsion and Purification试剂盒中的300 µl油相和表面活性剂混合物混合,在4 °C下涡旋振荡5分钟。
| 试剂 | 1x 体积 (µl) |
| Herculase II Fusion DNA Polymerase | 0.5 |
| 5x Herculase II 反应缓冲液 | 10 |
| dNTP (10 mM each) | 1.25 |
| BSA (20 mg/ml) | 1.25 |
| 引物 MPRA_SfiI_F (25 µM) | 0.25 |
| 引物 MPRA_SfiI_R (25 µM) | 0.25 |
| OLS 模板 (1-10 attomol) | 可变 |
| 无核酸酶水 | 加至 50 |
表2. 乳化PCR反应混合液(水相)。
- 采用能够获得最大扩增产物产量且不出现非特异性条带的浓度(参见第1.12节)。
- 将生成的乳液分装至PCR管中,进行20个循环的PCR扩增(95 °C预变性2 min,20个循环:95 °C变性20 sec,55 °C退火20 sec,72 °C延伸30 sec,最后72 °C延伸3 min)。
- 将每个350 µl的乳液PCR反应产物合并,加入1 ml异丁醇,短暂涡旋振荡以破乳,随后使用DNA纯化柱纯化扩增产物。
- 取部分产物在2%或4%琼脂糖凝胶上电泳,以确认扩增产物无非特异性条带(图2B)。

图 2. 寡核苷酸合成文库的制备。 A) 在变性 10% TBE-尿素聚丙烯酰胺凝胶上电泳的三种不同的原始寡核苷酸合成文库(OLS)。可在文库 1 和 2 中观察到对应于全长寡核苷酸(*)的条带,并可进行切胶回收。文库 3 含有干扰 PAGE 纯化的污染物。若出现此情况,应直接进行 PCR 扩增。B) 同一寡核苷酸文库经开放体系 PCR 和乳液 PCR 扩增后的产物在琼脂糖凝胶上的电泳结果。复杂寡核苷酸文库的 PCR 扩增常产生嵌合产物及其他扩增假象,表现为较高或较低的条带。乳液 PCR 可减少此类假象产物的生成。
2. 文库构建
- 通过在50 °C下用SfiI酶切质粒pMPRA1 2小时,制备线性化的质粒骨架,随后在1%琼脂糖凝胶上电泳,切下骨架条带(本例中为2.5 kb),并使用凝胶纯化离心柱进行纯化。
- 将步骤1.4中的乳液PCR产物在50 °C下用SfiI酶切2小时,并使用DNA纯化柱进行纯化。
- 为将启动子-标签文库连接至线性化载体骨架,设置连接反应体系,包含100 ng经酶切的PCR产物、50 ng线性化载体骨架及T4 DNA连接酶。在16 °C孵育过夜,随后在65 °C加热20分钟以灭活连接酶。
- 将连接反应产物转化至E. coli中。为保持文库复杂性,转化获得的菌落数(cfu)应至少为设计文库中不同启动子-标签组合数的10倍以上。
- 当标签总数约为100,000时,通常可通过每文库进行6–8个平行转化来达到目标cfu数。
- 每次转化时,将50 µl感受态E. coli细胞与2 µl连接混合物在冰上混合,通过电穿孔转化,随后在800 µl SOC培养基中于37 °C振荡培养1小时以恢复细胞生长,最后合并各平行转化的细胞。
- 为评估转化效率,取部分恢复培养的细胞进行系列稀释,涂布于含50–100 µg/ml羧苄青霉素的LB琼脂平板,37 °C过夜培养。总cfu数估算公式为:(观察到的cfu) × (稀释倍数) × (V - v) / v,其中V为恢复细胞的总体积,v为用于系列稀释的取样体积。
- 同时,将剩余的恢复细胞用于接种200 ml LB培养基(补充100 µg/ml羧苄青霉素),在37 °C摇床培养箱中过夜培养,随后按照标准流程提取质粒DNA。
- 取部分提取的质粒文库,在50 °C下用SfiI酶切2小时,并在1%琼脂糖凝胶上电泳,以确认插入片段的存在。
- 使用KpnI和XbaI在启动子变体与标签之间切割,对质粒文库进行线性化。为最大化酶切效率,进行连续酶切:
- 首先在37 °C下用KpnI酶切1小时,并使用磁珠纯化;其次加入1 U虾碱性磷酸酶,在37 °C下用XbaI酶切2小时,65 °C加热5分钟以灭活酶,再使用磁珠纯化。
- 取部分产物在1%琼脂糖凝胶上电泳,以验证完全线性化。若可见未切割质粒,则应对线性化片段进行凝胶纯化。
- 为构建适用于转染哺乳动物细胞的MPRA文库,将带有KpnI/XbaI兼容末端的ORF连接至线性化的中间文库中。
- 为从pMPRAdonor1中制备兼容的luc2 ORF片段,将该质粒在37 °C下用KpnI和XbaI酶切1小时,并在1%琼脂糖凝胶上电泳。切下ORF片段(本例中为1.7 kb),并使用凝胶纯化离心柱进行纯化。
- 按照步骤2.3–2.8所述方法,将ORF片段克隆至线性化的中间文库中。
- 取MPRA文库部分样品(相当于1–2 µg),在37 °C下用KpnI酶切1小时,并在1%琼脂糖凝胶上电泳。若酶切后文库呈现单一主带,则进入第3节。若观察到额外条带(通常对应于残留的中间构建体),可按以下方法进一步纯化:
- 取3–5 µg受污染的文库,在37 °C下用KpnI酶切1小时,并在0.8%琼脂糖凝胶中于4 °C过夜电泳。
- 切下正确的文库条带,使用凝胶纯化离心柱纯化DNA,并在37 °C下使用高浓度T4 DNA连接酶进行自连1小时。随后按照步骤2.8所述重复转化及最终文库DNA的提取。
3. 转染、干扰及RNA提取
- 针对每次独立转染,根据 MPRA 文库复杂性(见讨论部分)确定所需培养的细胞数量,并在适当的培养基中进行培养。例如,在 DMEM 培养基中培养 HEK293T/17 细胞,该培养基需添加 10% 胎牛血清(FBS)以及 L-谷氨酰胺/青霉素/链霉素。每种文库和实验条件均需至少进行两次独立的转染培养。
- 使用 MPRA 质粒转染培养的细胞。转染方法和条件必须根据每种细胞类型进行优化。对于每个转染样本,保留一份质粒 DNA 等分试样(50–100 ng),作为配对对照。
- 例如,将 0.5 × 10⁷ 个在 10 cm 培养皿中生长至约 50% 汇合度的 HEK293T/17 细胞,用 1 ml Opti-MEM I Reduced Serum Medium 中含有 10 µg 质粒 DNA 的溶液进行转染,同时加入 30 µl Lipofectamine LTX 和 10 µl Plus Reagent。转染 5 小时后移除转染混合物,让细胞恢复培养 24–48 小时。
- 可选步骤:如有需要,实施相应的处理以激活所设计文库中依赖特定细胞环境或信号通路的调控序列。
- 收集细胞,并按照制造商说明书,使用标准的寡聚(dT)纤维素柱或磁珠分离 poly(A)+ mRNA。
- 确保所用柱或磁珠的最大结合容量超过从收集细胞中预期获得的总 mRNA 量。例如,第 3.3 节中预期的产量约为 0.5–2.5 µg mRNA。
4. 标签测序(Tag-Seq)
- 为消除转染细胞裂解液中质粒DNA的残留,将每20 µl mRNA样品与1 µl Turbo DNase(2 U)和2.3 µl 10x Turbo DNase缓冲液混合,在37 °C孵育1小时;随后在室温下加入2.4 µl Turbo DNase失活试剂,混匀后孵育5分钟,以10,000 g离心90秒,然后将上清转移至新管中。
- 取60–100 ng各mRNA样品,按第4.6节所述进行PCR以检测纯度,随后在琼脂糖凝胶上电泳分析产物。若可见特异性扩增条带(若使用含luc2的pMPRA1载体,则条带大小约为0.25 kb),则对处理后的mRNA进行柱纯化,并重复DNase处理步骤。
- 为构建Tag-Seq测序文库,需通过PCR将报告基因mRNA反转录为cDNA,并添加测序接头。
- 按表3所述配制mRNA与反转录引物的混合物,在65 °C孵育5分钟,随后置于冰上。同时,按表4所述配制cDNA合成反应体系。
| 试剂 | 1x 体积 (µl) |
| mRNA 样品(总量 400-700 ng) | 8 |
| Oligo-0dT (50 µM) | 1 |
| dNTP (每种 10 mM) | 1 |
表3. cDNA合成用RNA/逆转录引物混合液。
| 试剂 | 1x 体积 (µl) |
| 10x SuperScript III RT Buffer | 2 |
| MgCl2 (25 mM) | 4 |
| DTT (0.1 M) | 2 |
| RNaseOut (40 U/µl) | 1 |
| SuperScript III (200 U/µl) | 1 |
表4. cDNA合成反应体系。
- 轻柔混合mRNA/RT引物混合物与cDNA合成混合物。在50 °C孵育50分钟,85 °C孵育5分钟,然后置于冰上。最后,加入2 U的核糖核酸酶H,在37 °C孵育20分钟。
- 按照表5所述设置PCR反应,以4–6 µl cDNA反应混合物或50 ng报告质粒作为模板。随后进行PCR扩增(95 °C预变性2分钟,26个循环:95 °C变性30秒、55 °C退火30秒、72 °C延伸30秒,最后72 °C延伸3分钟)。
| 试剂 | 1x 体积 (µl) |
| 2x PfuUltra II HotStart PCR Master Mix | 25 |
| 引物 TagSeq_P1 (25 µM) | 0.5 |
| 引物 TagSeq_P2 (25 µM) | 0.5 |
| 模板 (mRNA、cDNA 混合物或质粒 DNA) | 变量 |
| 无核酸酶水 | 加至 50 |
表5. Tag-Seq PCR 反应体系。
- 将PCR产物经2%琼脂糖凝胶电泳分离,切下对应于Tag-Seq文库扩增子的条带(若使用含luc2的pMPRA1载体,则大小约为0.25 kb),并利用凝胶纯化离心柱回收这些片段。
- 将纯化后的Tag-Seq扩增子混合、变性后,直接使用Illumina测序仪进行测序。
- 通过过滤低质量读段:剔除所有 a) 在测序标签区域内存在一个或多个Phred质量值低于30的位点,或 b) 与设计的标签序列不完全匹配的读段。统计每个剩余标签在各文库中出现的次数。将标签计数标准化为TPM(每百万测序标签数),然后计算每对测序文库中mRNA来源标签计数与质粒来源标签计数的比值。若多个不同的标签与同一序列变异相连,下游分析中采用其比值的中位数。
结果
多重报告分析(MPRA)有助于对转录调控元件的序列-活性关系进行高分辨率、定量的解析。一次成功的MPRA实验通常会对转染文库中大多数序列产生高度可重复的测量结果(图3A)。如果观察到重复性差(图3B),则表明回收的RNA样本中报告mRNA的浓度过低,其原因可能是:1)被检测序列本身的绝对活性较低,或2)转染效率低下。
图4展示了在HEK293细胞中检测约37,000个随机变异的人类IFNB基因上游145 bp序列所生成的代表性“信息足迹”1,2,检测条件为暴露于或不暴露于仙台病毒。病毒依赖性地清晰识别出启动子TATA盒和已知的近端增强子10为富含信息的区域。
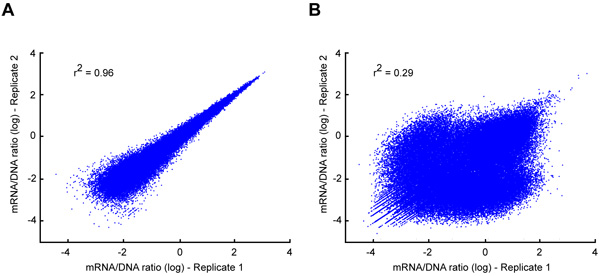
图 3. Tag-Seq 重复性。 散点图展示了两次独立重复转染实验中 Tag-Seq 数据的示例,分别显示高重复性 (A) 和低重复性 (B)。后者图中存在大量异常标签,仅在两个重复样本中的一个出现高 mRNA 计数。此类假象通常表明报告 mRNA 的浓度太低,无法进行定量 PCR 扩增,这可能是由于报告载体的绝对活性较低,或转染效率低下所致。
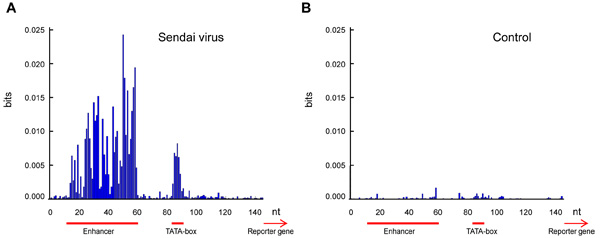
图 4. 人 IFNB 转录起始位点及近端增强子的信息足迹分析。 在 HEK293 细胞中,使用 MPRA 检测了约 37,000 种人类 IFNB 基因上游 145 个核苷酸(nt)区域的随机变异体,分别在(A)感染仙台病毒和(B)未感染条件下进行。蓝色条形表示报告基因输出与每个位置核苷酸之间的互信息。在病毒感染后,近端增强子和 TATA 框表现为高信息含量区域。
讨论
MPRA 是一种灵活且强大的工具,可用于解析基因调控元件中的序列-活性关系。MPRA 实验的成功至少依赖于三个因素:1)序列文库的精心设计,2)在扩增和克隆过程中尽量减少人为偏差,3)高效的转染效率。
报告基因构建体中可变区域的可能长度主要取决于所使用的合成或克隆技术。标准的寡核苷酸合成(OLS)通常限制在约 200 nt 以内,但本方案适用于至少长达 1,000 nt 的插入片段。需要注意的是,高度重复或具有强二级结构的可变区域可能由于 PCR 和克隆偏差而导致代表性不足。用于标识各个可变区域的标签长度应为 10–20 nt,且理想情况下,所有标签的设计应确保任意两个标签之间至少存在两个核苷酸的差异。在可能的情况下,应避免使用包含已知 microRNA 或其他可能影响 mRNA 稳定性因子的种子序列的标签。
在MPRA实验设计中,一个关键参数是文库中包含的不同报告基因构建体的总数(即设计复杂度,记为CD)。在实际操作中,CD受限于可转染的培养细胞数量。通常建议,转染的细胞总数应至少为CD的50至100倍。例如,若可转染2000万个细胞,且转染效率为50%,则CD不应超过约20万。需要注意的是,CD等于不同的调控序列变体数量乘以每个序列所连接的不同标签数量。每个调控序列连接的独立标签越多,对该序列活性的估计就越准确(因为可对来自不同标签的测量结果进行平均),但单次实验中所能检测的独立变体数量也就越少。最优选择取决于具体的实验设计。在简单的“启动子分析”实验中,若需将数学模型拟合到汇总的测量数据,则每个变体使用一个标签通常已足够。而在筛查导致调控活性变化的单核苷酸多态性(SNP)时,每个等位基因可能需要使用20个或更多的标签,以获得具有统计学显著性的结果,因为每对等位基因的比较都需要进行独立的假设检验。
如果待检测的序列预计不含转录起始位点,则可在同一片段中添加一个恒定启动子。例如,pMPRAdonor2(Addgene编号49353)包含一个最小TATA框启动子,适用于上游可变区域预计具有显著增强子活性的情况;而pMPRAdonor3(Addgene编号49354)包含一个经过修饰的强效SV40病毒启动子,适用于可变区域预计含有沉默子活性或其他负调控元件的情况。
原始的寡核苷酸合成(OLS)产物通常含有大量截短的寡核苷酸片段。这些片段可能干扰目标序列的准确PCR扩增,特别是当序列间存在显著同源性时。采用聚丙烯酰胺凝胶电泳(PAGE)纯化去除截短的合成产物,并结合乳液PCR以最大限度减少扩增过程中的人为假象,是确保文库高质量的有效方法。如果上述任一步骤难以实施,则必须尽量减少每轮扩增中的PCR循环次数。将克隆文库在液体培养基中进行筛选和扩增通常足以维持设计的多样性;但如果使用易发生重组的载体或观察到显著的表征偏差,可将回收的细胞直接涂布于大型LB琼脂平板上,以单菌落形式扩增后刮取菌体用于DNA提取。此外,还需考虑合成错误可能带来的影响,此类错误在OLS中通常发生频率为每100至500个碱基出现一次。建议在转染前对报告基因构建体进行全长测序,以识别并纠正此类错误。
无需将报告基因构建体导入转染培养物中的每个细胞,但转染效率低于约50%时可能导致信噪比较差。在新细胞类型中进行MPRA实验之前,建议优化转染条件。当处理难以转染的细胞类型时,可通过预先筛选已转染的细胞来增强MPRA信号。pMPRA载体系列包含一些变体,可组成型表达截短的细胞表面标记物,用于在RNA提取前通过物理方法富集转染细胞(例如,Addgene编号49350和49351)。
披露
作者声明不存在任何竞争性财务利益。
致谢
本研究由美国国立卫生研究院下属的国家人类基因组研究所通过资助编号 R01HG006785 提供支持。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| 寡核苷酸文库合成 | 安捷伦、CustomArray 或其他 OLS 供应商 | 定制 | 若采用 OLS 构建方法 |
| pMPRA1 | Addgene | 49349 | MPRA 质粒骨架 |
| pMPRAdonor1 | Addgene | 49352 | luc2 ORF 供体质粒 |
| TE 0.1 缓冲液(10 mM Tris-HCl,0.1 mM EDTA,pH 8.0) | 通用 | n/a | OLS缓冲液 |
| Novex TBE-尿素凝胶,10% | Life Technologies | EC6875BOX | PAGE纯化OLS产物 |
| Novex TBA-尿素上样缓冲液 | Life Technologies | LC6876 | PAGE纯化OLS产物 |
| SYBR Gold 核酸凝胶染料 | Life Technologies | S-11494 | PAGE纯化OLS产物 |
| 微滴DNA乳液 & 纯化试剂盒 | EURx/CHIMERx | 3600-01 | 通过乳液PCR进行文库扩增 |
| Herculase II Fusion DNA聚合酶 | 安捷伦 | 600675 | 乳液PCR用聚合酶 |
| SfiI | New England Biolabs | R0123S | 使用 pMPRA 载体进行文库克隆 |
| KpnI-HF | 新英格兰生物实验室 | R3142S | 使用 pMPRA 载体进行文库克隆 |
| XbaI | New England Biolabs | R0145S | 使用 pMPRA 载体进行文库克隆 |
| T4 DNA连接酶(2,000,000 单位/毫升) | New England Biolabs | M0202T | 使用 pMPRA 载体进行文库克隆 |
| One Shot TOP10 Electrocomp E. coli | Life Technologies | C4040-50 | 使用 pMPRA 载体进行文库克隆 |
| 含羧苄青霉素的LB琼脂及液体培养基 | 通用 | n/a | 克隆用培养基 |
| E-Gel EX 琼脂糖凝胶 1% | Life Technologies | G4010-01 | 文库验证与纯化 |
| E-Gel EX 琼脂糖凝胶,2% | Life Technologies | G4010-02 | 文库验证与纯化 |
| MinElute 胶回收试剂盒 | Qiagen | 28604 | 文库与载体骨架纯化 |
| EndoFree 质粒大提试剂盒 | Qiagen | 12362 | 基因组DNA提取 |
| 细胞培养基 | n/a | n/a | 实验特异性 |
| 转染试剂 | n/a | n/a | 实验特异性 |
| MicroPoly(A)Purist 试剂盒 | Life Technologies | AM1919 | mRNA 分离 |
| TURBO DNA-free 试剂盒 | Life Technologies | AM1907 | 质粒DNA去除 |
| SuperScript III 第一链合成系统 | Life Technologies | 18080-051 | cDNA合成 |
| PfuUltra II Hotstart PCR 预混液 | 安捷伦 | 600850 | 用于Tag-Seq PCR的聚合酶 |
| 引物(见正文) | IDT | 定制 | PAGE 纯化 Tag-Seq 引物 |
参考文献
- Kinney, J., Murugan, A., Callan, C. G., Cox, E. C. Using deep sequencing to characterize the biophysical mechanism of a transcriptional regulatory sequence. Proceedings of the National Academy of Sciences USA. 107 (20), 9158-9163 (2010).
- Melnikov, A., et al. Systematic dissection and optimization of inducible enhancers in human cells using a massively parallel reporter assay. Nature Biotechnology. 30 (3), 271-277 (2012).
- Patwardhan, R. P., Lee, C., Litvin, O., Young, D. L., Pe’er, D., Shendure, J. High-resolution analysis of DNA regulatory elements by synthetic saturation mutagenesis. Nature Biotechnology. 27 (12), 1173-1175 (2009).
- Patwardhan, R. P., et al. Massively parallel functional dissection of mammalian enhancers in vivo. Nature Biotechnology. 30 (3), 265-270 (2012).
- Arnold, C. D., Gerlach, D., Stelzer, C., Boryń, ŁM., Rath, M., Stark, A. Genome-wide quantitative enhancer activity maps identified by STARR-seq. Science (New York, N. Y.). 339 (6123), 1074-1077 (2013).
- Kheradpour, P., et al. Systematic dissection of regulatory motifs in 2000 predicted human enhancers using a massively parallel reporter assay. Genome Research. 23 (5), 800-811 (2013).
- White, M. A., Myers, C. A., Corbo, J. C., Cohen, B. A. Massively parallel in vivo enhancer assay reveals that highly local features determine the cis -regulatory function of ChIP-seq peaks. Proceedings of the National Academy of Sciences USA. 110 (29), 11952-11957 (2013).
- Mogno, I., Kwasnieski, J. C., Cohen, B. A. Massively parallel synthetic promoter assays reveal the in vivo effects of binding site variants. Genome Research. 23 (11), 1908-1915 (2013).
- Schütze, T., et al. A streamlined protocol for emulsion polymerase chain reaction and subsequent purification. Analytical Biochemistry. 410 (1), 155-157 (2011).
- Panne, D., Maniatis, T., Harrison, S. C. An atomic model of the interferon-beta enhanceosome. Cell. 129 (6), 1111-1123 (2007).
重印与许可
勘误
Formal Correction: Erratum: Massively Parallel Reporter Assays in Cultured Mammalian Cells
Posted by JoVE Editors on 3/01/2015. Citeable Link.
null
