本方案描述了利用常规收集的临床数据开发和评估一种可解释的集成树型机器学习模型,以预测糖尿病患者的骨质疏松风险。
需要JoVE订阅才能观看此内容。 请登录或开始免费试用
本文内容
摘要
摘要
糖尿病与骨骼脆性增加及骨折风险升高相关;然而,在糖尿病人群中早期识别骨质疏松症(OP)仍然具有挑战性。本研究旨在开发并比较多种机器学习(ML)模型,用于预测糖尿病患者中的骨质疏松症,同时评估其临床实用性,并利用SHapley加性解释(SHAP)方法提高模型的透明度。基于MIMIC-IV数据库中常规收集的人口统计学和实验室数据,训练并验证了多种机器学习算法,包括树集成方法、梯度提升以及线性基线模型。通过区分度指标(如受试者工作特征曲线下面积(AUC)和精确率-召回率分析)、概率校准曲线以及决策曲线分析(DCA)对模型性能进行了全面评估,以衡量净临床获益。表现最优的模型进一步通过SHAP进行解释,以在全局和个体层面量化并可视化各特征的贡献。在所有评估的模型中,基于集成树的方法表现出更优的性能。ExtraTrees分类器取得了最高的验证性能(AUC = 0.862;平均精确率 = 0.866)。此外,所选模型表现出优异的概率校准能力(Brier评分 = 0.154),并在DCA中广泛的风险阈值范围内显示出显著的净临床获益。SHAP分析识别出性别和年龄为最具影响力的预测因子,其次是常规血液学和代谢类实验室指标。局部解释为个体预测提供了具有临床可解释性的洞察。一种可解释的基于集成树的模型能够利用常规可获取的临床变量有效预测糖尿病患者的骨质疏松风险。结合SHAP方法可提升临床透明度,而良好的校准性能与显著的净临床获益支持其作为糖尿病人群骨质疏松风险早期分层的可靠决策支持工具的潜在应用价值。
引言
糖尿病和骨质疏松症(OP)是两种高度常见的慢性疾病,常同时存在,导致脆性骨折、残疾和医疗成本增加,带来沉重的疾病负担。在2型糖尿病(T2D)患者中,即使通过双能X线吸收测定法(DXA)测量的面积骨密度(BMD)正常或高于预期,骨折风险仍异常升高,这表明骨“质量”和全身代谢因素在骨骼脆弱性中具有重要作用1,2。尽管DXA是临床诊断OP的标准方法,但其可及性和应用在许多地区仍有限,且基于DXA的评估可能低估糖尿病相关的骨骼风险。在人群层面,荟萃分析证据表明,糖尿病患者中骨质疏松症较为常见,但其患病率在不同队列和临床背景下存在差异3。因此,迫切需要开发实用、可扩展的风险预测工具,利用常规收集的临床数据更早识别高风险患者,从而指导有针对性的筛查和个体化预防策略,这一需求具有重要的临床意义和强烈的研究动力。
近年来,机器学习(ML)方法被越来越多地用于建模临床数据中的复杂非线性关系,并为糖尿病患者构建骨质疏松症(OP)风险预测模型。先前的研究已证明,使用梯度提升、支持向量机、神经网络以及列线图风格工具等算法可实现良好的区分能力。特别是最近的研究进展探索了创新的建模策略,例如将机器学习与模糊逻辑相结合,以基于可改变的因素来预测骨质疏松症及糖尿病相关风险4,....
访问受限。请登录或开始试用以查看此内容。
方案
数据来源与伦理声明
本回顾性研究使用了来自 MIMIC-IV(版本 3.1)的数据,该数据为 PhysioNet 上公开提供的去标识化重症监护电子健康记录数据库。该数据库包含人口统计学信息、生命体征、实验室检查、诊断、治疗操作和药物信息。
访问 MIMIC-IV 需要经过认证授权,并遵守 PhysioNet 的数据使用协议和培训要求。研究人员已完成必要的培训并获得访问权限(证书编号:68351548)。由于该数据库已去标识化,本研究分析的是匿名数据,未涉及与患者的直接接触,因此无需知情同意。完整的、可执行的建模工作流程分步展示于图1中。
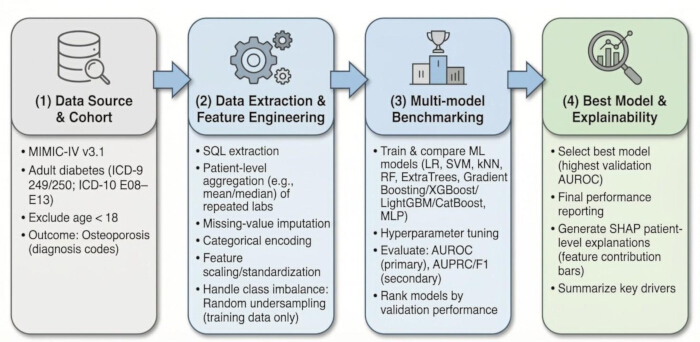
图1.糖尿病患者骨质疏松症(OP)风险预测的整体建模工作流程。研究流程的示意图,包括队列识别、数据提取、特征工程、多模型基准测试、基于验证性能的模型....
访问受限。请登录或开始试用以查看此内容。
结果
模型性能比较
为了确定糖尿病患者骨质疏松(OP)的最佳预测方法,系统性地比较了多种机器学习模型。将正则化线性分类器(逻辑回归)作为基线对照模型纳入分析。整体性能比较结果汇总于图3–6中。在所有评估的模型中,基于集成树的方法在区分能力方面均优于线性基线模型。
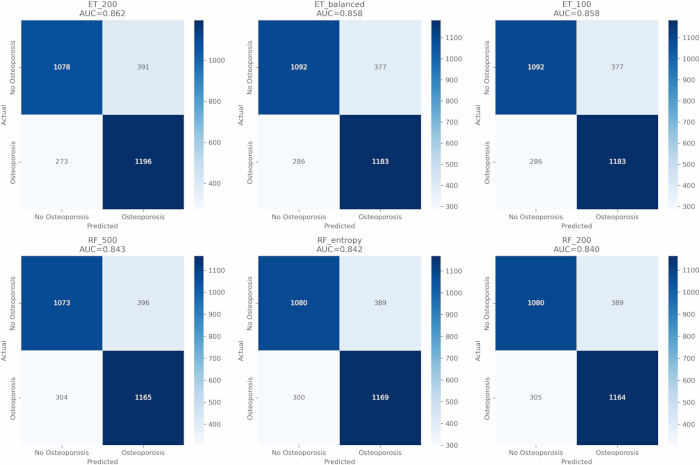
图 3.表现最佳模型的混淆矩阵。在验证集上评估的代表性模型的混淆矩阵,包括 ET_200、ET_balanced、ET_100、RF_500、RF_entropy 和 RF_200。每个矩阵显示了真阴性、假阳性、假阴性和真阳性的数量,用以说明各模型的分类性能。
访问受限。请登录或开始试用以查看此内容。
讨论
本研究系统比较了多种机器学习算法,以确定糖尿病患者中骨质疏松症(OP)的最佳预测模型。基于集成树的方法,特别是ExtraTrees模型,在区分能力、概率校准可靠性以及临床净收益方面均优于线性基线模型及其他算法类别。这些结果表明,非线性相互作用和复杂的特征关系对于准确捕捉糖尿病人群中的OP风险具有重要意义。
为了提高临床透明度,采用SHAP方法对所选模型进行解释。分析结果显示,性别和年龄是影响预测的最重要因素,这与已知的生物学证据一致,即衰老和激素变化(如雌激素缺乏或相对性腺功能减退)会损害骨微结构。除人口学因素外,血液学指标(如血红蛋白和红细胞分布宽度)以及常规代谢生化检测指标也对风险预测有所贡献。这些标志物可能反映了慢性炎症、肾功能障碍和酸碱失衡所累积的生理效应,而这些因素均与糖尿病患者的骨骼脆弱性相关。近期研究还强调了营养状况和可改变的生活方式因素在糖尿病与骨质疏松共病中的作用18,19。常规实验室检测变量的重要作用表明,该模型捕捉到了与骨骼健康相关的更广泛的系.......
访问受限。请登录或开始试用以查看此内容。
披露
作者声明,本研究是在不存在任何可能被解释为潜在利益冲突的商业或财务关系的情况下进行的。
致谢
作者衷心感谢南通市科技项目(项目编号:JC2023039)和南通市科技局社会发展指导计划(项目编号:MSZ2023054)提供的经费支持。
....访问受限。请登录或开始试用以查看此内容。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| CatBoost | Yandex | v1.2(或适用版本) | 针对分类特征优化的梯度提升算法 |
| imbalanced-learn (SMOTE) | Scikit-learn Contrib | v0.11(或适用版本) | 用于执行合成少数类过采样技术(SMOTE)以实现类别平衡的库 |
| LightGBM | Microsoft Corporation | v4.0(或适用版本) | 基于决策树的梯度提升框架 |
| Matplotlib | Matplotlib 开发团队 | v3.7(或适用版本) | 用于绘制图形和性能曲线的可视化库 |
| MIMIC-IV 临床数据库 | PhysioNet | v3.1 | 公开可用的重症监护电子健康记录数据集,作为数据来源 |
| Navicat Premium | PremiumSoft CyberTech Ltd. | v17.0 | 用于基于 SQL 的数据提取的数据库管理工具 |
| NumPy | NumPy 开发者 | v1.24(或适用版本) | 用于数组操作和数据处理的数值计算库 |
| OpenPyXL | Eric Gazoni, Charlie Clark | v3.1(或适用版本) | 用于读写 Excel 文件的库 |
| Pandas | Pandas 开发团队 | v2.0(或适用版本) | 用于结构化数据集的数据操作与分析库 |
| PostgreSQL | PostgreSQL 全球开发组 | v14(或适用版本) | 用于查询和管理 MIMIC-IV 数据的关系型数据库系统 |
| Python | Python 软件基金会 | v3.8+(或适用版本) | 用于数据处理、建模与分析的编程语言 |
| Scikit-learn | Scikit-learn 开发者 | v1.3(或适用版本) | 用于模型开发、预处理和评估的机器学习库 |
| SciPy | SciPy 开发者 | v1.10(或适用版本) | 用于统计分析的科学计算库 |
| Seaborn | Michael Waskom | v0.12(或适用版本) | 用于增强图形输出的统计数据分析可视化库 |
| SHAP (SHapley Additive exPlanations) | Scott Lundberg | v0.42(或适用版本) | 利用特征归因值解释模型预测的框架 |
| XGBoost | DMLC(分布式机器学习社区) | v2.0(或适用版本) | 广泛用于结构化数据建模的梯度提升算法 |