Der genetische Reporter-Assay ist ein gut etabliertes und leistungsfähiges Werkzeug, um die Beziehung zwischen DNA-Sequenzen und ihren genregulatorischen Aktivitäten zu entschlüsseln. Die Kopplung von regulatorischen Elementkandidaten an Reportergene, die identifizierende Sequenz-Tags tragen, ermöglicht eine massive Parallelisierung dieser Assays.
Methodenartikel
Massively Parallel Reporter Assays in kultivierte Säugerzellen
In diesem Artikel
Erratum-Hinweis
Important: There has been an erratum issued for this article. View Erratum Notice
Zusammenfassung
Zusammenfassung
Der genetische Reporter-Assay ist ein gut etabliertes und leistungsfähiges Werkzeug, um die Beziehung zwischen DNA-Sequenzen und ihren genregulatorischen Aktivitäten zu entschlüsseln. Der potentielle Durchsatz dieses Assays wurde jedoch durch die Notwendigkeit begrenzt, die Aktivität jeder Sequenz einzeln zu klonen und zu testen, wobei die Proteinfluoreszenz oder die enzymatische Aktivität als Proxy für die regulatorische Aktivität verwendet wurde. Fortschritte in der Hochdurchsatz-DNA-Synthese und -Sequenzierungstechnologie haben es in jüngster Zeit ermöglicht, diese Einschränkungen zu überwinden, indem die Konstruktion und Abfrage großer Bibliotheken von Reporterkonstrukten gemultiplext wurde. Dieses Protokoll beschreibt die Implementierung eines Massively Parallel Reporter Assay (MPRA), der den direkten Vergleich von Hunderttausenden von mutmaßlichen regulatorischen Sequenzen in einer Einzelzellkulturschale ermöglicht.
Einleitung
Massively Parallel Reporter Assays (MPRA) erlauben Multiplex-Messung der Transkriptionsregulationsaktivitäten Tausende bis Hunderttausende von DNA-Sequenzen 1-7. In ihrer allgemeinsten Ausführung wird durch Multiplexen Koppeln jeder Sequenz von Interesse ein synthetisches Reportergen, das eine Identifizierungssequenz Tag stromabwärts eines offenen Leserasters enthält erzielt (ORF Abbildung 1). Nach der Transfektion der RNA-Isolierung und Sequenzierung des Tief 3 'Enden der Reportergen-Transkripten, können die relativen Aktivitäten der gekoppelten Sequenzen aus der relativen Häufigkeit der Ermittlung Variablen abgeleitet werden.

Abbildung 1. Übersicht über MPRA. Eine Bibliothek von MPRA Reporterkonstrukte durch Kopplung mutmaßlichen regulatorischen Sequenzen zu synthetischen gebautReportergene, die aus einem "inerten" ORF bestehen (wie GFP oder Luciferase), gefolgt von einem identifizierenden Sequenz-Tag. Die Bibliothek wird in Massen in eine Population von kultivierten Zellen transfiziert und transkribiert Reporter mRNA wird anschließend zurückgewonnen. Deep sequencing wird verwendet, um die Anzahl der Vorkommen der einzelnen Tag unter den Reporter-mRNAs und den transfizierten Plasmiden zählen. Das Verhältnis der mRNA zählt über Plasmid Zahlen können verwendet werden, um die Aktivität der entsprechenden Regulationssequenz abzuleiten. Angepasst mit Erlaubnis von Melnikow, et al 2.
MPRA kann zu einer breiten Vielzahl von experimentellen Designs angepasst werden, einschließlich 1) umfassende Mutagenese einzelner Gen regulatorische Elemente, 2) Überprüfung auf neue regulatorische Elemente in einem Ort von Interesse, 3) Testen der Wirkung der natürlichen genetischen Variation in einer Menge von putativen Promotoren, Enhancer oder Silencer, und 4) semi-rationale Konstruktion von synthetischen regulatorische Elemente. Libibliotheken von Sequenzvarianten können unter Verwendung einer Vielzahl von Verfahren, einschließlich Oligonukleotid-Synthese von Bibliotheken (OLS) auf programmierbaren Mikroarrays 2,3,6,7, Montage von degenerierten Oligonukleotiden 1,4, kombinatorische Ligations 8 und Fragmentierung der genomischen DNA, 5 erzeugt werden.
Dieses Protokoll beschreibt die Konstruktion einer Bibliothek von Promotorvarianten mit OLS und die pMPRA1 und pMPRAdonor1 Vektoren (Addgene IDs 49349 und 49352 sind; http://www.addgene.org) transiente Transfektion dieser Bibliothek in kultivierte Säugerzellen und die anschließende Quantifizierung der Promotor-Aktivitäten von deep sequencing der ihnen zugeordneten Tags (Tag-Seq). Frühere Versionen von diesem Protokoll wurden in der Forschung in Melnikov et al. Nature Biotechnology 30, 271-277 (2012) und in Kheradpour et al. Genome Research 23, 800-811 (2013) berichtet, verwendet.
Protokoll
1. Sequenz Design und Synthese
- Beginnen MPRA mit dem Design und der Synthese von Sequenzen, die Marktaktivität untersucht werden. Für die Kompatibilität mit dem pMPRA Vektor-Serie, entwerfen jede Sequenz benutzen die folgende Vorlage: 5'-ACTGGCCGCTTCACTG- var -GGTACCTCTAGA- Tag -AGATCGGAAGAGCGTCG-3 ', wo var bezeichnet die Sequenz zu untersuchenden und Tag bedeutet ein oder mehrere Tags identifizieren.
- Die beiden variablen Regionen (var und Tag) werden durch ein Paar von KpnI (GGTACC) und XbaI (TCTAGA) Restriktionsstellen getrennt, um gerichtete Ligation eines Reportergens Fragment zwischen ihnen zu erleichtern. Zusätzlich werden zwei verschiedene SfiI (GGCCNNNNNGGCC) Seiten durch PCR zugesetzt werden, um gerichtete Ligation in die pMPRA Rückgrat zulassen. Die variablen Regionen dürfen nicht zusätzliche Kopien eines dieser Restriktionsstellen enthalten. Falls erforderlich, eine oder mehrere dieser Restriktionsenzyme ersetzt werden kann, Solange die Ersatz 1) ermöglichen effizientes Schneiden in der Nähe der Enden der DNA-Moleküle, und 2) nicht an anderer Stelle in der Vektorsequenz geschnitten. Siehe Diskussion für weitere Informationen.
- Rufen Sie die in Tabelle 1 von einem kommerziellen Anbieter aufgelistet erforderlich Primer.
| MPRA_SfiI_F | GCTAAGGGCCTAACTGGCCGCTTCACTG |
| MPRA_SfiI_R | GTTTAAGGCCTCCGTGGCCGACGCTCTTC |
| TAGseq_P1 | AATGATACGGCGACCACCGAGATCTACACT CTTTCCCTACACGACGCTCTTCCGATCT |
| TAGseq_P2 | CAAGCAGAAGACGGCATACGAGAT [index] GT GACTGGAGTTCAGACGTGTGCTCTTCCGATCTCGAGG |
Tabelle 1. Primer-Sequenzen. [Index] bezeichnet eine 6 bis 8 nt Index Sequenz für Multiplex-Sequenzierung verwendet. Erhalten mindestens 8 TagSeq-P2 Primer mit unterschiedlichen Indizes. Alleder Primer sollten durch HPLC oder PAGE gereinigt werden.
- Oligonukleotid-Bibliotheken können aus einer kommerziellen Lieferanten oder Kerneinrichtung erhalten werden, oder durch Verwendung eines programmierbaren Microarray-basierte Oligonucleotidsynthesizer wie vom Hersteller beschrieben erzeugt. Resuspendieren der OLS-Produkte in 100 ul TE 0,1 Puffer.
- Führen Sie die Oligonukleotid-Bibliotheken auf einem 10% TBE-Harnstoff-Denaturierung Polyacrylamid-Gel. Legen Sie ca. 1 pmol pro Bahn und Fleck mit ssDNA empfindlichen Fluoreszenzfarbstoff, um ihre Qualität (2A) zu beurteilen.
- Wenn eine diskrete Bande, die den Volllängen-Oligonukleotide können visualisiert werden (Abbildung 2A, Bahnen 1 und 2), die Verbrauchs den entsprechenden Acrylamid-Gel Slice und eluieren Oligonukleotide in 100 ul TE 0,1 über Nacht bei Raumtemperatur unter Schütteln. Andernfalls fahren Sie mit der RAW OLS Aufhängung.
- Verstärken und fügen SfiI Schwänze mit dem Oligonukleotid-Bibliothek mit Hilfe Emulsions-PCR 9 sup>.
- Bis 50 ul PCR-Reaktionsgemischen, wie in Tabelle 2 beschrieben. Dann verbinden sich mit 300 ul Öl und Tensid-Mischung aus der Emulsion und Micellula DNA Purification Kit und Vortex für 5 min bei 4 ° C ist.
| Reagens | 1x Volume (ul) |
| Herculase II Fusion DNA Polymerase | 0,5 |
| 5x Herculase II Reaktionspuffer | 10 |
| dNTP (10 mM jeweils) | 1,25 |
| BSA (20 mg / ml) | 1,25 |
| Primer MPRA_SfiI_F (25 uM) | 0,25 |
| Primer MPRA_SfiI_R (25 uM) | 0,25 |
| OLS-Vorlage (1-10 attomol) | variiert |
| Nuklease-freies Wasser | 50 |
- Verwenden Sie die Konzentration, die die maximale Ausbeute der Amplifikation Produkte gibt ohne das Auftreten von Artefakten (siehe Abschnitt 1.12).
- Abgeben der resultierenden Emulsion in PCR-Röhrchen und führen 20 Zyklen PCR (2 min bei 95 ° C, 20 x [20 sec 95 ° C, 20 sec bei 55 ° C, 30 sec bei 72 ° C], 3 min bei 95 ° C).
- Pool und brechen jede 350 ul Emulsion-PCR-Reaktion durch Zugabe von 1 ml Isobutanol und kurz vortexen und dann reinigen die Verstärkung Produkt mit einem DNA-Aufreinigung Spalte.
- Führen Sie einen aliquoten auf einem 2% bzw. 4% Agarose-Gel, um artefaktfreie Verstärkung (2B) zu überprüfen.

Figur 2: Herstellung von Oligonukleotid-Synthesebibliotheken. A) Drei verschiedene rohe Oligonukleotid-Synthese-Bibliotheken (OLS) auf denaturierenden 10% TBE-Harnstoff-Polyacrylamid-Gelen laufen. Banden, die in voller Länge Oligonukleotide (*) visualisiert und aus Bibliotheken 1 ausgeschnitten werden und 2. Bibliothek 3 enthält Schadstoffe, die mit PAGE Reinigung stören. Wenn dies der Fall ist, fahren Sie mit PCR-Amplifikation. B) Die Produkte von offenen und Emulsions-PCR-Amplifikation der gleichen Oligonukleotid-Bibliothek ausgeführt auf einem Agarosegel. PCR-Amplifikation von komplexen Oligonukleotid-Bibliotheken erstellt häufig chimären Produkte und andere Artefakte, die als höhere und niedrigere Bands auftreten können. Emulsions-PCR können diese Artefakte zu minimieren.
2. Library Construction
- Vorbereitung eines linearisierten Plasmid-Backbone durch Verdau mit SfiI pMPRA1 Vektor bei 50 ° C für 2 Stunden, auf einem 1% igen Agarosegel aufgetrennt, die Verbrauchs das Rückgrat Band (in diesem Fall 2,5 kb) und reinigt sie mit einem Gel-Reinigung Spin-Säule.
- Verdauendie Emulsions-PCR-Produkte aus Schritt 1.4 mit SfiI bei 50 ° C für 2 h und Reinigung mittels DNA-Reinigungssäulen.
- Um die Promotor-Tag-Bibliothek in die linearisierte Vektor-Rückgrat ligieren, bis Reaktionen mit 100 ng des verdauten PCR-Produkt, 50 ng linearisierte Vektor-Rückgrat und T4-DNA-Ligase eingestellt. Inkubieren über Nacht bei 16 ° C und dann bei 65 ° C für 20 min, um die Ligase zu inaktivieren.
- Transformation von E. coli mit dem Ligationsreaktion. Die Bibliothek Komplexität zu bewahren, wollen mindestens 10x mehr KBE erhalten, als es verschiedene Promotor-Tag-Kombinationen in der Bibliothek ausgelegt.
- Wenn die Gesamtzahl von Tags ist etwa 100.000, kann die Ziel cfu typischerweise durch Ausführen 6-8 parallelen Umwandlungen pro Bibliothek erreicht werden.
- Für jede Transformation, kombinieren 50 ul elektro E. coli-Zellen mit 2 ul Ligationsmischung auf Eis. Transformation durch Elektroporation, erholen die Zellen in 800 ul SOCMedium unter Schütteln bei 37 ° C für 1 h und dann kombinieren Zellen aus den parallel Transformationen.
- Um die Transformationseffizienz zu bewerten, plattenReihenVerdünnungen von einem alinquot der gewonnenen Zellen auf LB-Agarplatten mit 50-100 ug / ml Carbenicillin und Inkubation über Nacht bei 37 ° C aufweist. Schätzung Gesamtkolonie wie beobachtet (cfu) x (Verdünnungsfaktor) × (V - V) / V, wobei V das Gesamtvolumen der gewonnenen Zellen und v das Volumen des Aliquots für die serielle Verdünnungen gemacht.
- Gleichzeitig Verwenden der Rest der gewonnenen Zellen zur Beimpfung 200 ml LB mit 100 ug / ml Carbenicillin ergänzt. Wachsen Zellen bei 37 ° C über Nacht in einem Schüttelinkubator und dann isolieren die Plasmid-DNA nach Standardverfahren.
- Digest ein Aliquot der isolierten Plasmid-Bibliothek mit SfiI bei 50 ° C für 2 h und laufen auf einem 1% Agarose-Gel auf die Anwesenheit des Inserts zu bestätigen.
- Linearisierung der Plasmid-Bibliothek von cUtting zwischen den Promotorvarianten und Tags mit KpnI und XbaI. Um die Verdauung Effizienz zu maximieren, führen Serien Aufschlüsse:
- Zunächst verdauen mit KpnI bei 37 ° C für 1 h und reinigen mit magnetischen Kügelchen. Zweitens Verdau mit XbaI unter Zusatz von 1 U alkalischer Shrimp-Phosphatase bei 37 ° C für 2 h, Hitze inaktiviert bei 65 ° C für 5 min und dann unter Verwendung von magnetischen Kügelchen zu reinigen.
- Führen eines Aliquots auf einem 1% Agarose-Gel, um eine vollständige Linearisierung überprüfen. Wenn ungeschnittenen Plasmid sichtbar ist, sollte das linearisierte Fragment gelgereinigt werden.
- Um eine MPRA Bibliothek geeignet für die Transfektion in Säugerzellen zu erzeugen, ligieren einen ORF mit KpnI / XbaI kompatible Enden in den lineaZwischen Bibliothek.
- Wenn Sie einen kompatiblen luc2 ORF-Fragment aus pMPRAdonor1 vorzubereiten, zu verdauen, die dieses Plasmid mit KpnI und XbaI bei 37 ° C für 1 h und auf einem 1% Agarose-Gel laufen. Verbrauchsteuern Das ORF-Fragment (1,7 kB in diesem Fall) und zu reinigen mit einer Gelreinigung Spinsäule.
- Klonen Sie die ORF-Fragment in den lineaZwischen Bibliothek wie in den Schritten 2,3-2,8 beschrieben.
- Digest eines Aliquots (entsprechend 1-2 ug) des MPRA Bibliothek mit KpnI bei 37 ° C für 1 h und auf einem 1% Agarose-Gel laufen gelassen. Wenn die Bibliothek verdaut wird als Einzelband, Abschnitt 3. vorgehen, wenn zusätzliche Banden beobachtet (in der Regel um Verschleppungen von Zwischen Konstrukte entsprechend), kann die Bibliothek weiter gereinigt wie folgt:
- Verdauen 3-5 ug des kontaminierten Bibliothek mit KpnI bei 37 ° C für 1 h und auf einem 0,8% Agarose-Gel bei 4 ° C über Nacht ausgeführt.
- Auszuschneiden die korrekte Bandbibliothek, reinigen die DNA unter Verwendung einer Gel-Reinigung Spin-Säule und führen die Selbstligation unter Verwendung von hoch-konzentrierten T4-DNA-Ligase bei 37 ° C für 1 Stunde. Wiederholen Sie dann die Transformation und letzte Bibliothek DNA-Isolierung, wie in Schritt 2.8 beschrieben.
3. Transfection, Störungs und RNA-Isolierung
- Für jede unabhängige Transfektion Kultur der erforderlichen Anzahl von Zellen (wie von der MPRA Bibliothek Komplexität bestimmt, siehe Diskussion) in geeigneten Medium. Beispielsweise Kultur HEK293T / 17 Zellen in DMEM, ergänzt mit 10% FBS und L-Glutamin / Penicillin / Streptomycin. Kulturzellen von mindestens zwei unabhängigen Transfektionen für jede Bibliothek und experimentellen Bedingungen.
- Transfektion der kultivierten Zellen mit Plasmiden MPRA. Die Transfektion Verfahren und Bedingungen müssen für jeden Zelltyp optimiert. Für jede Probe transfiziert sind, behalten ein Aliquot (50-100 ng) der Plasmid-DNA als eine abgestimmte Steuerung.
- B. Transfektion von 0,5 x 10 7 HEK293T / 17-Zellen gezüchtet, um ~ 50% Konfluenz in einer 10 cm Kulturschale mit 10 ug Plasmid-DNA in 1 ml Opti-MEM I Reduzierte Serummedium unter Verwendung von 30 ul Lipofectamine LTX und 10 ul plus Reagenz. Entfernen Sie die Transfektion Mischung nach 5 Stunden und lassen Sie dasZellen für 24-48 Stunden zu erholen.
- Optional führen Sie keine Störung erforderlich, um kontextabhängige oder Signal regulatorischen Sequenzen in der Bibliothek ausgelegt aktivieren.
- Ernte der Zellen und Isolierung von Poly (A) + mRNA mit Standard-Oligo (dT) Cellulose-Säulen oder Kugeln mit Anweisungen des jeweiligen Herstellers.
- Sicherzustellen, dass die maximale Bindungskapazität der Säulen oder Beads die Gesamtmenge an mRNA aus den geernteten Zellen erwartet überschreiten. Zum Beispiel kann die erwartete Rendite aus dem Abschnitt 3.3 ist etwa 0,5-2,5 ug mRNA.
4. Tag-Seq
- Verschleppung von Vektor-DNA aus den transfizierten Zelllysaten zu beseitigen, behandeln jeweils 20 ul mRNA-Probe mit 1 ul Turbo DNase (2 U) und 2,3 ul 10x Turbo DNase-Puffer bei 37 ° C für 1 h, fügen Sie 2,4 ul Turbo DNase Inaktivierung Reagenz bei RT für 5 min Mischen, Zentrifugieren bei 10.000 g für 90 sec, und dann wird die Lösung in ein frisches Röhrchen.
- Überprüfen Reinheit durch eine PCR, wie in Abschnitt 4.6 auf 60-100 ng jedes mRNA Probe beschrieben, und dann läuft die Produkte auf einem Agarose-Gel. Wenn bestimmte Amplikons sind sichtbar (0,25 kb bei Verwendung pMPRA1 mit luc2), Spalte reinigen die mRNA behandelt und wiederholen Sie den DNase-Behandlung.
- Um Tag-Seq-Sequenzierung Bibliotheken generieren, konvertieren Reporter mRNA in cDNA und fügen Sequenzierung Adapter durch PCR.
- Einrichtung mRNA / RT-Primer Mischungen, wie in Tabelle 3 beschrieben. Inkubation bei 65 ° C für 5 min auf Eis zu stellen. Parallel dazu richten Sie cDNA-Synthese-Reaktionen, wie in Tabelle 4 beschrieben.
| Reagens | 1x Volume (ul) |
| mRNA Probe (400-700 ng Gesamt) | 8 |
| Oligo-0DT (50 uM) | 1 |
| dNTP (10 mM jeweils) | 1 |
| Reagens | 1x Volume (ul) |
| 10x Superscript III RT Buffer | 2 |
| MgCl 2 (25 mM) | 4 |
| DTT (0,1 M) | 2 |
| RNaseOut (40 U / ul) | 1 |
| Superscript III (200 U / ul) | 1 |
Tabelle 4. cDNA-Synthese Reaktionsmischung.
- Sanft kombinieren mRNA / RT-Primer vermischt sich mit der cDNA-Synthese Mischungen. Inkubieren bei 50 ° C für 50 min, 85 ° C für 5 min und dann auf Eis. Schließlich Inkubation mit 2 U von Ribonuclease H bei 37 ° C für 20 min.
- Bis PCR-Reaktionen wie in Tabelle 5 mit 4-6 ul beschriebencDNA Reaktionsmischung oder 50 ng Reporterplasmid als Vorlagen. Dann führen die PCR-Amplifikation (95 ° C für 2 min, 26 x [95 ° C für 30 sec, 55 ° C für 30 sec, 72 ° C für 30 sec], 72 ° C für 3 min).
| Reagens | 1x Volume (ul) |
| 2x PfuUltra II HotStart PCR Master Mix | 25 |
| Primer TagSeq_P1 (25 uM) | 0,5 |
| Primer TagSeq_P2 (25 uM) | 0,5 |
| Vorlage (mRNA, cDNA-Mix oder Plasmid-DNA) | variiert |
| Nuklease-freies Wasser | 50 |
Tabelle 5. Tag-Seq PCR-Reaktionsmischung.
- Führen Sie die PCR-Produkte über ein 2% Agarose-Gel, Verbrauch Bands, die den Tag-Seq Bibliothek Amplikons (0,25 kb bei VerwendungpMPRA1 mit luc2) und reinigen Sie diese mit Gel-Reinigung Spin-Säulen.
- Pool, denaturieren und Sequenz, die das gereinigte Tag-Seq Amplikons direkt mit einem Illumina-Sequenzierung Instrument.
- Filter mit geringer Qualität liest, indem alle, dass a) eine oder mehrere Position mit einem Phred Qualitätsfaktor von weniger als 30 innerhalb des sequenzierten Tag oder b) nicht genau einen Tag ausgelegt entsprechen. Zählen Sie die Anzahl der jeweils verbleibenden Tag in jeder Bibliothek erscheint. Normalisieren die Tag zählt, um TPM (Tags pro Million sequenziert Tags) und berechnen dann das Verhältnis der mRNA-Tag zählt über Plasmid-abgeleitete Tag zählt für jedes Paar von Sequenzierungsbibliotheken. Wenn mehrere verschiedene Tags wurden zu jedem Sequenzvariante verknüpft, nutzen ihre mittlere Verhältnisse für Downstream-Analyse.
Ergebnisse
MPRA ermöglicht hochauflösende, quantitative Zerlegung der Sequenz-Aktivitäts-Beziehungen von transkriptionalen regulatorischen Elemente. Eine erfolgreiche MPRA Experiment ergeben typischerweise hoch reproduzierbare Messungen für die Mehrzahl der Sequenzen in der Bibliothek transfiziert (3A). Wenn schlechte Reproduzierbarkeit beobachtet (3B), ist dies ein Hinweis auf eine zu niedrige Konzentration an Reporter-mRNAs in den gewonnenen RNA-Proben aufgrund entweder 1) geringe absolute Aktivität unter den Sequenzen untersucht, oder 2) geringe Transfektionseffizienz.
Figur 4 zeigt ein repräsentatives "Daten-Fußabdruck" 1,2 durch Bestimmung erzeugt ~ 37.000 zufällige Varianten eines 145 bp-Sequenz stromaufwärts des menschlichen IFNB Gens in HEK293-Zellen, die mit oder ohne Einwirkung von Sendai-Virus. Der Promotor TATA-Box und bekannt proximalen Enhancer 10 eindeutig als informationsreichen regi identifiziert werdenons in einem Virus-abhängige Weise.
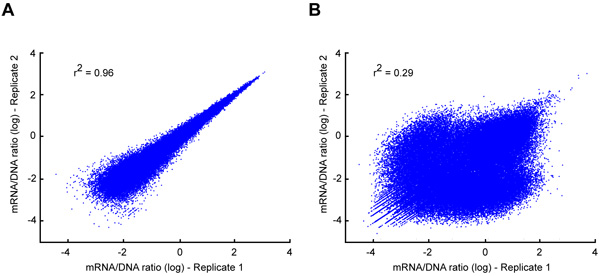
Abbildung 3. Tag-Seq Reproduzierbarkeit. Streudiagramme, die Beispiele von Tag-Seq-Daten aus zwei unabhängigen Transfektionen mit hoher Wiederholungs (A) und niedriger (B) Reproduzierbarkeit. Letztere Plot zeigt viele Ausreißer-Tags mit hoher mRNA zählt in nur einer der zwei Wiederholungen. Solche Artefakte typischerweise an, dass die Konzentrationen der Reporter-mRNAs zu niedrig für die quantitative PCR-Amplifikation entweder durch niedrige absolute Aktivitäten unter den Reporterkonstrukte oder niedrige Transfektionseffizienz.
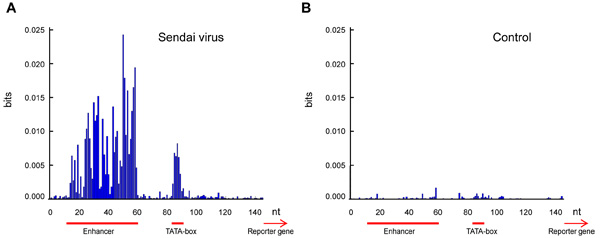
Abbildung 4. Information Footprinting des menschlichen IFNB Transkriptionsstartstelle und proximalen Enhancer. Etwa 37.000 zufällige Varianten einer 145 Nukleotid (nt)-Region stromaufwärts des menschlichen Gens wurden unter Verwendung IFNB MPRA in HEK293-Zellen, die mit (A) und ohne (B) Einwirkung von Sendai-Virus untersucht. Die blauen Balken zeigen die gegenseitige Information zwischen dem Ausgang und dem Reporter Nukleotid an jeder Position. Das proximale Enhancer und TATA-Box stehen als Regionen mit hoher Informationsgehalt auf Virusinfektion.
Diskussion
MPRA ist ein flexibles und leistungsfähiges Werkzeug zur Aufschlüsselung von Sequenz-Aktivitäts-Beziehungen in genregulatorischen Elementen. Der Erfolg von MPRA-Experimenten hängt von mindestens drei Faktoren ab: 1) sorgfältiges Design der Sequenzbibliothek, 2) Minimierung von Artefakten während der Amplifikation und Klonierung und 3) hohe Transfektionseffizienz.
Die möglichen Längen der variablen Regionen in den Reporterkonstrukten werden maßgeblich durch die verwendete Synthese- bzw. Klonierungstechnologie bestimmt. Standard-OLS ist im Allgemeinen auf etwa 200 nt begrenzt, aber dieses Protokoll ist mit Einfügungen bis zu mindestens 1.000 nt kompatibel. Beachten Sie, dass variable Regionen, die stark repetitiv sind oder starke Sekundärstrukturen enthalten, aufgrund von PCR- und Klonierungsverzerrungen unterrepräsentiert sein können. Die Länge der Markierungen, die jeden der variablen Bereiche identifizieren, sollte 10-20 nt betragen, und die Sammlung von Tags sollte idealerweise so gestaltet sein, dass es mindestens zwei Nukleotidunterschiede zwischen einem beliebigen Paar gibt. Markierungen, die die Seed-Sequenzen bekannter microRNA oder andere Faktoren enthalten, die die mRNA-Stabilität beeinflussen könnten, sollten nach Möglichkeit ebenfalls vermieden werden.
Ein Schlüsselparameter bei der Planung von MPRA-Experimenten ist die Gesamtzahl der unterschiedlichen Reporterkonstrukte, die in die Bibliothek aufgenommen werden sollen (die Designkomplexität, bezeichnet als CD). In der Praxis ist CD durch die Anzahl der kultivierten Zellen begrenzt, die transfiziert werden können. Als Faustregel gilt, dass die Gesamtzahl der transfizierten Zellen mindestens 50-100 Mal größer sein sollte als die von CD. Wenn beispielsweise 20 Millionen Zellen mit einer Transfektionseffizienz von 50 % transfiziert werden können, sollte CD nicht mehr als ~200.000 betragen. Beachten Sie, dass CD gleich der Anzahl der unterschiedlichen regulatorischen Sequenzvarianten multipliziert mit der Anzahl der unterschiedlichen Tags pro Sequenz ist. Je mehr unterschiedliche Tags mit jeder regulatorischen Sequenz verknüpft sind, desto genauer kann die Aktivität dieser Sequenz geschätzt werden (da Messungen von unterschiedlichen Tags gemittelt werden können), aber desto weniger unterschiedliche Varianten können in einem Experiment getestet werden. Die optimale Wahl hängt vom Versuchsdesign ab. In einem einfachen "Promotor-Bashing"-Experiment, bei dem ein mathematisches Modell an die aggregierten Messungen angepasst wird, ist in der Regel ein einziges Tag pro Variante ausreichend. In einem Screening auf Einzelnukleotid-Polymorphismen, die Veränderungen in den regulatorischen Aktivitäten verursachen, kann es erforderlich sein, 20 oder mehr Tags pro Allel zu verwenden, um statistisch robuste Ergebnisse zu erhalten, da der Vergleich jedes Allelpaares einen separaten Hypothesentest erfordert.
Wenn nicht davon auszugehen ist, dass die zu untersuchenden Sequenzen Transkriptionsstartstellen enthalten, kann auch ein konstanter Promotor im selben Fragment hinzugefügt werden. Zum Beispiel umfasst pMPRAdonor2 (Addgene ID 49353) einen minimalen TATA-Box-Promotor, der nützlich ist, wenn erwartet wird, dass die stromaufwärts liegende variable Region eine signifikante Enhanceraktivität aufweist, während pMPRAdonor3 (Addgene ID 49354) einen modifizierten, starken SV40-Viruspromotor enthält, der nützlich ist, wenn erwartet wird, dass die variable Region Schalldämpferaktivität oder andere negative regulatorische Elemente enthält.
Rohe OLS-Produkte enthalten oft einen signifikanten Anteil an verkürzten Oligonukleotiden. Diese können die genaue PCR-Amplifikation der designten Sequenzen beeinträchtigen, insbesondere wenn zwischen ihnen eine signifikante Homologie besteht. Die Verwendung der PAGE-Aufreinigung zur Entfernung verkürzter Syntheseprodukte und die Emulsions-PCR zur Minimierung von Amplifikationsartefakten sind wirksame Techniken zur Sicherstellung einer hohen Bibliotheksqualität. Wenn einer der beiden Schritte nicht praktikabel ist, ist es zwingend erforderlich, die Anzahl der PCR-Zyklen, die bei jedem Amplifikationsschritt verwendet werden, zu minimieren. Die Auswahl und Erweiterung der klonierten Bibliothek in der Flüssigkultur ist im Allgemeinen ausreichend, um die Komplexität des Designs aufrechtzuerhalten, aber wenn rekombinationsanfällige Vektoren verwendet werden sollen oder eine signifikante Repräsentationsverzerrung beobachtet wird, können die gewonnenen Zellen stattdessen direkt auf große LB-Agarplatten plattiert, als einzelne Kolonien expandiert und dann für die DNA-Isolierung abgeschabt werden. Es ist auch wichtig, die potenziellen Auswirkungen von Synthesefehlern zu berücksichtigen, die typischerweise bei einer Rate von 1:100-500 bei OLS auftreten. Es wird empfohlen, die Reporterkonstrukte vor der Transfektion in voller Länge zu sequenzieren, um solche Fehler zu identifizieren und zu korrigieren.
Es ist nicht notwendig, Reporterkonstrukte in jede Zelle in der transfizierten Kultur einzuführen, aber Transfektionseffizienzen unter ~50% können zu schlechten Signal-Rausch-Verhältnissen führen. Es ist ratsam, die Transfektionsbedingungen zu optimieren, bevor MPRA-Experimente in einem neuen Zelltyp durchgeführt werden. Bei der Arbeit mit schwer zu transfizierenden Zelltypen können MPRA-Signale durch Vorselektion transfizierter Zellen verstärkt werden. Die pMPRA-Vektorreihe umfasst Varianten, die konstitutiv einen verkürzten Zelloberflächenmarker exprimieren, der zur physikalischen Anreicherung von transfizierten Zellen vor der RNA-Isolierung verwendet werden kann (z. B. Addgene IDs 49350 und 49351).
Offenlegungen
Die Autoren erklären, dass sie keine finanziellen Interessen konkurrieren.
Danksagungen
Diese Arbeit wurde von der National Human Genome Research Institute der National Institutes of Health unter Preis Anzahl R01HG006785 unterstützt.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| Synthese von Oligonukleotidbibliotheken | Agilent, CustomArray oder andere OLS-Anbieter | kundenspezifisch | Bei Verwendung der OLS-Konstruktionsmethode |
| pMPRA1 | Addgene | 49349 | MPRA Plasmid Rückgrat |
| pMPRAdonor1 | Addgene | 49352 | luc2 ORF Donor |
| Plasmid TE 0,1 Puffer (10 mM Tris-HCl, 0,1 mM EDTA, pH 8,0) | Generisch | n/a | OLS Puffer |
| Novex TBE-Harnstoff-Gele, 10% | Life Technologies | EC6875BOX PAGE-Aufreinigung | von OLS-Produkten |
| Novex TBA-Harnstoff-Probenpuffer | Life Technologies | LC6876 | PAGE-Aufreinigung von OLS-Produkten |
| SYBR Gold Nukleinsäure-Gel Stain | Life Technologies | S-11494 | PAGE-Aufreinigung von OLS-Produkten |
| Micellula DNA-Emulsion & Aufreinigungskit | EURx/CHIMERx | 3600-01 | Bibliotheksamplifikation durch Emulsions-PCR |
| Herculase II Fusion DNA-Polymerase | Agilent | 600675 | Polymerase für Emulsions-PCR |
| SfiI | New England Biolabs | R0123S | Bibliotheksklonierung mit pMPRA-Vektoren |
| KpnI-HF | New England Biolabs | R3142S | Bibliotheksklonierung mit pMPRA-Vektoren |
| XbaI | Neu England Biolabs | R0145S Klonierung | der Bibliothek mit pMPRA-Vektoren |
| T4-DNA-Ligase (2.000.000 Einheiten/ml) | New England Biolabs | M0202T | Klonierung der Bibliothek mit pMPRA-Vektoren |
| One Shot TOP10 Electrocomp E. coliLife | Technologies | C4040-50 | Klonierung der Bibliothek mit pMPRA-Vektoren |
| LB-Agar und flüssigen Medien mit Carbenicllin | Generisches | n/a | Wachstumsmedien für Klonierung |
| von E-Gel EX Gelen 1% | Life Technologies | G4010-01 | Verifizierung und Aufreinigung von Bibliotheken |
| E-Gel EX Gele, 2% | Life Technologies | G4010-02 | Verifizierung und Aufreinigung von Bibliotheken |
| MinElute Gel Extraction Kit | Qiagen | 28604 | Aufreinigung von Bibliotheken und Rückgraten |
| EndoFree Plasmid Maxi Kit | Qiagen | 12362 | Bibliothek DNA-Isolierung |
| Zellkulturmedien | n/a | n/a | Experimentspezifische |
| Transfektionsreagenzien | n/a | n/a | Experimentspezifisches |
| MicroPoly(A)Purist Kit | Life Technologies | AM1919 | mRNA-Isolierung |
| TURBO DNA-freies Kit | Life Technologies | AM1907 | Plasmid-DNA-Entfernung |
| SuperScript III Erststrangsynthese | Systemlebensdauer Technologien | 18080-051 | cDNA-Synthese |
| PfuUltra II Hotstart PCR Master | Mix Agilent | 600850 | Polymerase für Tag-Seq |
| PCR Primer (siehe Text) | IDT | custom | PAGE purify Tag-Seq Primer |
Referenzen
- Kinney, J., Murugan, A., Callan, C. G., Cox, E. C. Using deep sequencing to characterize the biophysical mechanism of a transcriptional regulatory sequence. Proceedings of the National Academy of Sciences USA. 107 (20), 9158-9163 (2010).
- Melnikov, A., et al. Systematic dissection and optimization of inducible enhancers in human cells using a massively parallel reporter assay. Nature Biotechnology. 30 (3), 271-277 (2012).
- Patwardhan, R. P., Lee, C., Litvin, O., Young, D. L., Pe’er, D., Shendure, J. High-resolution analysis of DNA regulatory elements by synthetic saturation mutagenesis. Nature Biotechnology. 27 (12), 1173-1175 (2009).
- Patwardhan, R. P., et al. Massively parallel functional dissection of mammalian enhancers in vivo. Nature Biotechnology. 30 (3), 265-270 (2012).
- Arnold, C. D., Gerlach, D., Stelzer, C., Boryń, ŁM., Rath, M., Stark, A. Genome-wide quantitative enhancer activity maps identified by STARR-seq. Science (New York, N. Y.). 339 (6123), 1074-1077 (2013).
- Kheradpour, P., et al. Systematic dissection of regulatory motifs in 2000 predicted human enhancers using a massively parallel reporter assay. Genome Research. 23 (5), 800-811 (2013).
- White, M. A., Myers, C. A., Corbo, J. C., Cohen, B. A. Massively parallel in vivo enhancer assay reveals that highly local features determine the cis -regulatory function of ChIP-seq peaks. Proceedings of the National Academy of Sciences USA. 110 (29), 11952-11957 (2013).
- Mogno, I., Kwasnieski, J. C., Cohen, B. A. Massively parallel synthetic promoter assays reveal the in vivo effects of binding site variants. Genome Research. 23 (11), 1908-1915 (2013).
- Schütze, T., et al. A streamlined protocol for emulsion polymerase chain reaction and subsequent purification. Analytical Biochemistry. 410 (1), 155-157 (2011).
- Panne, D., Maniatis, T., Harrison, S. C. An atomic model of the interferon-beta enhanceosome. Cell. 129 (6), 1111-1123 (2007).
Nachdrucke und Genehmigungen
Erratum
Formal Correction: Erratum: Massively Parallel Reporter Assays in Cultured Mammalian Cells
Posted by JoVE Editors on 3/01/2015. Citeable Link.
null
Weitere Artikel entdecken
