El ensayo del reportero genético es una herramienta bien establecida y poderosa para diseccionar la relación entre las secuencias de ADN y sus actividades reguladoras de genes. El acoplamiento de los elementos reguladores candidatos a genes reporteros que llevan etiquetas de secuencia identificativa permite la paralelización masiva de estos ensayos.
Artículo de método
Ensayos Reporteros Massively Parallel en células de mamífero cultivadas
En este artículo
Aviso de erratum
Important: There has been an erratum issued for this article. View Erratum Notice
Resumen
Resumen
El ensayo del reportero genético es una herramienta bien establecida y poderosa para diseccionar la relación entre las secuencias de ADN y sus actividades reguladoras de genes. Sin embargo, el rendimiento potencial de este ensayo se ha visto limitado por la necesidad de clonar y ensayar individualmente la actividad de cada secuencia en interés utilizando la fluorescencia de proteínas o la actividad enzimática como proxy de la actividad reguladora. Los avances en las tecnologías de secuenciación y síntesis de ADN de alto rendimiento han permitido recientemente superar estas limitaciones mediante la multiplexación de la construcción y la interrogación de grandes bibliotecas de constructos de reporteros. Este protocolo describe la implementación de un ensayo reportero masivamente paralelo (MPRA) que permite la comparación directa de cientos de miles de secuencias reguladoras putativas en una sola placa de cultivo celular.
Introducción
Ensayos Reporteros Massively Parallel (MPRA) permiten medir multiplexado de las actividades reguladoras de la transcripción de miles a cientos de miles de secuencias de ADN 1-7. En su aplicación más común, la multiplexación se logra mediante el acoplamiento de cada secuencia de interés a un gen indicador sintético que contiene una identificación de etiqueta de secuencia aguas abajo de un marco de lectura abierto (ORF; Figura 1). Después de la transfección, el aislamiento de ARN y secuenciación profunda de los extremos 3 'de los transcritos del gen reportero, las actividades relativas de las secuencias unidas se pueden deducir de la abundancia relativa de sus etiquetas de identificación.

Figura 1 Descripción general de MPRA. Una biblioteca de reportero MPRA construcciones se construye acoplando secuencias reguladoras putativas a sintéticogenes indicadores que consisten en un "inerte" ORF (como GFP o luciferasa), seguido de una identificación de marcadores de secuencias. La biblioteca es transfectada en masa en una población de células cultivadas y ARNm transcrito reportero se recupera posteriormente. Secuenciación de profundidad se utiliza para contar el número de ocurrencias de cada etiqueta entre los mRNAs reportero y los plásmidos transfectados. La proporción de mRNA cuenta sobre los recuentos de plásmido puede utilizarse para inferir la actividad de la secuencia reguladora correspondiente. Adaptado con permiso de Melnikov, et al 2.
MPRA se puede adaptar a una amplia variedad de diseños experimentales, incluyendo 1) la mutagénesis integral de elementos reguladores de genes individuales, 2) la exploración de nuevos elementos reguladores a través de un locus de interés, 3) probar el efecto de la variación genética natural en un conjunto de putativo promotores, potenciadores o silenciadores, y 4) ingeniería semi-racional de los elementos reguladores sintéticos. Libraries de variantes de secuencia pueden generarse usando una variedad de métodos, incluyendo la síntesis de la biblioteca de oligonucleótidos (OLS) en microarrays programables 2,3,6,7, conjunto de oligonucleótidos degenerados, 1,4 ligadura 8 combinatoria y la fragmentación de ADN genómico 5.
Este protocolo describe la construcción de una biblioteca de variantes de promotor usando OLS y los vectores de pMPRA1 y pMPRAdonor1 (Addgene IDs 49349 y 49352, respectivamente; http://www.addgene.org), la transfección transitoria de esta biblioteca en células de mamífero cultivadas y la posterior cuantificación de las actividades promotoras de secuenciación profunda de sus etiquetas asociadas (Tag-Seq). Las versiones anteriores de este protocolo se utilizaron en la investigación publicada en Melnikov et al. Nature Biotechnology 30, 271-277 (2012) y en Kheradpour et al. Genome Research 23, 800-811 (2013).
Protocolo
1. Secuencia Diseño y Síntesis
- Comience MPRA con el diseño y la síntesis de secuencias a ensayar para la actividad reguladora. Para la compatibilidad con la serie de vectores pMPRA, diseñar cada secuencia utilizando la siguiente plantilla: 5'-ACTGGCCGCTTCACTG- var -GGTACCTCTAGA- etiqueta -AGATCGGAAGAGCGTCG-3 ', donde var indica la secuencia a ensayar y la etiqueta indica una o más etiquetas de identificación.
- Las dos regiones variables (var) y la etiqueta están separadas por un par de KpnI (GGTACC) y XbaI (TCTAGA) sitios de restricción para facilitar la ligadura direccional de un fragmento de gen reportero entre ellos. Además, dos sitios distintos SfiI (GGCCNNNNNGGCC) se añadirán por PCR para permitir la ligación direccional en la columna vertebral pMPRA. Las regiones variables no deben contener copias adicionales de cualquiera de estos sitios de restricción. Si es necesario, uno o más de estas enzimas de restricción se pueden sustituir, Siempre y cuando las sustituciones 1) permitir un corte eficaz cerca de los extremos de moléculas de ADN, y 2) no corte en otra parte de la secuencia del vector. Ver discusión para más detalles.
- Obtener los cebadores necesarios listados en la Tabla 1 de un proveedor comercial.
| MPRA_SfiI_F | GCTAAGGGCCTAACTGGCCGCTTCACTG |
| MPRA_SfiI_R | GTTTAAGGCCTCCGTGGCCGACGCTCTTC |
| TAGseq_P1 | AATGATACGGCGACCACCGAGATCTACACT CTTTCCCTACACGACGCTCTTCCGATCT |
| TAGseq_P2 | CAAGCAGAAGACGGCATACGAGAT [índice] GT GACTGGAGTTCAGACGTGTGCTCTTCCGATCTCGAGG |
Tabla 1. Primer secuencias. [Indice] denota una secuencia de índice de 6 a 8 nt utilizado para la secuenciación de multiplexado. Obtener al menos 8 cebadores TagSeq-P2 con diferentes índices. Todosde los cebadores debe ser purificado por HPLC o PAGE.
- Bibliotecas de oligonucleótidos pueden obtenerse a partir de una instalación de proveedor o núcleo comercial, o se generan utilizando un microarray basado programable sintetizador de oligonucleótidos como se describe por el fabricante. Resuspender los productos MCO en 100 l de tampón TE 0,1.
- Ejecute las bibliotecas de oligonucleótidos en un 10% TBE-Urea desnaturalización gel de poliacrilamida. Cargar aproximadamente 1 pmol por carril y tinción con colorante fluorescente sensible a ssDNA para evaluar su calidad (Figura 2A).
- Si una banda discreta correspondiente a los oligonucleótidos de longitud completa se puede visualizar (Figura 2A, carriles 1 y 2), escindir el correspondiente trozo de gel de acrilamida y se eluye oligonucleótidos en 100 l TE 0,1 durante la noche a temperatura ambiente con agitación. De lo contrario, continúe con el OLS suspensión cruda.
- Potenciar y colas SfiI a la biblioteca de oligonucleótidos utilizando emulsión PCR 9 sup>.
- Establecer 50 l mezclas de reacción PCR como se describe en la Tabla 2. Luego combine con 300 l de aceite y surfactante mezcla desde el Micellula ADN Emulsión y kit de purificación y agitar durante 5 min a 4 ° C.
| Reactivo | 1x Volumen (l) |
| Herculase II Fusión ADN polimerasa | 0,5 |
| Reaction Buffer 5x Herculase II | 10 |
| dNTP (10 mM cada uno) | 1.25 |
| BSA (20 mg / ml) | 1.25 |
| MPRA_SfiI_F Primer (25 mM) | 0.25 |
| MPRA_SfiI_R Primer (25 mM) | 0.25 |
| Plantilla OLS (1-10 attomol) | varía |
| Agua libre de nucleasa | a 50 |
- Utilizar la concentración que da el máximo rendimiento de los productos de amplificación sin la aparición de artefactos (véase la sección 1.12).
- Prescindir de la emulsión resultante en tubos de PCR y realice 20 ciclos de PCR (2 min a 95 ° C, 20 x [20 segundos a 95 ° C, 20 segundos a 55 ° C, 30 segundos a 72 ° C], 3 min a 95 ° C).
- Piscina y romper cada 350 l de reacción de PCR en emulsión mediante la adición de 1 ml de isobutanol y brevemente vórtex, y luego purificar el producto de amplificación usando una columna de purificación de ADN.
- Ejecutar una alícuota en un gel de agarosa al 2% o 4% para verificar la amplificación libre de artefactos (Figura 2B).

Figura 2 Preparación de bibliotecas de síntesis de oligonucleótidos. A) Tres bibliotecas de síntesis de oligonucleótidos primas diferentes (MCO) se ejecutan en la desnaturalización de 10% TBE-urea geles de poliacrilamida. Las bandas correspondientes a los oligonucleótidos de longitud completa (*) se pueden visualizar y extirpados de bibliotecas 1 y 2 Biblioteca 3 contiene contaminantes que interfieren con la purificación PAGE. Si este es el caso, proceder directamente a la PCR de amplificación. B) los productos de amplificación por PCR abierto y emulsión de la misma corrida biblioteca de oligonucleótidos en un gel de agarosa. La amplificación por PCR de las bibliotecas de oligonucleótidos complejos con frecuencia crea productos quiméricos y otros artefactos que pueden aparecer como bandas superiores e inferiores. Emulsión PCR puede minimizar estos artefactos.
2. Construcción de la Biblioteca
- Preparar un plásmido linealizado por digestión de columna vertebral pMPRA1 vector con SfiI a 50 ° C durante 2 horas, se ejecutan en un gel de agarosa al 1%, escindir la banda columna vertebral (en este caso, 2,5 kb) y purificar usando una columna de centrifugación purificación en gel.
- Recopilaciónlos productos de la PCR de emulsión de la etapa 1.4 con SfiI a 50 ° C durante 2 horas y purifican utilizando columnas de purificación de ADN.
- Para ligar la biblioteca promotor-tag en el esqueleto del vector linealizado, configurar las reacciones que contenían 100 ng del producto de PCR digerido, 50 ng de esqueleto del vector linealizado y ADN ligasa de T4. Incubar toda la noche a 16 ° C y luego se calienta a 65 ° C durante 20 min para inactivar la ligasa.
- Transformar E. coli con la reacción de ligación. Para preservar la complejidad de la biblioteca, el objetivo de obtener al menos 10 veces más ufc que hay combinaciones de promotor-etiquetas distintas en la biblioteca diseñada.
- Cuando el número total de etiquetas es de aproximadamente 100.000, el ufc objetivo típicamente se puede lograr mediante la realización de 6-8 transformaciones paralelas por biblioteca.
- Para cada transformación, se combinan 50 l electrocompetentes E. células de E. coli con 2 l de mezcla de ligación en hielo. Transformar mediante electroporación, recuperar las células en 800 l SOCmedio por agitación a 37 ° C durante 1 h, y luego se combinan células de las transformaciones paralelas.
- Para evaluar la eficiencia de transformación, placa diluciones seriadas de un alinquot de células recuperadas en placas de agar LB con 50 a 100 mg / ml de carbenicilina y se incuba durante la noche a 37 ° C. Estimar ufc total, (cfu observado) x (factor de dilución) x (V - V) / V, donde V es el volumen total de células recuperadas y V es el volumen de la alícuota tomada para las diluciones en serie.
- Al mismo tiempo, utilizar el resto de las células recuperadas para inocular 200 ml de LB suplementado con 100 mg / ml de carbenicilina. Se cultivan las células a 37 ° C durante la noche en una incubadora con agitador y luego aislar el ADN plásmido siguiendo los procedimientos estándar.
- Digerir una alícuota de la biblioteca de plásmido aislado con SfiI a 50 ° C durante 2 horas y correr en un gel de agarosa al 1% para confirmar la presencia de insertos.
- Linealizar el plásmido biblioteca por cutting entre las variantes promotoras y etiquetas utilizando KpnI y XbaI. Para maximizar la eficiencia de la digestión, realizar digestiones de serie:
- En primer lugar, digerir con KpnI a 37 ° C durante 1 hora y purificar usando perlas magnéticas. En segundo lugar, digerir con XbaI con la adición de 1 U de fosfatasa alcalina de camarón a 37 ° C durante 2 h, el calor inactiva a 65 ° C durante 5 min, y luego se purifica usando perlas magnéticas.
- Ejecutar una alícuota en un gel de agarosa al 1% para verificar la linealización completa. Si plásmido sin cortar es visible, el fragmento linealizado se purificó en gel debe ser.
- Para generar una biblioteca de MPRA adecuados para la transfección en células de mamífero, ligar un ORF con KpnI / XbaI extremos -Compatible en la biblioteca intermedia linealizado.
- Para preparar un fragmento ORF luc2 compatible desde pMPRAdonor1, digerir este plásmido con KpnI y XbaI a 37 ° C durante 1 hora y se ejecutan en un gel de agarosa al 1%. Cortar el fragmento ORF (1,7 kb en este caso) y se purifican usando una columna de gel de purificación de giro.
- Clonar el fragmento ORF en la biblioteca intermedio linealizado como se describe en los pasos 2.3 a 2.8.
- Digerir una parte alícuota (correspondiente a 1-2 g) de la biblioteca MPRA con KpnI a 37 ° C durante 1 hora y correr en un gel de agarosa al 1%. Si la biblioteca digerido se ejecuta como una sola banda, pase a la sección 3 Si se observan bandas adicionales (por lo general corresponde a remanente de construcciones intermedias), la biblioteca puede ser purificado de la siguiente manera:
- Digerir 3-5 g de la biblioteca contaminada con KpnI a 37 ° C durante 1 hora y correr en un gel de agarosa al 0,8% durante la noche a 4 ° C.
- Escindir la banda biblioteca correcta, purificar el ADN usando una columna de centrifugación purificación en gel y llevar a cabo la auto-ligación utilizando alta concentración de ADN ligasa de T4 a 37 ° C durante 1 hr. A continuación, repita la transformación y la biblioteca definitiva de aislamiento de ADN como se describe en el paso 2.8.
3. Transfection, Perturbación, y Aislamiento de ARN
- Para cada transfección independiente, la cultura el número requerido de células (como se determina por la complejidad de la biblioteca MPRA, ver Discusión) en un medio apropiado. Por ejemplo, cultivo de células HEK293T 17 / en DMEM suplementado con 10% de FBS y L-glutamina / penicilina / estreptomicina. Células de cultivo de al menos dos transfecciones independientes para cada biblioteca y condición experimental.
- Transfectar las células cultivadas con plásmidos MPRA. El método y las condiciones de transfección debe ser optimizado para cada tipo de célula. Para cada muestra transfectadas, retener una parte alícuota (50-100 ng) de ADN plásmido como control emparejado.
- Por ejemplo, transfectar 0,5 x 10 7 HEK293T / 17 células cultivadas a ~ 50% de confluencia en una placa de cultivo de 10 cm con el plásmido de ADN 10 mg en 1 ml de Opti-MEM I medio de suero reducido utilizando 30 l Lipofectamine LTX y 10 l de reactivo Plus. Retire la mezcla de transfección después de 5 horas y permitir lalas células se recuperen durante 24-48 h.
- Opcionalmente, realice cualquier perturbación necesaria para activar secuencias reguladoras al contexto o dependientes de señales en la biblioteca diseñada.
- Recoger las células y aislar poli (A) + mRNA utilizando columnas estándar oligo (dT) celulosa o perlas usando las instrucciones de su fabricante.
- Asegúrese de que la capacidad máxima de unión de las columnas o los granos supere el importe total de ARNm que se espera de las células recogidas. Por ejemplo, el rendimiento esperado de la sección 3.3 es de aproximadamente 0,5-2,5 mg ARNm.
4. Tag-Seq
- Para eliminar el arrastre de ADN del vector de los lisados de células transfectadas, tratar a cada muestra de ARNm 20 l con 1 l Turbo DNasa (2 U) y 2,3 l de tampón 10x Turbo DNasa a 37 ° C durante 1 hora, añadir 2,4 l Turbo DNasa inactivación reactivo en RT durante 5 min con mezcla, centrifugar a 10.000 g durante 90 seg, y luego transferir la solución a un tubo nuevo.
- Compruebe pureza mediante la realización de PCR como se describe en la sección 4.6 de 60-100 ng de cada muestra de ARNm, y luego ejecutar los productos en un gel de agarosa. Si amplicones específicos son visibles (0,25 kb si usa pMPRA1 con luc2), la columna de purificar el mRNA tratado y luego repetir el tratamiento DNasa.
- Para generar bibliotecas de secuenciación-Tag Seq, convertir reportero ARNm en ADNc y añadir adaptadores de secuenciación por PCR.
- Configurar mezclas de cebadores ARNm / RT como se describe en la Tabla 3. Incubar a 65 ° C durante 5 min, luego colocar en hielo. En paralelo, configurar las reacciones de síntesis de ADNc como se describe en la Tabla 4.
| Reactivo | 1x Volumen (l) |
| muestra de ARNm (400-700 ng total) | 8 |
| Oligo-0DT (50 M) | 1 |
| dNTP (10 mM cada uno) | 1 |
| Reactivo | 1x Volumen (l) |
| 10x superíndice III RT Buffer | 2 |
| MgCl2 (25 mM) | 4 |
| DTT (0,1 M) | 2 |
| RNaseOUT (40 U / l) | 1 |
| Superíndice III (200 U / l) | 1 |
Tabla ADNc 4. mezcla de reacción de síntesis.
- Combinan suavemente imprimación mRNA / RT mezcla con mezclas de síntesis de ADNc. Incubar a 50 ° C durante 50 min, 85 ° C durante 5 min y luego se coloca en hielo. Finalmente, se incuba con 2 U de ribonucleasa H a 37 ° C durante 20 min.
- Configurar las reacciones de PCR como se describe en la Tabla 5 con 4-6 lcDNA mezcla de reacción o 50 ng de plásmido reportero como plantillas. A continuación, realizar la amplificación por PCR (95 ° C durante 2 min, 26 x [95 ° C durante 30 segundos, 55 ° C durante 30 segundos, 72 ° C durante 30 seg], 72 ° C durante 3 min).
| Reactivo | 1x Volumen (l) |
| 2x PfuUltra II HotStart PCR Master Mix | 25 |
| TagSeq_P1 Primer (25 mM) | 0,5 |
| TagSeq_P2 Primer (25 mM) | 0,5 |
| Plantilla (ARNm, ADNc o ADN plásmido mix) | varía |
| Agua libre de nucleasa | a 50 |
Tabla 5. mezcla de reacción de PCR Tag-Seq.
- Ejecutar los productos de PCR en un gel de agarosa al 2%, bandas especiales correspondientes a los amplicones biblioteca-Tag Sec (0,25 kb si se utilizapMPRA1 con luc2) y purificar estas utilizando columnas giratorias de purificación de gel.
- Piscina, desnaturalizar y secuenciar los amplicones-Tag Sec purificados directamente con un instrumento de secuenciación de Illumina.
- Filtro de baja calidad se lee mediante la eliminación de todo lo que a) contener una o más posiciones con una calidad Phred puntuación de menos de 30 dentro de la etiqueta secuenciado o b) que no coincide exactamente una etiqueta diseñada. Cuente el número de veces que cada etiqueta restante aparece en cada biblioteca. Normalizar la etiqueta cuenta con TPM (etiquetas por millón de etiquetas secuenciados) y luego calcular la relación de etiqueta cuenta derivados de ARNm más de etiqueta cuenta plásmido derivado para cada par de bibliotecas de secuenciación. Si varias etiquetas diferentes estaban vinculados a cada variante de secuencia, utilice sus ratios de la mediana para el análisis de aguas abajo.
Resultados
MPRA facilita de alta resolución, la disección cuantitativa de las relaciones de secuencia de la actividad de elementos reguladores transcripcionales. Un experimento exitoso MPRA típicamente producirá mediciones altamente reproducibles para la mayoría de las secuencias en la biblioteca transfectadas (Figura 3A). Si se observa una mala reproducibilidad (Figura 3B), esto es indicativo de una concentración demasiado baja de mRNAs reportero en las muestras de ARN recuperado, ya sea debido a 1) una baja actividad absoluta entre las secuencias ensayadas, o 2) la baja eficiencia de transfección.
La figura 4 muestra un representante "información de la huella" 1,2 generada por el ensayo de ~ 37.000 variantes aleatorias de una secuencia de 145 pb aguas arriba del gen IFNB humano en células HEK293 con o sin exposición al virus Sendai. El promotor TATA-box y conocido promotor de proximal 10 pueden ser claramente identificados como regi rico en informacióncomplementos de una manera dependiente de virus.
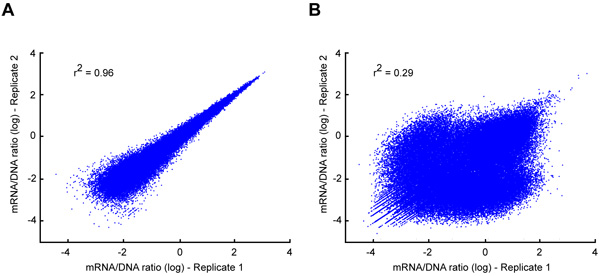
Figura 3.-Tag Sec reproducibilidad diagramas de dispersión que muestran ejemplos de datos de la etiqueta de la Seq dos transfecciones independientes replicadas con alta (A) y baja (B) la reproducibilidad.. Este último gráfico muestra muchas etiquetas de valores atípicos con recuentos de alta mRNA en sólo una de las dos repeticiones. Tales artefactos típicamente indican que las concentraciones de ARNm reportero eran demasiado bajos para la amplificación de PCR cuantitativa, ya sea debido a las actividades absolutas bajas entre los constructos informadores, o bajas eficiencias de transfección.
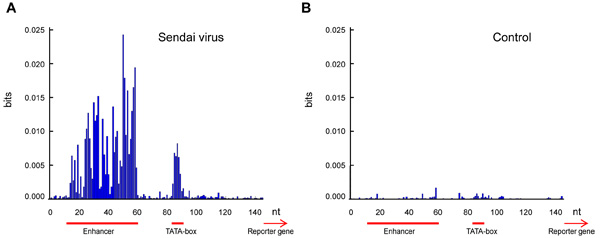
Figura 4. Información footprinting del sitio de inicio de transcripción IFNB humano y potenciador proximal. Aproximadamente 37.000 variantes aleatorias de un (nt) región de 145 nucleótidos aguas arriba del gen IFNB humano se analizaron utilizando MPRA en células HEK293 con (A) y sin (B) la exposición al virus Sendai. Las barras azules muestran la información mutua entre la salida reportero y el nucleótido en cada posición. El potenciador proximal y la caja TATA se destacan como las regiones de alto contenido de información a la infección viral.
Discusión
MPRA es una herramienta flexible y poderosa para la disección de las relaciones secuencia-actividad en elementos reguladores de genes. El éxito de los experimentos MPRA depende de al menos tres factores: 1) diseño cuidadoso de la biblioteca de secuencias, 2) minimización de artefactos durante la amplificación y clonación, y 3) alta eficiencia de transfección.
Las posibles longitudes de las regiones variables en las construcciones de reporteros están determinadas en gran medida por la tecnología de síntesis o clonación utilizada. El OLS estándar generalmente está limitado a unos 200 nt, pero este protocolo es compatible con insertos de hasta al menos 1.000 nt. Tenga en cuenta que las regiones variables que son altamente repetitivas o contienen estructuras secundarias fuertes pueden terminar subrepresentadas debido a los sesgos de PCR y clonación. La longitud de las etiquetas que identifican cada una de las regiones variables debe ser de 10-20 nt y la colección de etiquetas idealmente debe diseñarse de tal manera que haya al menos dos diferencias de nucleótidos entre cualquier par. Las etiquetas que contienen las secuencias de semillas de microARN conocido u otros factores que podrían influir en la estabilidad del ARNm también deben evitarse cuando sea posible.
Un parámetro clave en el diseño de experimentos MPRA es el número total de construcciones reporteras distintas que se incluirán en la biblioteca (la complejidad del diseño, denotada CD). En la práctica, la C D está limitada por el número de células cultivadas que se pueden transfectar. Como regla general, el número total de células transfectadas debe ser al menos 50-100 veces mayor que CD. Por ejemplo, si se pueden transfectar 20 millones de células con una eficiencia de transfección del 50%, entonces CD no debería ser más de ~ 200,000. Tenga en cuenta que CD es igual al número de variantes de secuencia reguladora distintas multiplicado por el número de etiquetas distintas por secuencia. Cuantas más etiquetas distintas estén vinculadas a cada secuencia reguladora, más precisa será la estimación de la actividad de esa secuencia (porque se pueden promediar las mediciones de etiquetas distintas), pero menos variantes distintas se pueden analizar en un experimento. La elección óptima depende del diseño experimental. En un experimento simple de "ataque al promotor", donde se ajustará un modelo matemático a las mediciones agregadas, una sola etiqueta por variante suele ser suficiente. En una detección de polimorfismos de un solo nucleótido que causan cambios en las actividades reguladoras, puede ser necesario usar 20 o más etiquetas por alelo para obtener resultados estadísticamente sólidos, porque la comparación de cada par de alelos requiere una prueba de hipótesis separada.
Si no se espera que las secuencias a ensayar contengan sitios de inicio de transcripción, también se puede agregar un promotor constante en el mismo fragmento. Por ejemplo, pMPRAdonor2 (Addgene ID 49353) incluye un promotor TATA-box mínimo que es útil cuando se espera que la región variable aguas arriba tenga una actividad potenciadora significativa, mientras que pMPRAdonor3 (Addgene ID 49354) incluye un promotor viral SV40 fuerte y modificado que es útil cuando se espera que la región variable contenga actividad silenciadora u otros elementos reguladores negativos.
Los productos OLS crudos a menudo contienen una fracción significativa de oligonucleótidos truncados. Estos pueden interferir con la amplificación precisa por PCR de las secuencias diseñadas, particularmente cuando existe una homología significativa entre ellas. El uso de la purificación PAGE para eliminar los productos de síntesis truncados y la PCR en emulsión para minimizar los artefactos de amplificación son técnicas eficaces para garantizar una alta calidad de la biblioteca. Si cualquiera de los pasos no es práctico, es imperativo minimizar el número de ciclos de PCR utilizados en cada paso de amplificación. La selección y expansión de la biblioteca clonada en cultivo líquido es generalmente suficiente para mantener la complejidad del diseño, pero si se van a utilizar vectores propensos a la recombinación o se observa un sesgo de representación significativo, las células recuperadas pueden sembrarse directamente en grandes placas de agar LB, expandirse como colonias individuales y luego rasparse para aislar el ADN. También es importante considerar el impacto potencial de los errores de síntesis, que generalmente se encuentran a una velocidad de 1: 100-500 en OLS. Se recomienda la secuenciación completa de las construcciones reporteras antes de la transfección para identificar y corregir dichos errores.
No es necesario introducir construcciones indicadoras en cada célula del cultivo transfectado, pero las eficiencias de transfección por debajo de ~ 50% pueden conducir a una mala relación señal/ruido. Es aconsejable optimizar las condiciones de transfección antes de realizar experimentos MPRA en un nuevo tipo de célula. Cuando se trabaja con tipos de células difíciles de transfectar, las señales MPRA se pueden aumentar mediante la preselección de células transfectadas. La serie de vectores pMPRA incluye variantes que expresan constitutivamente un marcador de superficie celular truncada que se puede usar para enriquecer físicamente las células transfectadas antes del aislamiento de ARN (por ejemplo, Addgene ID 49350 y 49351).
Divulgaciones
Los autores declaran que no tienen intereses financieros en competencia.
Agradecimientos
Este trabajo fue apoyado por el Instituto Nacional de Investigación del Genoma Humano de los Institutos Nacionales de la Salud bajo el número Premio R01HG006785.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| Síntesis de bibliotecas de oligonucleótidos | Agilent, CustomArray u otros proveedores de OLS | personalizado | Si se utiliza el método de construcción OLS |
| pMPRA1 | Addgene | 49349 | MPRA plásmido backbone |
| pMPRAdonor1 | Addgene | 49352 | luc2 Plásmido donante de ORF Tampón |
| TE 0.1 (10 mM Tris-HCl, 0.1 mM EDTA, pH 8.0) | Genérico | n/a | Tampón OLS |
| Novex TBE-Geles de urea, 10% | Life Technologies | EC6875BOX | PAGE purificación de productos OLS |
| Novex TBA-Urea Sample Buffer | Life Technologies | LC6876 | PAGE purificación de productos OLS |
| SYBR Gold Nucleic Acid Gel Stain | Life Technologies | S-11494 | PAGE purificación de productos OLS |
| Emulsión de ADN de micelula & Kit de purificación | EURx/CHIMERx | 3600-01 | Amplificación de bibliotecas por emulsión PCR |
| Herculasa II ADN polimerasa de fusión | Agilent | 600675 | Polimerasa para emulsión PCR |
| SfiI | New England Biolabs | R0123S | Clonación de bibliotecas con vectores pMPRA |
| KpnI-HF | New England Biolabs | R3142S | Clonación de bibliotecas con vectores pMPRA |
| XbaI | Nuevo Clonación de | R0145S | con vectores pMPRA |
| ligasa T4 (2.000.000 de unidades/ml) | M0202T | New England Biolabs | con vectores pMPRA |
| One Shot TOP10 Electrocomp E. coli | Life Technologies | C4040-50 | Clonación de bibliotecas con vectores pMPRA |
| Agar LB y medios líquidos con carbeniclina | Genérico | n/a | Medios de crecimiento para clonación |
| E-Gel EX Geles 1% | Life Technologies | G4010-01 | Verificación y purificación de bibliotecas |
| E-Gel EX Gels, 2% | Life Technologies | G4010-02 | Verificación y purificación de bibliotecas |
| Kit de extracción de gel MinElute Qiagen | 28604 | Purificación de bibliotecas y columna vertebral | |
| EndoFree Plasmid Maxi Kit | Qiagen | 12362 | Biblioteca Aislamiento de ADN |
| Medios de cultivo celular | n/a | n/a | Reactivos de |
| transfección | n/a | n/a | MicroPoly |
| (A)Purist | Kit Life Technologies | AM1919 | Aislamiento de ARNm |
| TURBO Kit libre de ADN Life | Technologies | AM1907 | Eliminación de ADN plasmídico |
| SuperScript III Sistema de síntesis de primera cadena | Life Tecnologías | 18080-051 síntesis de | ADNc |
| PfuUltra II Hotstart PCR Master Mix | Agilent | 600850 | Polymerase para cebadores de PCR Tag-Seq |
| (ver texto)Imprimadores | personalizados IDT | PAGE purify Tag-Seq |
Referencias
- Kinney, J., Murugan, A., Callan, C. G., Cox, E. C. Using deep sequencing to characterize the biophysical mechanism of a transcriptional regulatory sequence. Proceedings of the National Academy of Sciences USA. 107 (20), 9158-9163 (2010).
- Melnikov, A., et al. Systematic dissection and optimization of inducible enhancers in human cells using a massively parallel reporter assay. Nature Biotechnology. 30 (3), 271-277 (2012).
- Patwardhan, R. P., Lee, C., Litvin, O., Young, D. L., Pe’er, D., Shendure, J. High-resolution analysis of DNA regulatory elements by synthetic saturation mutagenesis. Nature Biotechnology. 27 (12), 1173-1175 (2009).
- Patwardhan, R. P., et al. Massively parallel functional dissection of mammalian enhancers in vivo. Nature Biotechnology. 30 (3), 265-270 (2012).
- Arnold, C. D., Gerlach, D., Stelzer, C., Boryń, ŁM., Rath, M., Stark, A. Genome-wide quantitative enhancer activity maps identified by STARR-seq. Science (New York, N. Y.). 339 (6123), 1074-1077 (2013).
- Kheradpour, P., et al. Systematic dissection of regulatory motifs in 2000 predicted human enhancers using a massively parallel reporter assay. Genome Research. 23 (5), 800-811 (2013).
- White, M. A., Myers, C. A., Corbo, J. C., Cohen, B. A. Massively parallel in vivo enhancer assay reveals that highly local features determine the cis -regulatory function of ChIP-seq peaks. Proceedings of the National Academy of Sciences USA. 110 (29), 11952-11957 (2013).
- Mogno, I., Kwasnieski, J. C., Cohen, B. A. Massively parallel synthetic promoter assays reveal the in vivo effects of binding site variants. Genome Research. 23 (11), 1908-1915 (2013).
- Schütze, T., et al. A streamlined protocol for emulsion polymerase chain reaction and subsequent purification. Analytical Biochemistry. 410 (1), 155-157 (2011).
- Panne, D., Maniatis, T., Harrison, S. C. An atomic model of the interferon-beta enhanceosome. Cell. 129 (6), 1111-1123 (2007).
Reimpresiones y permisos
Erratum
Formal Correction: Erratum: Massively Parallel Reporter Assays in Cultured Mammalian Cells
Posted by JoVE Editors on 3/01/2015. Citeable Link.
null
Explorar más artículos
Ensayo de Informador Masivamente ParaleloConstrucción de Librerías de InformadoresAnálisis de Secuencias de ADNActividad Regulatoria GénicaTransfección de Células MamíferasAnálisis de Secuenciación ProfundaProtocolo de PCR en EmulsiónPreparación de Librerías de PlásmidosRecuento de Etiquetas de SecuenciaAnálisis Computacional
