Este análisis bibliométrico utilizó CiteSpace, VOSviewer y Scimago Graphica para evaluar tendencias de publicación, redes de colaboración y nuevos puntos críticos de investigación en la investigación sobre reprogramación metabólica de linfocitos T entre 2016 y 2025.
Se requiere una suscripción a JoVE para ver este contenido. Inicie sesión o comience su prueba gratuita.
Artículo de investigación
Análisis bibliométrico de la reprogramación metabólica en linfocitos T revela tendencias de investigación y puntos críticos emergentes, 2016-2025
* These authors contributed equally
En este artículo
Resumen
Resumen
Los linfocitos T son reguladores centrales de las respuestas inmunitarias, y estudios recientes han demostrado que los procesos metabólicos influyen en la activación, diferenciación y función efectora de los linfocitos T en el cáncer y las enfermedades autoinmunes. Este estudio realizó un análisis bibliométrico de publicaciones desde el 1 de enero de 2016 hasta el 31 de diciembre de 2025, extraídas de la Web of Science Core Collection. CiteSpace se utilizó para análisis de co-ocurrencia, co-citación y agrupamiento de referencias y palabras clave. VOSviewer se aplicó para analizar revistas, autores, referencias, países e instituciones, mientras que Scimago Graphica visualizó redes nacionales de colaboración y Excel se utilizó para evaluar las tendencias anuales de publicación. Se incluyeron un total de 1.882 publicaciones. La producción anual de publicaciones aumentó de forma constante, con un crecimiento notable observado en 2021 y 2025. China aportó el mayor volumen de publicaciones, mientras que Estados Unidos mostró un mayor impacto en las citas. Frontiers in Immunology fue la revista más productiva, mientras que Nature mostró la mayor influencia en las citas. El agrupamiento de palabras clave y los análisis de citas identificaron puntos de investigación en evolución centrados en la reprogramación metabólica de los linfocitos T, el metabolismo de la glucosa y los aminoácidos, y el interés emergente en las interacciones metabólicas entre células inmunitarias. En conjunto, este análisis bibliométrico demuestra la continua expansión de la investigación en inmunometabolismo de los linfocitos T y destaca direcciones temáticas emergentes, incluyendo la regulación metabólica intercelular y el metabolismo lipídico.
Introducción
Los linfocitos T naïves dependen principalmente de la fosforilación oxidativa mitocondrial (OXPHOS) para mantener su estado metabólico de reposo y bajaenergía. Sin embargo, tras la estimulación del antígeno, los linfocitos T activados experimentan un cambio metabólico hacia la glucólisis aeróbia para apoyar una rápida proliferación y funciónefectora 2. Los linfocitos efectores T, especialmente los subconjuntos citotóxicos, dependen de la glucólisis para satisfacer las mayores demandas bioenergéticas y biosintéticas asociadas a la producción de citocinas y la expansióncelular 3. Aunque la glucólisis produce menos adenosina trifosfato (ATP) por molécula de glucosa que OXPHOS, su rápido ritmo metabólico sostiene los requisitos funcionales de las células inmunitariasactivadas 4. Una actividad glucolítica excesiva también puede contribuir a efectos perjudiciales dentro del microambiente inmunitario. La acumulación de lactato puede afectar la síntesis de serina derivada de la glucosa y alterar el equilibrio redox intracelular, suprimiendo así la proliferación y función de los linfocitosT 5. Además, los niveles elevados de lactato interrumpen las vías migratorias dependientes de la glucólisis y reducen la motilidad de los linfocitos T CD4⁺ y CD8⁺6,7.
El metabolismo celular se adapta dinámicamente a estímulos ambientales y fisiológicos mediante un proceso conocido como reprogramaciónmetabólica 8,9. Cada vez hay más evidencia que indica que la reprogramación metabólica desempeña un papel central en la regulación de la activación, diferenciación y plasticidad funcional de los linfocitosT 10,11. Estas alteraciones metabólicas son especialmente relevantes en el cáncer y las enfermedades autoinmunes, donde los cambios en el microambiente inmunitario influyen en la función de los linfocitos T y la regulacióninmunitaria 12,13. Aunque varios estudios bibliométricos han evaluado el inmunometabolismo en contextos más amplios, incluyendo el inmunometabolismo del cáncer y el metabolismo inmunitario asociado a enfermedades, estos análisis se centran principalmente en las interacciones inmune-metabólicas generalizadas más que en la reprogramación metabólica específica de linfocitosT 14,15. Una evaluación bibliométrica integral dedicada específicamente al inmunometabolismo de los linfocitos T sigue siendo limitada, especialmente en lo que respecta a las tendencias de investigación, las redes de colaboración y los puntos críticos temáticos en evolución dentro de este campo.
Para cubrir esta carencia, este estudio realizó un análisis bibliométrico de publicaciones indexadas en la Web of Science Core Collection (WOScc) desde el 1 de enero de 2016 hasta el 31 de diciembre de 2025. CiteSpace, VOSviewer y Scimago Graphica se utilizaron para analizar cuantitativamente la producción de publicaciones, patrones de colaboración, relaciones de co-citación y evolución temática en la investigación sobre reprogramación metabólica de linfocitos T. A diferencia de las revisiones narrativas tradicionales, el análisis bibliométrico ofrece una visión estructurada y basada en datos del panorama científico mediante citas, agrupaciones y análisis de palabras clave. El objetivo de este estudio fue caracterizar sistemáticamente las tendencias globales de investigación y los puntos críticos emergentes en el inmunometabolismo de los linfocitos T, así como proporcionar una visión organizada del panorama actual del conocimiento en este campo en rápida evolución.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Protocolo
Este estudio analizó exclusivamente datos bibliográficos obtenidos de bases de datos de acceso público y no involucró participantes humanos, animales ni datos personales identificables; por lo tanto, no se requería la aprobación ética institucional ni el consentimiento informado.
Recogida de datos y estrategia de búsqueda
Los datos se extrajeron del WoSCC (https://www.webofscience.com/wos/woscc/) el 27 de enero de 2026. Las ediciones seleccionadas en la base de datos fueron el Science Citation Index Expanded (SCI-EXPANDED) y el Social Sciences Citation Index dentro de WoSCC. La búsqueda se realizó utilizando la interfaz de Búsqueda Avanzada. La estrategia de búsqueda se aplicó en el campo "Tema (TS)", y la consulta completa de búsqueda y los registros resultantes se presentan en la Tabla 1. El periodo de búsqueda se restringió a publicaciones indexadas entre el 1 de enero de 2016 y el 31 de diciembre de 2025 utilizando el filtro "Timespan" de WoSCC. Solo se incluyeron artículos de investigación originales y artículos de revisión usando el filtro "Tipos de documentos". El idioma estaba restringido al inglés y no se aplicaban restricciones respecto al país, institución o área de investigación. Todos los registros se exportaron en formato de texto plano con "Registro completo y referencias citadas" seleccionadas durante la exportación. Cuando el número de registros recuperados superaba los 500, los registros se descargaban en varios lotes y posteriormente se fusionaban en un único conjunto de datos antes del análisis. Tras la recuperación, todos los registros se importaban a CiteSpace para su preprocesamiento y análisis bibliométrico. Los registros duplicados se identificaban y eliminaban usando la función de deduplicación integrada en CiteSpace basada en metadatos bibliográficos, incluyendo título, autores, año de publicación y revista fuente. Cuando se identificaban posibles inconsistencias o registros bibliográficos incompletos, se realizaba además una verificación manual para asegurar la precisión y consistencia de los datos antes del análisis.
| Set | Resultados | Consulta de búsqueda |
| #1 | 252,461 | TS=("Linfocitos T*" O "Linfocitos T*" O "Linfocitos T*" O "Linfocitos T*" O "Linfocitos T*" O "Linfocitos CD4+*" O "Células T CD8+*" O "células T citotóxicas*" O "células T reguladoras*" O "Treg*" O "células T ayudantes*" O "células T ingenuas*" O "células T de memoria*" O "células T efectoras*") |
| #2 | 13,799 | TS=("reprogramación metabólica*" O "remodelación metabólica*" O "reprogramación metabólica") |
| #3 | 1,882 | #1 Y #2 |
Tabla 1: Estrategia de búsqueda de la colección central Web of Science utilizada para la recuperación de datos bibliométricos. La tabla resume la estrategia de búsqueda detallada, las combinaciones de palabras clave, los operadores booleanos y los recuentos finales de recuperación utilizados para la recopilación de literatura del WoSCC. Las búsquedas se realizaban utilizando el campo "Topic (TS)" en la interfaz de Búsqueda Avanzada. Los comodines (*) se usaban para recuperar múltiples terminaciones de palabras y terminología relacionada. El conjunto final de datos consistió en publicaciones indexadas entre el 1 de enero de 2016 y el 31 de diciembre de 2025 tras la aplicación de filtros de lenguaje y tipo documento.
Enfoques analíticos
Se implementó sistemáticamente un enfoque bibliométrico multiherramienta para el análisis de datos. El análisis se realizó en un entorno de sistema operativo Windows 10. CiteSpace (v.5.7.R2) se utilizó para analizar referencias y palabras clave procesando datos en formato TXT exportados desde WoSCC. Los parámetros de CiteSpace se configuraron de la siguiente manera: (1) el segmento temporal se estableció de 2016 a 2025 con un año por segmento; (2) los criterios de selección se configuraron usando el índice g (k = 25); (3) los métodos de poda incluían Pathfinder, Poda de Redes Segmentadas y Poda de la Red Fusionada para simplificar las estructuras de la red preservando las relaciones clave; y (4) el análisis de agrupación se realizó utilizando el algoritmo logarítmico-verosimilidad16. Este análisis generó redes de co-citas, mapas de agrupamiento, visualizaciones de líneas temporales y mapas de detección de ráfagas tanto para referencias como para palabras clave. En los mapas de visualización, el tamaño de los nodos representaba la frecuencia, el grosor del enlace indicaba la fuerza de co-ocurrencia y los anillos morados representaban una alta centralidad de intermedios. Los nodos burst reflejaban un aumento repentino en la frecuencia de citas o palabras clave con el tiempo.
Posteriormente, los archivos exportados se guardaron de nuevo en codificación UTF-8 usando el Bloc de notas de Windows e importados en VOSviewer (versión 1.6.20) para el mapeo bibliométrico, incluyendo análisis de coautoría, co-citación y coocurrencia entre autores, revistas, instituciones y países17. Se aplicó el método de conteo completo y se realizó la normalización utilizando el método de fuerza de asociación. Se establecieron umbrales mínimos de ocurrencia según el tamaño del conjunto de datos (autores ≥ 5 publicaciones; palabras clave ≥ 5 ocurrencias; instituciones ≥ 3 publicaciones). La visualización de la red se basaba en el peso del ítem y la fuerza total del enlace. Para el análisis de colaboración a nivel de país, los archivos GML exportados desde VOSviewer se importaron a Scimago Graphica (versión 1.0.53), donde los nodos representaban países. La visualización de redes y el agrupamiento se generaron utilizando el algoritmo de diseño dirigido por la fuerza por defecto para representar relaciones espaciales y patrones de colaboración entre países. WPS Excel se utilizó para análisis estadístico descriptivo de tendencias de publicaciones anuales y resumen básico de datos. Los resultados se visualizaron utilizando gráficos de barras, columnas y gráficos de líneas.
Se realizó un análisis suplementario en segmentos temporales utilizando la misma estrategia de búsqueda descrita anteriormente, restringiendo la búsqueda a publicaciones indexadas entre el 1 de enero de 2025 y el 31 de diciembre de 2025. Dentro del mismo marco de consulta y entorno analítico de WoSCC, se recuperaron publicaciones recientes y resultados relacionados con conferencias con fines contextuales y descriptivos. Este procedimiento se llevó a cabo íntegramente dentro de la interfaz analítica integrada del WoSCC. No se creó ningún conjunto de datos independiente, y la información recuperada no se integró en el conjunto bibliométrico principal ni se utilizó para análisis cuantitativo. El diseño general del estudio y el flujo de trabajo de análisis bibliométrico se resumen en un diagrama de flujo (Figura 1).
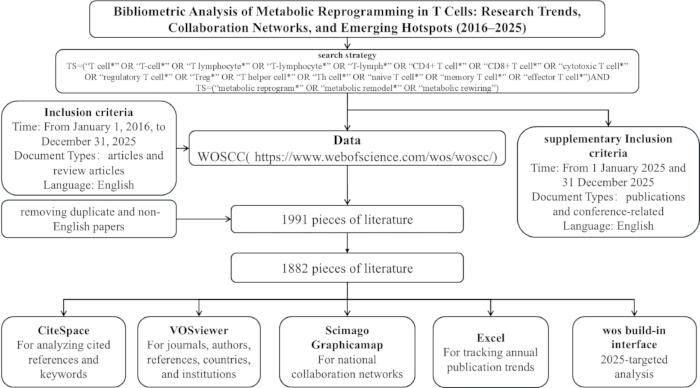
Figura 1. Flujo de trabajo del análisis bibliométrico de la investigación sobre reprogramación metabólica de linfocitos T. Visión general esquemática del diseño del estudio y del flujo de trabajo analítico utilizado en este análisis bibliométrico. Las publicaciones se recuperaron de la Web of Science Core Collection (WoSCC) utilizando estrategias de búsqueda predefinidas y criterios de inclusión. Los registros recuperados se exportaban en formato de texto plano y se sometían a preprocesamiento, incluyendo la eliminación de duplicados y la estandarización de datos bibliográficos. Se realizaron análisis bibliométricos utilizando CiteSpace para análisis de co-citas, coocurrencia de palabras clave, agrupamiento y detección de ráfagas, y VOSviewer para análisis de redes de colaboración entre autores, instituciones, países y revistas. Scimago Graphica se utilizó para visualizar redes de colaboración internacional, y WPS Excel se empleó para analizar tendencias de publicaciones anuales y estadísticas descriptivas. Por favor, haz clic aquí para ver una versión ampliada de esta figura.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Resultados
Producción de publicaciones y tendencias temporales
Para caracterizar la evolución temporal de la actividad investigadora en este campo, se realizó un análisis bibliométrico utilizando publicaciones indexadas en el WoSCC. En la última década se recuperaron inicialmente 1.991 registros. Tras la eliminación de registros duplicados y no ingleses, finalmente se incluyeron y analizaron 1.882 publicaciones, incluyendo 1.046 artículos de investigación originales y 836 artícu...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Discusión
Nuestro análisis bibliométrico de la reprogramación metabólica en células T reveló un aumento sostenido en la producción de investigación a lo largo del tiempo. En 2020 se produjo un aumento notable en el número de publicaciones y citas, con 40 publicaciones adicionales y 1.989 citas adicionales en comparación con 2019. Este aumento coincidió temporalmente con varias publicaciones muy citadas, incluyendo Glutamine blockade induces divergent metabolic programs to overcome tumor i...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Divulgaciones
Conflictos de interés:
Los autores no declaran conflictos de interés relacionados con esta obra.
Contúaciones del autor:
La recopilación de datos y la recuperación de literatura fueron realizadas por Yi Liu. El preprocesamiento de datos y los análisis bibliométricos fueron realizados por Yinping Yang. La visualización y la preparación de figuras fueron realizadas por Xinyue Yang y Jinquan Li. El primer borrador del manuscrito fue escrito por Yi Liu y Weihong Li. Todos los autores contribuyeron a la revisión del manuscrito y aprobaron la versión final enviada.
Agradecimientos
Los autores agradecen el apoyo financiero de los Fondos de Investigación Fundamental para las Universidades Centrales (2022-JYB-JBZR-037).
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| CiteSpace | Drexel University | v.5.7.R2 | SCR_025121 |
| Microsoft Excel | Microsoft Corporation | v.2604 Build 16.0.19929.20136 | SCR_016137 (Microsoft Excel) |
| WPS Excel | Kingsoft Office | v.12.1.0.26375 | |
| Scimago Graphica | Scimago Lab | v.1.0.53 | No disponible |
| VOSviewer | Leiden University | v.1.6.20 | SCR_023516 |
| Web of Science Core Collection | Clarivate Analytics | accesado el 27 de enero de 2026; versión no aplicable | No disponible |
| Windows Operating System | Microsoft Corporation | Windows 10 | No disponible |
Referencias
- Pearce EL, et al. Fueling immunity: insights into metabolism and lymphocyte function. Science. 2013;342(6155):1242454.
- Wang R, et al. The transcription factor Myc controls metabolic reprogramming upon T-lymphocyte activation. Immunity. 2011;35(6):871-82.
- Shyer JA, et al. Metabolic signaling in T cells. Cell Res. 2020;30(8):649-59.
- Gubser PM, et al. Rapid effector function of memory CD8+ T cells requires an immediate-early glycolytic switch. Nat Immunol. 2013;14(10):1064-72.
- Yuan Q, et al. Enhancing intracellular NADPH bioavailability through improving pentose phosphate pathway flux and its application in biocatalysis asymmetric reduction reaction. J Biosci Bioeng. 2022;134(6):528-33.
- Quinn WJ III, et al. Lactate limits T-cell proliferation via the NAD(H) redox state. Cell Rep. 2020;33(11):108500.
- Pucino V, et al. Lactate buildup at the site of chronic inflammation promotes disease by inducing CD4+ T-cell metabolic rewiring. Cell Metab. 2019;30(6):1055-74.e8.
- O'Neill LAJ, et al. A guide to immunometabolism for immunologists. Nat Rev Immunol. 2016;16(9):553-65.
- Almeida L, et al. Metabolic pathways in T-cell activation and lineage differentiation. Semin Immunol. 2016;28(5):514-24.
- Haas R, et al. Lactate regulates metabolic and pro-inflammatory circuits in control of T-cell migration and effector functions. PLoS Biol. 2015;13(7):e1002202.
- Chang CH, Pearce EL. Emerging concepts of T-cell metabolism as a target of immunotherapy. Nat Immunol. 2016;17(4):364-68.
- Ho PC, et al. Reenergizing T-cell anti-tumor immunity by harnessing immunometabolic checkpoints and machineries. Curr Opin Immunol. 2017;46:38-44.
- Von Meyenn L, et al. Targeting T-cell metabolism in inflammatory skin disease. Front Immunol. 2019;10:2285.
- Zhu H, et al. Trends and hotspots in research related to tumor immune escape: bibliometric analysis and future perspectives. Front Immunol. 2025;16:1604216.
- Zhang B, et al. Mapping research trends in immune-cell metabolic reprogramming in breast cancer: a parallel dual-database bibliometric study. Discov Oncol. 2026;17:724.
- Chen G, et al. Rheumatoid arthritis and fibromyalgia syndrome: a bibliometric and bioinformatics perspective on comorbidity research. J Multidiscip Healthc. 2025;18:6811-27.
- Wang Y, et al. Research trends and hotspots in JAK inhibitors for ulcerative colitis: a bibliometric analysis from 2015 to 2024. J Multidiscip Healthc. 2025;18:6755-71.
- Leone RD, et al. Glutamine blockade induces divergent metabolic programs to overcome tumor immune evasion. Science. 2019;366(6468):1013-21.
- Watson MJ, et al. Metabolic support of tumour-infiltrating regulatory T cells by lactic acid. Nature. 2021;591(7851):645-51.
- Xia L, et al. The cancer metabolic reprogramming and immune response. Mol Cancer. 2021;20(1):28.
- Miao S, et al. tRNA m1A modification regulates cholesterol biosynthesis to promote antitumor immunity of CD8+ T cells. J Exp Med. 2025;222(3):e20240559.
- Angelin A, et al. Foxp3 reprograms T-cell metabolism to function in low-glucose, high-lactate environments. Cell Metab. 2017;25(6):1282-93.e7.
- Huang SC, et al. Metabolic reprogramming mediated by the mTORC2-IRF4 signaling axis is essential for macrophage alternative activation. Immunity. 2016;45(4):817-30.
- Nakaya M, et al. Inflammatory T-cell responses rely on amino acid transporter ASCT2 facilitation of glutamine uptake and mTORC1 kinase activation. Immunity. 2014;40(5):692-705.
- Ma EH, et al. Serine is an essential metabolite for effector T-cell expansion. Cell Metab. 2017;25(2):345-57.
- Pearce EL, et al. Fueling immunity: insights into metabolism and lymphocyte function. Science. 2013;342(6155):1242454.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.