Genetyczny test reporterowy jest dobrze znanym i potężnym narzędziem do analizowania relacji między sekwencjami DNA a ich aktywnością regulacyjną genów. Sprzężenie potencjalnych elementów regulatorowych z genami reporterowymi, które przenoszą identyfikujące znaczniki sekwencji, umożliwia masową równoległość tych testów.
Artykuł metodologiczny
Masowo równoległe testy reporterowe w hodowanych komórkach ssaków
W tym artykule
Informacja o sprostowaniu
Important: There has been an erratum issued for this article. View Erratum Notice
Podsumowanie
Streszczenie
Genetyczny test reporterowy jest dobrze znanym i potężnym narzędziem do analizowania relacji między sekwencjami DNA a ich aktywnością regulacyjną genów. Potencjalna przepustowość tego testu została jednak ograniczona przez konieczność indywidualnego klonowania i oznaczania aktywności każdej interesującej sekwencji przy użyciu fluorescencji białek lub aktywności enzymatycznej jako wskaźnika aktywności regulacyjnej. Postępy w wysokoprzepustowej syntezie DNA i technologiach sekwencjonowania umożliwiły ostatnio przezwyciężenie tych ograniczeń poprzez multipleksowanie konstrukcji i przeszukiwanie dużych bibliotek konstruktów reporterowych. Protokół ten opisuje implementację masowo równoległego testu reporterowego (MPRA), który umożliwia bezpośrednie porównanie setek tysięcy przypuszczalnych sekwencji regulatorowych w jednym naczyniu do hodowli komórkowej.
Wprowadzenie
Analizy reporterowe masowo równoległe (MPRA) umożliwiają multipleksowe pomiary aktywności regulacji transkrypcyjnej tysięcy lub setek tysięcy sekwencji DNA1-7. W ich najczęstszej implementacji multipleksowanie osiąga się poprzez połączenie każdej interesującej sekwencji z syntetycznym genem reporterowym, który zawiera identyfikujący znacznik sekwencji poniżej otwartej ramki odczytu (ORF; Rysunek 1). Po transfekcji, izolacji RNA i głębokim sekwencjonowaniu końców 3’ transkryptów genu reporterowego, względną aktywność połączonych sekwencji można wywnioskować z względnej liczności ich identyfikujących znaczników.

Rycina 1. Przegląd MPRA. Bibliotekę konstruktów reporterowych MPRA tworzy się poprzez połączenie domniemanych sekwencji regulatorowych z syntetycznymi genami reporterowymi, które składają się z „obojętnej” ramki odczytu ORF (takiej jak GFP lub lucyferaza), po której następuje identyfikujący tag sekwencji. Bibliotekę transfekuje się en masse do populacji hodowlanych komórek, a następnie odzyskuje transkrybowane mRNA reporterowe. Sekwencjonowanie głębokie jest wykorzystywane do zliczenia liczby wystąpień każdego tagu wśród mRNA reporterowych oraz w transfektowanych plazmidach. Stosunek liczby cząsteczek mRNA do liczby plazmidów może służyć do wnioskowania o aktywności odpowiadającej im sekwencji regulatorowej. Adaptowano za zgodą Melnikova et al2.
Metodę MPRA można dostosować do szerokiej gamy projektów eksperymentalnych, w tym do: 1) kompleksowej mutagenezy poszczególnych elementów regulacyjnych genów, 2) poszukiwania nowych elementów regulacyjnych w obrębie interesującego badacza locus, 3) testowania wpływu naturalnej zmienności genetycznej w zestawie domniemanych promotorów, enhancerów lub silencerów oraz 4) półracjonalnego projektowania syntetycznych elementów regulacyjnych. Biblioteki wariantów sekwencji można generować za pomocą różnych metod, w tym syntezy bibliotek oligonukleotydów (OLS) na programowalnych mikromacierzach2,3,6,7, składania zdegenerowanych oligonukleotydów1,4, ligacji kombinatorycznej8 oraz fragmentacji genomowego DNA5.
Niniejszy protokół opisuje konstrukcję biblioteki wariantów promotorów przy użyciu metody OLS oraz wektorów pMPRA1 i pMPRAdonor1 (odpowiednio identyfikatory Addgene 49349 i 49352; http://www.addgene.org), przejściową transfekcję tej biblioteki do hodowanych komórek ssaków oraz późniejszą kwantyfikację aktywności promotorów poprzez głębokie sekwencjonowanie przypisanych do nich tagów (Tag-Seq). Wcześniejsze wersje tego protokołu zostały wykorzystane w badaniach opisanych w pracy Melnikov et al. Nature Biotechnology 30, 271-277 (2012) oraz Kheradpour et al. Genome Research 23, 800-811 (2013).
Protokół
1. Projektowanie i synteza sekwencji
- Rozpocznij MPRA od zaprojektowania i syntezy sekwencji, których aktywność regulacyjna ma zostać przebadana. Aby zapewnić kompatybilność z serią wektorów pMPRA, zaprojektuj każdą sekwencję zgodnie z następującym szablonem: 5’-ACTGGCCGCTTCACTG-var-GGTACCTCTAGA-tag-AGATCGGAAGAGCGTCG-3’, gdzie var oznacza sekwencję badaną, a tag oznacza jeden lub więcej znaczników identyfikacyjnych.
- Dwa regiony zmienne (var i tag) są rozdzielone parą miejsc restrykcyjnych KpnI (GGTACC) i XbaI (TCTAGA), co ułatwia kierunkową ligację fragmentu genu reporterowego pomiędzy nimi. Dodatkowo, za pomocą PCR zostaną dodane dwa odrębne miejsca SfiI (GGCCNNNNNGGCC), aby umożliwić kierunkową ligację do szkieletu pMPRA. Regiony zmienne nie mogą zawierać dodatkowych kopii żadnego z tych miejsc restrykcyjnych. W razie potrzeby jeden lub więcej z tych enzymów restrykcyjnych można zastąpić innymi, pod warunkiem że zamienniki 1) umożliwiają efektywne cięcie blisko końców cząsteczek DNA oraz 2) nie tną w innych miejscach sekwencji wektora. Dodatkowe szczegóły znajdują się w sekcji Dyskusja.
- Zamów wymagane primery wymienione w Tabeli 1 u komercyjnego dostawcy.
| MPRA_SfiI_F | GCTAAGGGCCTAACTGGCCGCTTCACTG |
| MPRA_SfiI_R | GTTTAAGGCCTCCGTGGCCGACGCTCTTC |
| TAGseq_P1 | AATGATACGGCGACCACCGAGATCTACACT CTTTCCCTACACGACGCTCTTCCGATCT |
| TAGseq_P2 | CAAGCAGAAGACGGCATACGAGAT[indeks]GTGAC TGGAGTTCAGACGTGTGCTCTTCCGATCTCGAG GTGCCTAAAGG |
Tabela 1. Sekwencje starterów. [index] oznacza 6-8 nt sekwencję indeksującą stosowaną w sekwencjonowaniu multipleksowym. Należy pozyskać co najmniej 8 starterów TagSeq-P2 z różnymi indeksami. Wszystkie startery powinny zostać oczyszczone metodą HPLC lub PAGE.
- Biblioteki oligonukleotydów można pozyskać od komercyjnego dostawcy, z centrum usług wspólnych (core facility) lub wygenerować przy użyciu programowalnego syntezatora oligonukleotydów opartego na mikromierzach, zgodnie z opisem producenta. Produkty OLS należy zawiesić w 100 µl buforu TE 0.1.
- Biblioteki oligonukleotydów należy rozdzielić na denaturującym żelu poliakrylamidowym 10% TBE-Urea. Na każdą ścieżkę należy nanieść około 1 pmol i zabarwić barwnikiem fluorescencyjnym czułym na ssDNA, aby ocenić ich jakość (Ryc. 2A).
- Jeśli widoczny jest wyraźny prążek odpowiadający pełnowymiarowym oligonukleotydom (Ryc. 2A, ścieżki 1 i 2), należy wyciąć odpowiedni fragment żelu akrylamidowego i eluować oligonukleotydy do 100 µl buforu TE 0.1 przez noc w temperaturze pokojowej przy wytrząsaniu. W przeciwnym razie należy kontynuować pracę, używając surowej zawiesiny OLS.
- Należy przeprowadzić amplifikację i dodać ogony SfiI do biblioteki oligonukleotydów za pomocą emulsyjnej PCR 9.
- Należy przygotować 50 µl mieszanin reakcyjnych PCR zgodnie z opisem w Tabeli 2. Następnie połączyć je z 300 µl mieszaniną oleju i surfaktantu z zestawu Micellula DNA Emulsion and Purification i wymieszać w wortexie przez 5 min w 4 °C.
| Odczynnik | 1x objętość (µl) |
| Polimeraza DNA fuzyjna Herculase II | 0.5 |
| 5x bufor reakcyjny Herculase II | 10 |
| dNTP (każdy 10 mM) | 1.25 |
| BSA (20 mg/ml) | 1.25 |
| Starter MPRA_SfiI_F (25 µM) | 0.25 |
| Starter MPRA_SfiI_R (25 µM) | 0.25 |
| Szablon OLS (1–10 attomoli) | zmienia się |
| Woda wolna od nukleaz | do 50 |
Tabela 2. Mieszanina reakcyjna do PCR w emulsji (faza wodna).
- Należy zastosować stężenie zapewniające maksymalną wydajność produktów amplifikacji bez pojawiania się artefaktów (patrz sekcja 1.12).
- Rozdzielić otrzymaną emulsję do probówek PCR i przeprowadzić 20 cykli PCR (2 min w 95 °C, 20 x[20 s w 95 °C, 20 s w 55 °C, 30 s w 72 °C], 3 min w 95 °C).
- Połączyć i rozbić każdą reakcję PCR w emulsji o objętości 350 µl poprzez dodanie 1 ml izobutanolu i krótkie wymieszanie na wirówce typu vortex, a następnie oczyścić produkt amplifikacji za pomocą kolumny do oczyszczania DNA.
- Przeprowadzić elektroforezę niewielkiej próbki na żelu agarozowym 2% lub 4%, aby potwierdzić amplifikację bez artefaktów (Rycina 2B).

Rysunek 2. Przygotowanie bibliotek syntezy oligonukleotydów. A) Trzy różne surowe biblioteki syntezy oligonukleotydów (OLS) poddane elektroforezie na denaturujących 10% żelach poliakrylamidowych TBE-Urea. Prążki odpowiadające pełnowymiarowym oligonukleotydom (*) można zwizualizować i wyciąć z bibliotek 1 i 2. Biblioteka 3 zawiera zanieczyszczenia, które utrudniają oczyszczanie metodą PAGE. W takim przypadku należy przejść bezpośrednio do amplifikacji PCR. B) Produkty otwartej i emulsyjnej amplifikacji PCR tej samej biblioteki oligonukleotydów poddane elektroforezie na żelu agarozowym. Amplifikacja PCR złożonych bibliotek oligonukleotydów często prowadzi do powstania produktów chimerycznych i innych artefaktów, które mogą pojawiać się jako prążki o wyższej i niższej masie cząsteczkowej. Emulsyjny PCR może zminimalizować te artefakty.
2. Konstrukcja biblioteki
- Przygotować zlinearyzowany szkielet plazmidu poprzez trawienie wektora pMPRA1 enzymem SfiI w temperaturze 50 °C przez 2 h, rozdzielenie na 1% żelu agarozowym, wycięcie prążka szkieletu (w tym przypadku 2,5 kb) i oczyszczenie go za pomocą kolumny do oczyszczania z żelu.
- Strawić produkty PCR z emulsji z kroku 1.4 enzymem SfiI w 50 °C przez 2 h i oczyścić za pomocą kolumn do oczyszczania DNA.
- Aby ligować bibliotekę promotor-tag do zlinearyzowanego szkieletu wektora, przygotować reakcje zawierające 100 ng strawionego produktu PCR, 50 ng zlinearyzowanego szkieletu wektora oraz ligazę T4 DNA. Inkubować przez noc w 16 °C, a następnie podgrzać do 65 °C przez 20 min w celu inaktywacji ligazy.
- Przeprowadzić transformację E. coli mieszaniną ligacyjną. Aby zachować złożoność biblioteki, należy dążyć do uzyskania co najmniej 10-krotnie większej liczby jtk niż liczba odrębnych kombinacji promotor-tag w zaprojektowanej bibliotece.
- Gdy całkowita liczba tagów wynosi około 100 000, docelową liczbę jtk można zazwyczaj osiągnąć, wykonując 6-8 równoległych transformacji na bibliotekę.
- Dla każdej transformacji połączyć 50 µl elektrokompetentnych komórek E. coli z 2 µl mieszaniny ligacyjnej na lodzie. Transformować metodą elektroporacji, regenerować komórki w 800 µl medium SOC przy wytrząsaniu w 37 °C przez 1 h, a następnie połączyć komórki z równoległych transformacji.
- Aby ocenić wydajność transformacji, wysiać rozcieńczenia seryjne z aliquoty zregenerowanych komórek na płytki z agarem LB z dodatkiem 50-100 µg/ml karbenicyliny i inkubować przez noc w 37 °C. Całkowitą liczbę jtk oszacować jako (obserwowana liczba jtk) × (czynnik rozcieńczenia) × (V - v) / v, gdzie V to całkowita objętość zregenerowanych komórek, a v to objętość aliquoty pobranej do rozcieńczeń seryjnych.
- Jednocześnie wykorzystać pozostałą część zregenerowanych komórek do zaszczepienia 200 ml LB z dodatkiem 100 µg/ml karbenicyliny. Hodować komórki w 37 °C przez noc w inkubatorze z wytrząsarką, a następnie wyizolować plazmidowe DNA zgodnie ze standardowymi procedurami.
- Strawić aliquot wyizolowanej biblioteki plazmidowej enzymem SfiI w 50 °C przez 2 h i rozdzielić na 1% żelu agarozowym, aby potwierdzić obecność insertów.
- Zlinearyzować bibliotekę plazmidową poprzez cięcie między wariantami promotorów a tagami przy użyciu KpnI i XbaI. Aby zmaksymalizować wydajność trawienia, przeprowadzić trawienia seryjne:
- Najpierw strawić KpnI w 37 °C przez 1 h i oczyścić za pomocą kulek magnetycznych. Następnie strawić XbaI z dodatkiem 1 U fosfatazy alkalicznej krewetkowej (Shrimp Alkaline Phosphatase) w 37 °C przez 2 h, inaktywować termicznie w 65 °C przez 5 min, a następnie oczyścić za pomocą kulek magnetycznych.
- Rozdzielić aliquot na 1% żelu agarozowym, aby zweryfikować pełną linearyzację. Jeśli widoczny jest niecięty plazmid, fragment zlinearyzowany należy oczyścić z żelu.
- Aby wygenerować bibliotekę MPRA odpowiednią do transfekcji do komórek ssaków, zligować ORF o końcach kompatybilnych z KpnI/XbaI do zlinearyzowanej biblioteki pośredniej.
- Aby przygotować kompatybilny fragment ORF luc2 z pMPRAdonor1, strawić ten plazmid enzymami KpnI i XbaI w 37 °C przez 1 h i rozdzielić na 1% żelu agarozowym. Wyciąć fragment ORF (w tym przypadku 1,7 kb) i oczyścić za pomocą kolumny do oczyszczania z żelu.
- Sklonować fragment ORF do zlinearyzowanej biblioteki pośredniej zgodnie z opisem w krokach 2.3-2.8.
- Strawić aliquot (odpowiadający 1-2 µg) biblioteki MPRA enzymem KpnI w 37 °C przez 1 h i rozdzielić na 1% żelu agarozowym. Jeśli strawiona biblioteka przesuwa się jako pojedynczy prążek, przejść do sekcji 3. Jeśli zaobserwowano dodatkowe prążki (zazwyczaj odpowiadające pozostałościom konstruktów pośrednich), bibliotekę można dodatkowo oczyścić w następujący sposób:
- Strawić 3-5 µg zanieczyszczonej biblioteki enzymem KpnI w 37 °C przez 1 h i rozdzielić na 0,8% żelu agarozowym przez noc w 4 °C.
- Wyciąć poprawny prążek biblioteki, oczyścić DNA za pomocą kolumny do oczyszczania z żelu i przeprowadzić samoligację przy użyciu stężonej ligazy T4 DNA w 37 °C przez 1 h. Następnie powtórzyć transformację i końcową izolację DNA biblioteki zgodnie z opisem w kroku 2.8.
3. Transfekcja, perturbacja i izolacja RNA
- Dla każdej niezależnej transfekcji należy hodować odpowiednią liczbę komórek (zależnie od złożoności biblioteki MPRA, patrz sekcja Dyskusja) w odpowiednim medium. Na przykład hodować komórki HEK293T/17 w DMEM uzupełnionym o 10% FBS oraz L-glutaminę/penicylinę/streptomycynę. Hodować komórki dla co najmniej dwóch niezależnych transfekcji dla każdej biblioteki i warunków eksperymentalnych.
- Wykonaj transfekcję hodowlanych komórek plazmidami MPRA. Metoda i warunki transfekcji muszą zostać zoptymalizowane dla każdego typu komórek. Dla każdej przetransfekowanej próbki zachowaj alikwot (50-100 ng) plazmidowego DNA jako kontrolę dopasowaną.
- Na przykład przetransfekuj 0,5 x 10⁷ komórek HEK293T/17 wyhodowanych do ~50% konfluencji w naczyniu hodowlanym 10 cm za pomocą 10 µg plazmidowego DNA w 1 ml Opti-MEM I Reduced Serum Medium, stosując 30 µl Lipofectamine LTX oraz 10 µl Plus Reagent. Usuń mieszaninę transfekcyjną po 5 godzinach i pozwól komórkom na regenerację przez 24-48 hr.
- Opcjonalnie przeprowadź wszelkie zabiegi niezbędne do aktywacji kontekstowych lub sygnałowo-zależnych sekwencji regulacyjnych w zaprojektowanej bibliotece.
- Zbierz komórki i wyizoluj mRNA poly(A)+, używając standardowych kolumn lub kulek z oligo(dT) celulozą zgodnie z instrukcjami producenta.
- Upewnij się, że maksymalna pojemność wiązania kolumn lub kulek przekracza całkowitą ilość mRNA spodziewaną z zebranych komórek. Na przykład przewidywana wydajność z sekcji 3.3 wynosi około 0,5-2,5 µg mRNA.
4. Sekwencjonowanie tagów (Tag-Seq)
- Aby wyeliminować zanieczyszczenia DNA wektora z lizatów transfekowanych komórek, każdą 20 µl próbkę mRNA należy inkubować z 1 µl Turbo DNase (2 U) oraz 2,3 µl 10x Turbo DNase buffer w temperaturze 37 °C przez 1 h, następnie dodać 2,4 µl Turbo DNase Inactivation Reagent i inkubować w temperaturze RT przez 5 min z mieszaniem, odwirutować przy 10 000 g przez 90 s, a następnie przenieść roztwór do nowej probówki.
- Czystość należy zweryfikować, wykonując PCR zgodnie z opisem w sekcji 4.6 na 60-100 ng każdej próbki mRNA, a następnie przeprowadzając elektroforezę produktów w żelu agarozowym. Jeśli widoczne są specyficzne amplikony (0,25 kb w przypadku użycia pMPRA1 z luc2), należy oczyścić potraktowane mRNA przy użyciu kolumny, a następnie powtórzyć obróbkę DNazą.
- W celu przygotowania bibliotek do sekwencjonowania Tag-Seq, mRNA reporterowe należy przekształcić w cDNA i dodać adaptery sekwencyjne za pomocą PCR.
- Mieszaniny mRNA/starterów RT należy przygotować zgodnie z opisem w Tabeli 3. Inkubować w 65 °C przez 5 min, a następnie umieścić na lodzie. Równocześnie należy przygotować reakcje syntezy cDNA zgodnie z opisem w Tabeli 4.
| Odczynnik | Objętość 1x (µl) |
| próbka mRNA (łącznie 400-700 ng) | 8 |
| Oligo-0dT (50 µM) | 1 |
| dNTP (każdy 10 mM) | 1 |
Tabela 3. Mieszanka starterów do RNA/transkrypcji odwrotnej dla syntezy cDNA.
| Odczynnik | 1x objętość (µl) |
| 10x bufor RT SuperScript III | 2 |
| MgCl₂2 (25 mM) | 4 |
| DTT (0,1 M) | 2 |
| RNaseOut (40 U/µl) | 1 |
| SuperScript III (200 U/µl) | 1 |
Tabela 4. Mieszanina reakcyjna do syntezy cDNA.
- Delikatnie połącz mieszaniny mRNA/starterów RT z mieszaninami do syntezy cDNA. Inkubuj w temperaturze 50 °C przez 50 min, 85 °C przez 5 min, a następnie umieść na lodzie. Na koniec inkubuj z 2 U rybonukleazy H w temperaturze 37 °C przez 20 min.
- Przygotuj reakcje PCR zgodnie z opisem w Tabeli 5, używając 4-6 µl mieszaniny reakcyjnej cDNA lub 50 ng plazmidu reporterowego jako matryc. Następnie przeprowadź amplifikację PCR (95 °C przez 2 min, 26 x [95 °C przez 30 s, 55 °C przez 30 s, 72 °C przez 30 s], 72 °C przez 3 min).
| Odczynnik | 1x objętość (µl) |
| 2x PfuUltra II HotStart PCR Master Mix | 25 |
| Starter TagSeq_P1 (25 µM) | 0.5 |
| Starter TagSeq_P2 (25 µM) | 0.5 |
| Matryca (mieszanina mRNA i cDNA lub plazmidowe DNA) | różni się |
| Woda wolna od nukleaz | do 50 |
Tabela 5. Mieszanina reakcyjna PCR dla Tag-Seq.
- Rozdziel produkty PCR w 2% żelu agarozowym, wytnij prążki odpowiadające amplikonom biblioteki Tag-Seq (0,25 kb w przypadku użycia pMPRA1 z luc2) i oczyść je za pomocą kolumienek do oczyszczania produktów z żelu.
- Połącz, zdenaturuj i zsekwencjonuj oczyszczone amplikony Tag-Seq bezpośrednio przy użyciu sekwenatora Illumina.
- Odfiltruj odczyty niskiej jakości, usuwając wszystkie, które a) zawierają jedną lub więcej pozycji z wynikiem jakości Phred poniżej 30 w obrębie zsekwencjonowanego tagu lub b) nie są dokładnym dopasowaniem do zaprojektowanego tagu. Oblicz liczbę wystąpień każdego pozostałego tagu w każdej bibliotece. Znormalizuj liczbę tagów do TPM (tags per million sequenced tags), a następnie oblicz stosunek liczby tagów pochodzących z mRNA do liczby tagów pochodzących z plazmidu dla każdej pary bibliotek sekwencyjnych. Jeśli do każdego wariantu sekwencji przypisano wiele różnych tagów, do dalszych analiz wykorzystaj ich wartości medianowe.
Wyniki
MPRA umożliwia wysokorozdzielczą, ilościową analizę zależności między sekwencją a aktywnością elementów regulacyjnych transkrypcji. Pomyślnie przeprowadzony eksperyment MPRA zazwyczaj dostarcza wysoce powtarzalnych pomiarów dla większości sekwencji w bibliotece poddanej transfekcji (Rysunek 3A). W przypadku zaobserwowania niskiej powtarzalności (Rysunek 3B), wskazuje to na zbyt niskie stężenie mRNA reporterowego w odzyskanych próbkach RNA, co wynika albo z 1) niskiej aktywności absolutnej badanych sekwencji, albo z 2) niskiej wydajności transfekcji.
Rysunek 4 przedstawia reprezentatywny „ślad informacyjny”1,2 wygenerowany poprzez analizę ~37 000 losowych wariantów 145 pb sekwencji powyżej genu IFNB u ludzi w komórkach HEK293 z ekspozycją lub bez ekspozycji na wirus Sendai. Pudełko TATA promotora oraz znany enhancer proksymalny10 mogą zostać wyraźnie zidentyfikowane jako regiony bogate w informacje w sposób zależny od wirusa.
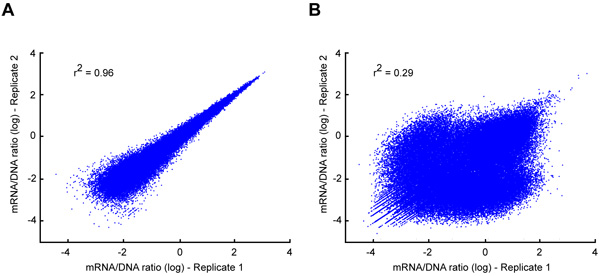
Rycina 3. Powtarzalność metody Tag-Seq. Wykresy rozrzutu przedstawiające przykłady danych Tag-Seq z dwóch niezależnych powtórzeń transfekcji o wysokiej (A) i niskiej (B) powtarzalności. Ten drugi wykres pokazuje wiele odstających tagów z wysoką liczbą cząsteczek mRNA tylko w jednym z dwóch powtórzeń. Takie artefakty zazwyczaj wskazują, że stężenia reporterowych mRNA były zbyt niskie dla amplifikacji metodą quantitative PCR, co wynikało albo z niskiej bezwzględnej aktywności konstruktów reporterowych, albo z niskiej wydajności transfekcji.
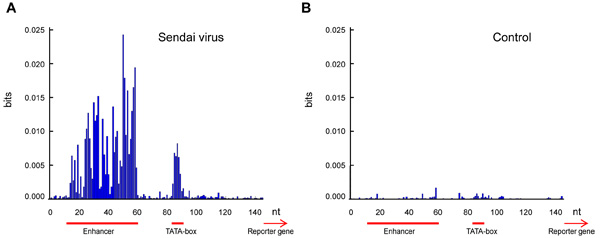
Rysunek 4. Mapowanie informacji (information footprinting) ludzkiego miejsca inicjacji transkrypcji i proksymalnego enhancera IFNB. Około 37 000 losowych wariantów regionu o długości 145 nukleotydów (nt) znajdującego się powyżej ludzkiego genu IFNB zostało przebadanych za pomocą MPRA w komórkach HEK293 z (A) i bez (B) ekspozycji na wirusa Sendai. Niebieskie słupki przedstawiają wzajemną informację między sygnałem reporterowym a nukleotydem w każdej pozycji. Proksymalny enhancer i pudełko TATA wyróżniają się jako regiony o wysokiej zawartości informacji po infekcji wirusowej.
Dyskusja
MPRA jest elastycznym i potężnym narzędziem do analizy zależności sekwencja-aktywność w elementach regulatorowych genów. Powodzenie eksperymentów MPRA zależy od co najmniej trzech czynników: 1) starannego zaprojektowania biblioteki sekwencji, 2) minimalizacji artefaktów podczas amplifikacji i klonowania oraz 3) wysokiej wydajności transfekcji.
Możliwe długości regionów zmiennych w konstrukcjach reporterowych są w dużej mierze determinowane przez zastosowaną technologię syntezy lub klonowania. Standardowy OLS jest generalnie ograniczony do około 200 nt, ale ten protokół jest kompatybilny z wkładkami do co najmniej 1,000 nt. Należy pamiętać, że regiony zmiennych, które są wysoce powtarzalne lub zawierają silne struktury drugorzędowe, mogą być niedostatecznie reprezentowane z powodu błędów PCR i klonowania. Długość znaczników identyfikujących każdy z regionów zmiennych powinna wynosić 10-20 nt, a zbiór znaczników powinien być idealnie zaprojektowany tak, aby istniały co najmniej dwie różnice nukleotydów między dowolną parą. Jeśli to możliwe, należy również unikać znaczników zawierających sekwencje zarodkowe znanego mikroRNA lub inne czynniki, które mogą wpływać na stabilność mRNA.
Kluczowym parametrem w projektowaniu eksperymentów MPRA jest całkowita liczba odrębnych konstrukcji reporterowych, które mają być zawarte w bibliotece (złożoność projektu, oznaczona jako C, D). W praktyce CD jest ograniczony liczbą hodowanych komórek, które można transfekować. Z reguły całkowita liczba transfekowanych komórek powinna być co najmniej 50-100 razy większa niż CD. Na przykład, jeśli można transfekować 20 milionów komórek z wydajnością transfekcji 50%, to CD nie powinno przekraczać ~200 000. Należy zauważyć, że CD jest równe liczbie odrębnych wariantów sekwencji regulatorowej pomnożonej przez liczbę odrębnych znaczników na sekwencję. Im więcej odrębnych znaczników jest powiązanych z każdą sekwencją regulatorową, tym dokładniej można oszacować aktywność tej sekwencji (ponieważ pomiary z różnych znaczników można uśrednić), ale tym mniej odrębnych wariantów można oznaczyć w jednym eksperymencie. Optymalny wybór zależy od projektu eksperymentalnego. W prostym eksperymencie "nagonka na promotora", w którym model matematyczny zostanie dopasowany do zagregowanych pomiarów, zwykle wystarcza jeden tag na wariant. W badaniu przesiewowym pod kątem polimorfizmów pojedynczego nukleotydu, które powodują zmiany w działaniach regulacyjnych, może być konieczne użycie 20 lub więcej znaczników na allel, aby uzyskać statystycznie solidne wyniki, ponieważ porównanie każdej pary alleli wymaga oddzielnego testu hipotezy.
Jeśli oczekuje się, że sekwencje, które mają być badane, nie zawierają miejsc początkowych transkrypcji, w tym samym fragmencie można również dodać stały promotor. Na przykład pMPRAdonor2 (Addgene ID 49353) zawiera minimalny promotor TATA-box, który jest przydatny, gdy oczekuje się, że region zmiennej nadrzędnej będzie miał znaczącą aktywność wzmacniającą, podczas gdy pMPRAdonor3 (Addgene ID 49354) zawiera zmodyfikowany, silny promotor wirusa SV40, który jest przydatny, gdy oczekuje się, że region zmienny będzie zawierał aktywność tłumika lub inne negatywne elementy regulatorowe.
Surowe produkty OLS często zawierają znaczną frakcję skróconych oligonukleotydów. Mogą one zakłócać dokładną amplifikację PCR zaprojektowanych sekwencji, szczególnie gdy występuje między nimi znaczna homologia. Stosowanie oczyszczania PAGE w celu usunięcia skróconych produktów syntezy i emulsji PCR w celu zminimalizowania artefaktów amplifikacji są skutecznymi technikami zapewniającymi wysoką jakość biblioteki. Jeśli którykolwiek z tych kroków jest niepraktyczny, konieczne jest zminimalizowanie liczby cykli PCR stosowanych na każdym etapie amplifikacji. Selekcja i rozszerzenie sklonowanej biblioteki w hodowli płynnej jest na ogół wystarczające do utrzymania złożoności projektu, ale jeśli mają być użyte wektory podatne na rekombinację lub zaobserwowane jest znaczne odchylenie reprezentacji, odzyskane komórki można zamiast tego posiać bezpośrednio na dużych płytkach agarowych LB, namnażać jako pojedyncze kolonie, a następnie zeskrobać w celu izolacji DNA. Ważne jest również, aby wziąć pod uwagę potencjalny wpływ błędów syntezy, które zwykle występują z częstotliwością 1:100-500 w OLS. Zaleca się pełne sekwencjonowanie konstrukcji reporterowych przed transfekcją w celu zidentyfikowania i skorygowania takich błędów.
Nie jest konieczne wprowadzanie konstruktów reporterowych do każdej komórki w transfekowanej hodowli, ale wydajność transfekcji poniżej ~50% może prowadzić do słabych stosunków sygnału do szumu. Zaleca się optymalizację warunków transfekcji przed wykonaniem eksperymentów MPRA na nowym typie komórki. Podczas pracy z trudnymi do transfekcji typami komórek, sygnały MPRA mogą być wzmacniane poprzez wstępną selekcję transfekowanych komórek. Seria wektorów pMPRA obejmuje warianty, które konstytutywnie wyrażają marker skróconej powierzchni komórki, który można wykorzystać do fizycznego wzbogacenia transfekowanych komórek przed izolacją RNA (na przykład identyfikatory Addgene 49350 i 49351).
Oświadczenia
Autorzy oświadczają, że nie mają konkurencyjnych interesów finansowych.
Podziękowania
Ta praca była wspierana przez National Human Genome Research Institute of the National Institutes of Health pod numerem nagrody R01HG006785.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Synteza biblioteki oligonukleotydów | Agilent, CustomArray lub inni dostawcy OLS | niestandardowi | W przypadku korzystania z metody budowy OLS |
| pMPRA1 | Addgene | 49349 | Szkielet plazmidu |
| MPRA pMPRAdonor1 | Addgene | 49352 | luc2 Plazmid dawcy |
| ORF Bufor TE 0.1 (10 mM Tris-HCl, 0,1 mM EDTA, pH 8.0) | Ogólny | brak buforu OLS | |
| Novex Żele mocznikowe TBE, 10% | Life Technologies | EC6875BOX | PAGE oczyszczanie produktów OLS |
| Novex TBA-Sample Sample | Buffer Life Technologies | LC6876 | PAGE oczyszczanie produktów OLS |
| SYBR Gold Nucleic Acid Gel Stain | Life Technologies | S-11494 | PAGE oczyszczanie produktów OLS |
| Micellula DNA Emulsja & Zestaw do oczyszczania | EURx/CHIMERx | 3600-01 | Biblioteka amplifikacja za pomocą emulsji PCR |
| Herculase II Fusion DNA Polymerase | Agilent | 600675 | Polimeraza do emulsji PCR |
| SfiI | New England Biolabs | R0123S | Klonowanie biblioteki za pomocą wektorów pMPRA |
| KpnI-HF | New England Biolabs | R3142S | Klonowanie biblioteki za pomocą wektorów pMPRA |
| XbaI | Nowość Anglia Biolabs | R0145S | Klonowanie biblioteki za pomocą wektorów pMPRA |
| Ligaza DNA T4 (2 000 000 jednostek / ml) | New England Biolabs | M0202T | Klonowanie biblioteki za pomocą wektorów pMPRA |
| One Shot TOP10 Electrocomp E. coli | Life Technologies | C4040-50 | Klonowanie biblioteki za pomocą wektorów pMPRA |
| Agar LB i płynne podłoża z karbenikliną | Generyczny | brak | Podłoża wzrostowe dla klonowanie |
| E-Gel EX Gels 1% | Life Technologies | G4010-01 | Weryfikacja i oczyszczanie biblioteki |
| E-Gel EX Gels, 2% | Life Technologies | G4010-02 | Weryfikacja i oczyszczanie biblioteki |
| Zestaw do ekstrakcji żelu MinElute | Qiagen | 28604 | Biblioteka i oczyszczanie kręgosłupa |
| EndoFree Plasmid Maxi Kit | Qiagen | 12362 | Biblioteka Izolacja DNA |
| Pożywka do hodowli komórkowych | nie dotyczy | Nie dotyczy | Odczynniki |
| do transfekcji | nie | dotyczy | Specyficzny dla eksperymentu |
| zestaw MicroPoly(A)Purist Life | Technologies Izolacja | mRNA | AM1919 |
| Zestaw TURBO bez DNA Technologie | życia | AM1907 | Usuwanie plazmidowego DNA |
| SuperScript III System syntezy pierwszej nici | Życie systemu syntezy Technologie | 18080-051 | synteza cDNA |
| PfuUltra II Hotstart PCR Master Mix | Agilent | 600850 | Polimeraza do starterów Tag-Seq PCR |
| (patrz tekst) | IDT niestandardowa | STRONA oczyszcza startery Tag-Seq |
Bibliografia
- Kinney, J., Murugan, A., Callan, C. G., Cox, E. C. Using deep sequencing to characterize the biophysical mechanism of a transcriptional regulatory sequence. Proceedings of the National Academy of Sciences USA. 107 (20), 9158-9163 (2010).
- Melnikov, A., et al. Systematic dissection and optimization of inducible enhancers in human cells using a massively parallel reporter assay. Nature Biotechnology. 30 (3), 271-277 (2012).
- Patwardhan, R. P., Lee, C., Litvin, O., Young, D. L., Pe’er, D., Shendure, J. High-resolution analysis of DNA regulatory elements by synthetic saturation mutagenesis. Nature Biotechnology. 27 (12), 1173-1175 (2009).
- Patwardhan, R. P., et al. Massively parallel functional dissection of mammalian enhancers in vivo. Nature Biotechnology. 30 (3), 265-270 (2012).
- Arnold, C. D., Gerlach, D., Stelzer, C., Boryń, ŁM., Rath, M., Stark, A. Genome-wide quantitative enhancer activity maps identified by STARR-seq. Science (New York, N. Y.). 339 (6123), 1074-1077 (2013).
- Kheradpour, P., et al. Systematic dissection of regulatory motifs in 2000 predicted human enhancers using a massively parallel reporter assay. Genome Research. 23 (5), 800-811 (2013).
- White, M. A., Myers, C. A., Corbo, J. C., Cohen, B. A. Massively parallel in vivo enhancer assay reveals that highly local features determine the cis -regulatory function of ChIP-seq peaks. Proceedings of the National Academy of Sciences USA. 110 (29), 11952-11957 (2013).
- Mogno, I., Kwasnieski, J. C., Cohen, B. A. Massively parallel synthetic promoter assays reveal the in vivo effects of binding site variants. Genome Research. 23 (11), 1908-1915 (2013).
- Schütze, T., et al. A streamlined protocol for emulsion polymerase chain reaction and subsequent purification. Analytical Biochemistry. 410 (1), 155-157 (2011).
- Panne, D., Maniatis, T., Harrison, S. C. An atomic model of the interferon-beta enhanceosome. Cell. 129 (6), 1111-1123 (2007).
Przedruki i uprawnienia
Sprostowanie
Formal Correction: Erratum: Massively Parallel Reporter Assays in Cultured Mammalian Cells
Posted by JoVE Editors on 3/01/2015. Citeable Link.
null
Przeglądaj więcej artykułów
