Tutaj prezentujemy szczegółowy protokół (A) identyfikacji naturalnego produktu o aktywności antybiotykowej, (B) oczyszczania związku, (C) pierwszego modelu jego biosyntezy, (D) sekwencjonowania/-eksploracji genomu oraz (E) weryfikacji klastra genów biosyntetycznych.
Artykuł metodologiczny
Od produktu naturalnego do klastra genów biosyntezy: demonstracja z użyciem poliketomycyny ze Streptomyces diastatochromogenes Tü6028
W tym artykule
Podsumowanie
Streszczenie
Szczepy Streptomyces są znane ze swojej zdolności do wytwarzania wielu różnych związków o różnej bioaktywności. Uprawa w różnych warunkach często prowadzi do produkcji nowych związków. W związku z tym kultury produkcyjne szczepów są ekstrahowane octanem etylu, a surowe ekstrakty są analizowane za pomocą HPLC. Ponadto ekstrakty są testowane pod kątem bioaktywności za pomocą różnych testów. W celu wyjaśnienia struktury interesujący nas związek jest oczyszczany przez kombinację różnych metod chromatograficznych.
Sekwencjonowanie genomu w połączeniu z eksploracją genomu pozwala na identyfikację klastra genów biosyntezy produktu naturalnego za pomocą różnych programów komputerowych. Aby potwierdzić, że zidentyfikowano właściwy klaster genów, należy przeprowadzić eksperymenty z inaktywacją genów. Powstałe mutanty są analizowane pod kątem produkcji konkretnego produktu naturalnego. Po inaktywacji prawidłowego klastra genów szczep powinien nie wytwarzać związku.
Przebieg pracy jest pokazany dla przeciwbakteryjnego związku poliketomycyny produkowanego przez Streptomyces diastatochromogenes Tü6028. Około dziesięć lat temu, kiedy sekwencjonowanie genomu było jeszcze bardzo drogie, klonowanie i identyfikacja klastra genów była bardzo czasochłonnym procesem. Szybkie sekwencjonowanie genomu w połączeniu z eksploracją genomu przyspiesza próby identyfikacji klastrów i otwiera nowe możliwości badania biosyntezy i generowania nowych produktów naturalnych metodami genetycznymi. Protokół opisany w tej pracy można przypisać do dowolnego innego związku pochodzącego ze szczepu Streptomyces lub innego mikroorganizmu.
Wprowadzenie
Naturalne produkty z roślin i mikroorganizmów zawsze były ważnym źródłem dla rozwoju klinicznego leków i badań. Pierwszy antybiotyk penicylina został odkryty w 1928 roku z grzyba przez Alexandra Fleminga1. Obecnie w leczeniu klinicznym stosuje się o wiele więcej naturalnych produktów.
Jednym z rodzajów znanych ze swojej zdolności do wytwarzania różnego rodzaju metabolitów wtórnych o różnej bioaktywności jest Streptomyces. Streptomyces są bakteriami Gram-dodatnimi i należą do klasy Actinobacteria i rzędu Actinomycetales. Prawie dwie trzecie klinicznie stosowanych antybiotyków pochodzi z promieniowców, głównie ze Streptomyces, takich jak amfoterycyna2, daptomycyna3 lub tetracyklina4. Przyznano dwie Nagrody Nobla w dziedzinie badań nad antybiotykami Streptomyces. Pierwsza z nich trafiła do Selmana Waksmana za odkrycie Streptomycyny, pierwszego antybiotyku skutecznego przeciwko gruźlicy. 5 W 2015 r., w ramach Nagrody Nobla w dziedzinie fizjologii i medycyny, nagrodzono również odkrycie awermektyny z S. avermittilis. Awermektyna jest stosowana w leczeniu chorób pasożytniczych6,7.
Tradycyjne podejście do odkrywania naturalnych produktów w mikroorganizmach, takich jak Streptomyces, zazwyczaj obejmuje hodowlę szczepu w różnych warunkach wzrostu, a także ekstrakcję i analizę metabolitów wtórnych. Testy bioaktywności (np. testy aktywności przeciwbakteryjnej i przeciwnowotworowej) wykonuje się w celu wykrycia aktywności związku. Na koniec izoluje się interesujący związek i wyjaśnia strukturę chemiczną.
Struktury produktów naturalnych często składają się z pojedynczych ugrupowań, które tworzą złożone cząsteczki. Istnieje kilka, ale ograniczonych, głównych szlaków biosyntezy prowadzących do powstawania bloków budulcowych, które są wykorzystywane do biosyntezy produktów naturalnych. Głównymi szlakami biosyntezy są szlaki poliketydowe, szlaki prowadzące do terpenoidów i alkaloidów, szlaki wykorzystujące aminokwasy oraz szlaki prowadzące do ugrupowań cukrowych. Każdy szlak charakteryzuje się zestawem określonych enzymów8. Na podstawie struktury związku można przewidzieć te enzymy biosyntetyczne.
W dzisiejszych czasach szczegółowa analiza strukturalna związku w połączeniu z sekwencjonowaniem nowej generacji i analizą bioinformatyczną może pomóc w zidentyfikowaniu odpowiedzialnego klastra genów biosyntetycznych. Informacje uzyskane w klastrze otwierają nowe możliwości dalszych badań nad produktami naturalnymi. Obejmuje to ekspresję heterologiczną w celu zwiększenia wydajności produktu naturalnego, ukierunkowaną modyfikację związku poprzez delecję lub zmianę genów oraz biosyntezę kombinatoryczną z genami z innych szlaków.
Poliketomycyna została wyizolowana niezależnie od bulionu hodowlanego dwóch szczepów, Streptomyces sp. MK277-AF19 i Streptomyces diastatochromogenes Tü602810. Struktura została wyjaśniona za pomocą NMR i analizy rentgenowskiej. Poliketomycyna składa się z tetracyklicznego decaketidu i kwasu dimetylosalicylowego, połączonych dwoma ugrupowaniami deoksycukru β-D-amicetozą i α-L-aksenozą. Wykazuje aktywność cytotoksyczną i antybiotyczną, nawet wobec wielolekoopornych szczepów Gram-dodatnich, takich jak MRSA11.
Biblioteka genomiczna kosmidu S. diastatochromogenes Tü6028 została wygenerowana i przebadana wiele lat temu. Za pomocą specyficznych sond genowych po kilku miesiącach intensywnych prac zidentyfikowano klaster genów poliketomycyny o wielkości 52,2 kb, zawierający 41 genów12. Niedawno uzyskano wstępną sekwencję genomu S. diastatochromogenes, co doprowadziło do szybkiej identyfikacji klastra genów biosyntezy poliketomycyny. W tym przeglądzie zostanie opisana metoda pomagająca zidentyfikować produkt naturalny i wyjaśnić jego biosyntetyczny klaster genów na przykładzie poliketomycyny.
Tutaj wyjaśniamy pojedyncze etapy, które prowadzą od produktu naturalnego do jego biosyntetycznego klastra genów, pokazanego dla poliketomycyny produkowanej przez Streptomyces diastatochromogenes Tü6028. Protokół obejmuje identyfikację i oczyszczenie naturalnego produktu o właściwościach antybiotycznych. Dalsza analiza strukturalna i porównanie z wynikami eksploracji genomu prowadzi do identyfikacji klastra genów biosyntetycznych. Procedurę tę można zastosować do każdego innego związku pochodzącego ze szczepu Streptomyces lub dowolnego innego mikroorganizmu.
Protokół
1. Identyfikacja produktu naturalnego o właściwościach antybiotykowych
- Hoduj mikroorganizm w różnych warunkach (np. czas, temperatura, pH, podłoże), stosując podejście „OSMAC (one strain-many compounds)”13. Wybierz jedno podłoże, w którym zaobserwowano produkcję związku.
- Hodowla Streptomyces diastatochromogenes Tü6028 w następujących warunkach
- Hoduj szczep Streptomyces diastatochromogenes Tü6026 na płytkach MS (mączka sojowa 20 g, D-mannitol 20 g, MgCl2 10 mM, agar 1,5%, woda z kranu 1 L). Zaszczep niewielką pętlą zarodników tego szczepu 20 mL płynnego podłoża TSB (bulion sojowy tryptyczny 30 g, woda z kranu 1 L, pH 7,2; podłoże do prekultury) w kolbie Erlenmeyera z magnesem. Inkubuj kolbę na wytrząsarce obrotowej (28 °C, 180 rpm, 2 dni).
- Zaszczep kulturę główną w 10 mL podłoża HA (glukoza 4 g, ekstrakt drożdżowy 4 g, ekstrakt słodowy 10 g, woda z kranu 1 L, pH 7,2) za pomocą 2 mL prekultury. Hoduj szczep w temperaturze 28 °C przez 6 dni na wytrząsarce obrotowej przy 180 rpm.
- Przygotowanie ekstraktu surowego
- Zbierz komórki poprzez wirowanie (10 min, 3 0 x g).
- W kolejnych krokach rozpuszczalniki organiczne obsługuj pod wyciągiem.
- W celu ekstrakcji związku z grzybni, resuspenduj komórki w dwukrotnej objętości acetonu i wytrząsaj w probówce przez 30 min przy 180 rpm. Przefiltruj ciecz przez komercyjny papier filtracyjny i odparuj aceton za pomocą rotacyjnego odparowacza w temperaturze 40 °C i przy 50 bar. Rozpuść ekstrakt w 20 mL mieszaniny woda:octan etylu (1:1) i wytrząsaj w rozdzielaczu przez 30 min przy 180 rpm.
- W celu ekstrakcji związku z podłoża hodowlanego, dostosuj pH bulionu hodowlanego do wartości 4,0 poprzez dodanie 1 M HCl. Dodaj 10 mL octanu etylu i wytrząsaj w rozdzielaczu przez 30 min przy 180 rpm.
- Zbierz fazę octanu etylu i odparuj za pomocą odparowania rotacyjnego w temperaturze 40 °C i przy 240 bar.
- Analiza ekstraktu surowego metodą HPLC
- Rozpuść ekstrakty w 1 mL MeOH, przefiltruj je przez filtr o rozmiarze porów 0,45 µm i przeprowadź wysokosprawną chromatografię cieczową (HPLC)14.
- W przypadku poliketomycyny wyposaż system HPLC w prekolumnę C18 (4,6 x 20 mm2) i kolumnę C18 (4,6 x 10 mm2). Zastosuj gradient liniowy acetonitrylu + 0,5% kwasu octowego od 20% do 95% w H2O + 0,5% kwasu octowego (szybkość przepływu: 0,5 mL min-1).
UWAGA: Poliketomycyna ma czas retencji 25,9 min (patrz Rycina 1A). Widmo UV/vis wykazuje maksima przy 242 nm, 282 nm, 46 nm oraz minima przy 262 nm i 359 nm (patrz Rycina 1B). W trybie negatywnym wykrywalna jest masa 863,2 [M-H]- (patrz Rycina 1C).
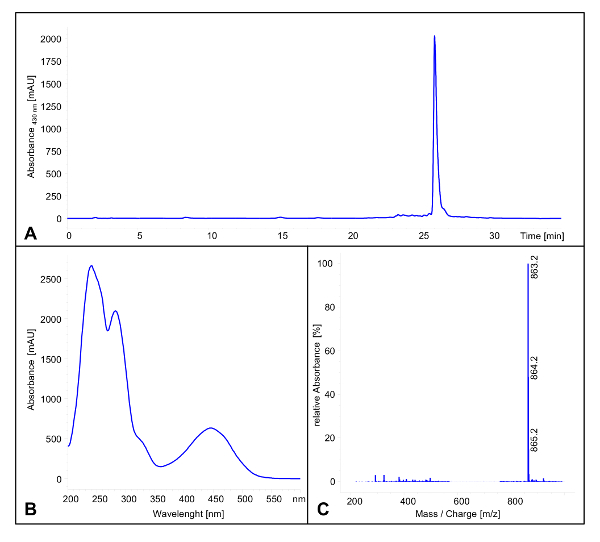
Rysunek 1: Analiza polyketomycyny metodą LC/MS. (A) chromatogram HPLC (λ = 430 nm) ekstraktu surowego po hodowli Streptomyces diastatochromogenes Tü6028 przez 6 dni. Poliketomycyna ma czas retencji 25,9 min (B) Widma UV/vis poliketomycyny. (C) Widma masowe polyketomycyny w trybie negatywnym. Główny pik o m/z 863,2 [M-H]-.Prosimy kliknąć tutaj, aby wyświetlić powiększoną wersję tej ryciny.
- Identyfikacja aktywności antybiotycznej z wykorzystaniem metody dyfuzyjnej z krążkami
- Zaszczepić szczepy testowe, takie jak bakterie Gram-dodatnie Bacillus subtilis (w pożywce LB; LB 20 g, woda z kranu 1 l, pH 7,4) oraz inne Streptomyces szczepy (w medium TSB; bulion sojowo-kazeinowy 30 g, woda z kranu 1 L, pH 7,2), Bakterie Gram-ujemne Escherichia coli (w medium LB) oraz szczepy grzybów (w pożywkach takich jak medium YPD; ekstrakt drożdżowy 10 g, peptona 20 g, glukoza 20 g, woda z kranu 1 l, pH 7,4). Pobrać 100 µL przedkultury szczepu testowego i rozprzestrzenić je na odpowiednich płytkach agarowych.
- Rozpuścić ekstrakt surowy lub oczyszczony związek w 500 µL metanolu (alternatywnie wody lub DMSO) i pipetować 20-50 µL na sterylne papierowe krążki. Suszyć krążki przez 30 min pod dygestorium, a następnie nałożyć je na płytki z kulturami testowymi. Przygotować kontrolę negatywną (rozpuszczalnik) oraz kontrolę pozytywną (antybiotyk, np. apramycyna [1 mg]).
- Inkubować płytki w odpowiednich warunkach do momentu widocznego wzrostu szczepów testowych, a następnie wyznaczyć strefę zahamowania, jeśli jest ona widoczna. Inkubować E. coli i Bacillus gat. na 37 °C przez 16 h, Streptomyces sp. at 28 °C przez 2–4 dni, szczep grzyba (zależnie głównie od konkretnego badanego szczepu) w 30 °C przez 2 dni).
2. Ekstrakcja na dużą skalę, oczyszczanie i wyznaczanie struktury związku
- Hodowlę S. diastatochromogenes prowadzić w 5 L pożywki HA (glukoza 4 g, ekstrakt drożdżowy 4 g, ekstrakt słodowy 10 g, woda z kranu 1 L, pH 7.2). 2 mL prekultury zaszczepić do 30 kolb Erlenmeyera o pojemności 50 mL zawierających 150 mL pożywki HA. Szczep inkubować przez 6 dni w temperaturze 28 °C na wytrząsarku orbitalnym przy 180 rpm.
- Komórki zebrać za pomocą wirowania (10 min, 15,00 x g, RT), a następnie ekstrahować związki przy użyciu octanu etylu (patrz sekcja 1.3).
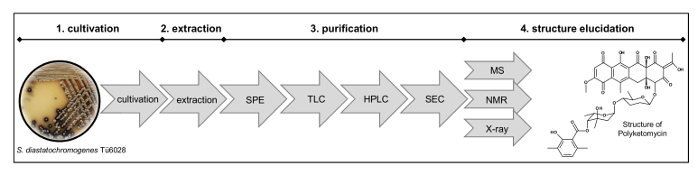
Rysunek 2: Schemat procesu wyjaśniania struktury. Proces obejmuje (1) hodowlę szczepu, (2) ekstrakcję, (3) oczyszczanie za pomocą ekstrakcji do fazy stałej (SPE), chromatografii warstwowej (TLC), preparatywnej wysokosprawnej chromatografii cieczowej (HPLC), chromatografii wykluczania cząsteczkowego (SEC) oraz (4) ustalenie struktury za pomocą analizy masowej (MS), magnetycznego rezonansu jądrowego (NMR) i pomiarów rentgenowskich. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
- Oczyszczanie poliketomycyny
UWAGA: Proces oczyszczania i wyznaczania struktury przedstawiono na Rysunku 2.- Przeprowadzić frakcjonowanie surowego ekstraktu przy użyciu kolumny do ekstrakcji w fazie stałej (SPE) C18, stosując gradient MeOH w H2O zwiększany w krokach 10% w zakresie od 30% do 10% MeOH, przy objętości 10 mL dla każdego stopnia gradientu.
- Dalsze oczyszczanie frakcji zawierającej związek należy przeprowadzić za pomocą preparatywnej chromatografii cienkowarstwowej (TLC)15, stosując układ elucyjny CH2Cl2/MeOH (7:1).
- Związek oczyścić za pomocą preparatywnego HPLC16. System HPLC wyposażyć w przedkolumnę C18 (5 µm; 9,4 x 20 mm) oraz kolumnę główną (5 µm; 9,4 x 150 mm). Zastosować gradient acetonitrylu + 0,5% kwasu octowego w zakresie od 20% do 95% w H2O + 0,5% kwasu octowego (przepływ: 2,0 mL/min).
- W celu usunięcia rozpuszczalników i innych niewielkich zanieczyszczeń przeprowadzić ostatni etap oczyszczania za pomocą chromatografii żelowej w MeOH17. Zebrać końcowy czysty związek i odparować MeOH za pomocą ewaporatora obrotowego w temperaturze 40 °C i ciśnieniu 240 bar.
- Wyznaczanie struktury
- Rozpuścić czysty związek (powyżej 2 mg) w 60-70 µL (zależnie od urządzenia) DMSO-d6 i zarejestrować widma 1D NMR (1H, 13C) oraz 2D NMR (HSQC, HMBC, 1H-1H COSY) na spektrometrze NMR18. Przesunięcia chemiczne wyrazić jako wartości δ (ppm) w odniesieniu do DMSO-d6.
- Zarejestrować wysokorozdzielcze widmo masowe (HRESI-MS)19 poliketomycyny przy użyciu spektrometru mas wysokiej rozdzielczości.
- Wyznaczyć strukturę na podstawie interpretacji wyników analizy danych NMR i MS10.
3. Zaproponowanie modelu biosyntezy nowego wyizolowanego związku
- Przeanalizuj strukturę wyizolowanego związku i przewidź enzymy, które mogą brać udział w jego biosyntezie. Przypisz je do szlaku syntezy poliketydów (typ I, II lub III), peptydów nierybosomalnych, lantipeptydów, terpenoidów lub metabolizmu cukrów8.
- Przykład poliketomycyny
- Podziel strukturę na wyraźne pojedyncze fragmenty: fragment tetracykliczny, dwa monosacharydy oraz kwas dimetylosalicylowy.
- Ustal, z czego mogą pochodzić poszczególne fragmenty: fragment tetracykliczny może pochodzić z syntazy poliketydowej typu II, a fragment kwasu dimetylosalicylowego może być pochodną iteracyjnej syntazy poliketydowej typu I. Dwie jednostki cukrowe, będące 6-deoksycukrami, mogą być syntetyzowane z glukozy z udziałem TDP-glukozo-4,6-dehydratazy podczas biosyntezy i przyłączone prawdopodobnie przez dwie glikozylotransferazy (patrz Rysunek 3)8.
- Przewiduj domniemane geny w klastrze. Rozważ enzymy uczestniczące w syntezie pojedynczych fragmentów, łączeniu jednostek, a także w modyfikacji i dopracowywaniu cząsteczki. Klaster genów biosyntezy poliketomycyny najprawdopodobniej zawiera geny kodujące syntazę poliketydową typu II (zatem minimum ACP, KSα i KSβ do łączenia jednostek przedłużających), iteracyjną syntazę poliketydową typu I (przynajmniej ACP, AT, KS), TDP-glukozo-4,6-dehydratazę (niezbędną do etapu: glukoza → deoksyglukoza) oraz dwie glikozylotransferazy (przyłączające dwa monomery cukrowe do aglikonu)8.
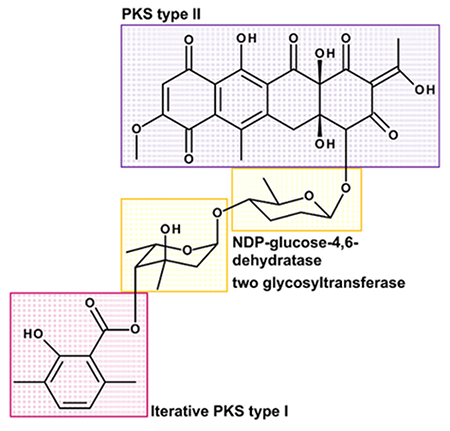
Rycina 3: Struktura poliketomycyny podzielona na pojedyncze bloki budulcowe. Poliketomycyna składa się z tetracyklicznego dekaketydy (PKS typu II) oraz kwasu dimetylosalicylowego (iteratywny PKS typu I), połączonych dwiema cząsteczkami deoxycukrów: β-D-amicetozą i α-L-aksenozą (wymagana NDP-glukoza-4,6-dehydrataza oraz dwie glikozylotransferazy). Proszę kliknąć tutaj, aby wyświetlić powiększoną wersję tej ryciny.
4. Sekwencjonowanie/Analiza genomu
- Sekwencjonowanie następnej generacji
- Przeprowadzić sekwencjonowanie genomowego DNA przy użyciu technologii sekwencjonowania następnej generacji, takich jak Illumina, pirosekwencjonowanie 454 lub SOLiD20. Przyporządkować pojedyncze odczyty do sekwencji referencyjnej lub złożyć je de novo.
UWAGA: Genom S. diastatochromogenes Tü6028 został zsekwencjonowany w Centrum Biotechnologii (CeBiTec) na Uniwersytecie w Bielefeld. Wszystkie odczyty zostały złożone w roboczy genom o wielkości 7,9 Mb.
- Przeprowadzić sekwencjonowanie genomowego DNA przy użyciu technologii sekwencjonowania następnej generacji, takich jak Illumina, pirosekwencjonowanie 454 lub SOLiD20. Przyporządkować pojedyncze odczyty do sekwencji referencyjnej lub złożyć je de novo.
- Genome mining (Przeszukiwanie genomu)
- Wyszukać otwarte ramki odczytu (ORF) przy użyciu np. NCBI Prokaryotic Genome Annotation Pipeline21,2, RAST (rapid annotation using subsystem technology)23,24,25, Prokka (rapid prokaryotic genome annotation)26 lub GenDB27. Programy te proponują również przypisanie funkcji. Analiza sekwencji roboczego genomu S. diastatochromogenes Tü6028 doprowadziła do identyfikacji ponad 7 00 ORF.
- Przeprowadzić specyficzną analizę BLAST (Basic Local Alignment Search Tool), aby uzyskać więcej informacji, takich jak dopasowania do innych podobnych genów i domen katalitycznych28,29,30.
- W celu identyfikacji klastrów genów metabolitów wtórnych uruchomić programy takie jak antiSMASH31,32,3, NaPDoS34 oraz NRPSpredictor35,36. W roboczym genomie Streptomyces diastatochromogenes program antiSMASH31,32,3 zidentyfikował 2 klastry genów.
- Przeanalizować domniemane klastry genów pod kątem ich szlaków enzymatycznych (syntaza poliketydów (typ I, II lub III), nie-rybosomalna syntetaza peptydów, lantipeptyd, terpenoid, metabolizm cukrów …). Wyszukać klaster(klastry) zawierające geny, które mogą być zaangażowane w syntezę związku (patrz sekcja 3). W przypadku S. diastatochromogenes adnotowany klaster 2 zawiera geny syntazy poliketydów typu II, trzy geny syntazy poliketydów typu I, gen TDP-glukozo-4,6-dehydratazy i dwa geny glikozylotransferazy (patrz Rysunek 4).
- Skupić się na pojedynczych genach w obrębie klastra. Dla PKS typu I i NRPS można przewidzieć specyficzność acylotransferaz i domen adenylacji, a tym samym wbudowanie pojedynczych jednostek przedłużających. Porównać również kolejność wbudowanych jednostek przedłużających z cząsteczką. antiSMASH31,32,3 wskazuje również podobne klastry już znanych związków, wraz z linkiem do bazy danych MIBiG37.
- Porównać strukturę związku z tymi innymi związkami i sprawdzić podobieństwa.
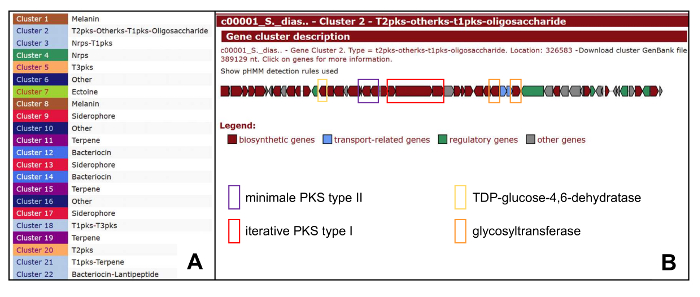
Rysunek 4: Wynik analizy antiSMASH dla klastra genów biosyntezy poliketaminy oraz przegląd pozostałych klastrów w S. diastatochromogenes Tü6028. (A) Przegląd przewidywanych klastrów genów biosyntetycznych w genomie S. diastatochromogenes Tü6028; (B) Klaster 2 Genowy klaster biosyntezy poliketydyny z genami docelowymi. Aby wyświetlić powiększoną wersję tej ryciny, kliknij tutaj.
5. Weryfikacja biosyntetycznego klastra genów
- Wyszukaj gen o oczywistych i istotnych (niezbędnych) funkcjach dla biosyntezy związku. W celu weryfikacji klastra genów poliketydowej wybrano gen pokPI, kodujący ketosyntazę α z PKS typu II, i wyłączono go poprzez delecję out of frame (patrz Rysunek 5B). Alternatywnie można przerwać gen poprzez klonowanie fragmentu wewnętrznego (patrz Rysunek 5C).
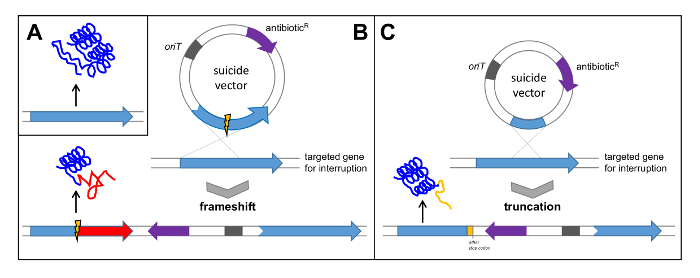
Rysunek 5: Weryfikacja klastra genów za pomocą pojedynczego krośowania. (A) natywny gen prowadzi do translacji funkcjonalnego białka; (B) Klonowanie genu z wewnętrzną delecją do wektora samobójczego prowadzi do pojedynczego zdarzenia rekombinacji (single crossover), co skutkuje przesunięciem ramki odczytu w genie docelowym i następczą translacją niefunkcjonalnego białka; (CKlonowanie wewnętrznego fragmentu genu do wektora samobójczego prowadzi do truncacji genu i późniejszej translacji niefunkcjonalnego białka. oriTmiejsce pochodzenia transferu; antybiotykRoporność na antybiotyki Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
- Klonowanie konstruktu z pojedynczą rekombinacją
- Amplifikuj fragment zawierający pokPI metodą PCR38 z użyciem starterów pokPI_for i pokPI_rev.
- Klonowanie produktu PCR do wektora samobójczego pKC13239 (apramycynaR [50 mg/ml]). Wektor samobójczy nie jest w stanie replikować się w Streptomyces szczep, w związku z czym musi on zintegrować się z docelowym genem poprzez rekombinację homologiczną, aby zapewnić oporność na apronamycynę. Przenieś wektor do *E. coli* klonowanie gospodarza poprzez transformację szokiem termicznym40.
- Izolacja wektora za pomocą lizy alkalicznej41.
- Poddaj DNA wektora trawieniu za pomocą pojedynczego enzymu restrykcyjnego, który tnie w obrębie fragmentu. pokPI gen poddano trawieniu za pomocą enzym KpnI.
- Poddaj trawiony DNA wektora działaniu dużego fragmentu polimerazy DNA I (klenowa), który wykazuje aktywność polimerazy 5'→3' oraz aktywność egzonukleazy 3'→5'. Wyrównanie lepkich końców i następująca po nim religacja prowadzą do utraty czterech zasad. Sprawdź utratę tych zasad poprzez transformację do E. coli XL1 Blue, wybieranie pojedynczych kolonii, izolacja ich plazmidowego DNA,41 oraz analizując dalej za pomocą trawienia restrykcyjnego i sekwencjonowania.
- Koniugacja konstruktu pojedynczego crossover do Streptomyces
- Przenieś wektor samobójczy zawierający pokPI gen (pKC132_pokPIdel) z delecją w E. coli ET12567 pUZ80242 (kanamycyna)R) poprzez transformację szokową (szok termiczny)40Inkubować komórki w 10 ml pożywki LB (kanamycyna 50 µg ml-1, apramycyna 50 µg ml-1) przez noc w temperaturze 37 °C. Zebrać komórki poprzez wirowanie (3 0 x g, 10 min, 4 °C) i przemyć komórki dwukrotnie, resuspendując je w 50 ml pożywki LB. Na koniec resuspender komórki w 2 x 500 µL pożywki LB.
- Wymieszaj 500 µL E. coli pUZ8002 pKC132_pokPIusuń za pomocą 500 µL Streptomyces diastatochromogenes kulturę (alternatywnie przetrwalniki). Rozprzestrzenić mieszaninę na płytkach MS (mąka sojowa 20 g, D-mannitol 20 g, MgCl2 10 mM, agar 1,5%, woda z kranu 1 L). Inkubować płytki przez 20 h w temperaturze 28 °C.
- Na każdą płytkę nanieś warstwę apramicyny (1,25 mg) i fosfomycyny (5 mg) rozpuszczonych w 1 ml wody i pozostaw do wyschnięcia. Inkubuj płytki przez kilka dni w temperaturze 28 °C do momentu pojawienia się widocznych ekskonjugantów.
- Weryfikacja mutantów pojedynczego crossoveru
- Zaszczepić pojedyncze egzokonjuganty w 20 mL pożywki TSB (apramycyna 50 mg mL)-1) i inkubować je w temperaturze 28 °C przez trzy dni przy 180 obr./min.
- Izolacja genomowego DNA43 or sprawdzić przerwanie pokPI gen metodą PCR.
- Zaszczepić pojedyncze klony z potwierdzoną przerwa genowa i Streptomyces szczep typu dzikiego w 10 ml pożywki HA i inkubować przez 6 dni w temperaturze 28 °C i 180 obr./min. Wyodrębnić ekstrakt surowy (patrz sekcja 1.3). Sprawdzić produkcję związku za pomocą analizy HPLC-MS (patrz sekcja 1.4). Odpowiedni pik na chromatogramie HPLC oraz masa związku nie powinny być już wykrywalne (patrz Rycina 6).
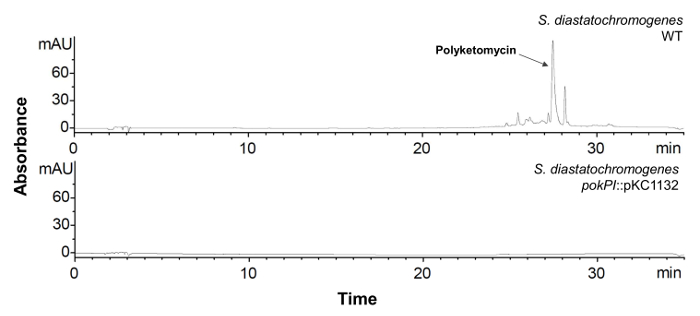
Rysunek 6: Analiza HPLC *S. diastatochromogenes* z inaktywowanym pokPI Gen. Chromatogram HPLC (λ = 430 nm) surowego ekstraktu z S. diastatochromogenes Szczep typu dzikiego (góra) oraz szczep mutant z przerwaniem pokPI-Gen (poniżej). Szczep zmutowany nie produkuje już poliketomycyny. Proszę kliknąć tutaj, aby wyświetlić powiększoną wersję tej figury.
Wyniki
W niniejszym przeglądzie opisujemy poszczególne etapy procesu prowadzącego od identyfikacji antybiotyku do jego biosyntetycznego klastra genów. Wiele lat temu klonowaliśmy bibliotekę kosmidów, pakowaliśmy je do fagów, transdukowaliśmy komórki gospodarza E. coli i musieliśmy przesiewać tysiące kolonii, aby zidentyfikować klony posiadające nakładające się regiony klastra poliketydowej syntezy. Sekwencjonowanie kosmidów było również procesem trudnym i kosztownym12.
W celu przeprowadzenia dalszych badań nad szczepem zsekwencjonowano cały genom Streptomyces diastatochromogenes Tü6028. Dzięki wstępnej sekwencji genomu łatwo zidentyfikowano biosyntetyczny klaster genów poliketomycyny oraz inne klastry kodujące obiecujące związki. Rysunek 7 porównuje „starą” metodę identyfikacji klastra biosyntetycznego poprzez klonowanie biblioteki kosmidów i szczegółowe przesiewanie z „nową” metodą polegającą na sekwencjonowaniu całego genomu i następnym przeszukiwaniu genomu (genome mining) w ujęciu czasowym. Nowe technologie sekwencjonowania oraz nowe programy do przeszukiwania genomu przyspieszają cały ten proces.
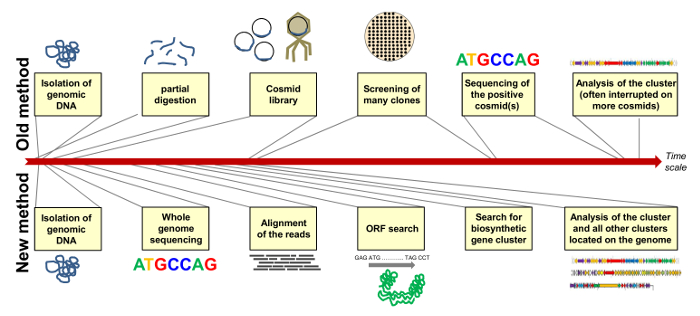
Rysunek 7: Porównanie „starej” i „nowej” metody przypisywania biosyntetycznego klastra genów. Metoda „stara” obejmuje klonowanie biblioteki kosmidów z selekcją klonów pozytywnych i sekwencjonowaniem odpowiedniego kosmidu lub kosmidów (powyżej); metoda „nowa” obejmuje sekwencjonowanie i analizę całego genomu (genome mining) w celu zidentyfikowania wszystkich klastrów genów metabolitów wtórnych zlokalizowanych w genomie szczepu (poniżej). Czas trwania poszczególnych etapów przedstawiono na przybliżonej skali czasowej. Prosimy kliknąć tutaj, aby wyświetlić większą wersję tej ryciny.
Dyskusja
W tym laboratorium wiele lat temu stworzono i przebadano genomową bibliotekę kosmidową Streptomyces diastatochromogenes , co zaowocowało identyfikacją klastra genów poliketomycyny w niezwykle czasochłonnym procesie. Charakterystyka pojedynczych genów była możliwa przy użyciu celowanych delecji genów i analizy powstałych mutantów12. Niedawno uzyskano wstępną sekwencję genomu S. diastatochromogenes , która pozwoliła na szybką identyfikację klastra genów biosyntezy poliketomycyny. Mogliśmy łatwo wykryć geny biosyntezy, chociaż szkic sekwencji genomu zawiera nadal wiele kontigów. Opisany proces można osiągnąć w ciągu kilku miesięcy. Procedura składa się jednak z wielu etapów. Pojedyncze kroki mogą zakończyć się niepowodzeniem kilka razy, uniemożliwiając przejście do kolejnych kroków:
Rodzaj Streptomyces znany jest ze swojej zdolności do wytwarzania związków bioaktywnych. Chociaż często zawierają więcej niż 20 klastrów genów biosyntetycznych, zwykle tylko jeden lub dwa związki są wytwarzane w warunkach laboratoryjnych. Zastosowanie podejścia OSMAC (hodowla jednego szczepu w różnych warunkach) w celu wybudzenia cichych klastrów genów może czasami nie wystarczyć. Genetyczna manipulacja genami regulatorowymi, takimi jak plejotropowe geny regulatorowe adpA44 i bldA45,46, jest również skuteczną metodą aktywacji produkcji innych metabolitów wtórnych.
Do wyjaśnienia struktury związku, np. za pomocą analizy NMR, zwykle konieczne jest więcej niż 2 mg oczyszczonego związku. Dlatego często wymagana jest fermentacja więcej niż 10 litrów kultury. Bez fermentora, który jest w stanie utrzymać tlen, pH i temperaturę, w małym laboratorium może być trudno poradzić sobie z taką ilością kultury i późniejszą ekstrakcją. Podczas oczyszczania związek może ulec zmianie pod wpływem utleniania, promieniowania lub temperatury. Ponadto, im więcej etapów oczyszczania zostanie zastosowanych, tym większa szansa na degradację.
Analizując strukturę produktu naturalnego i klastry w genomie, czasami nie jest tak łatwo zidentyfikować odpowiedni klaster. Po pierwsze, jeśli istnieje tylko szkic sekwencji genomu, może brakować jakiejś części klastra. Po drugie, nie wszystkie geny, które są niezbędne do biosyntezy, znajdują się w klastrze. Po trzecie, czasami klaster jest podzielony na dwie części oddzielone od siebie wieloma kilozasadami. Po czwarte, może być trudno zdecydować, który z nich jest odpowiednim klastrem genów. W przypadku dużych systemów PKS typu I lub NRPS, gdzie możliwe jest obliczenie liczby jednostek przedłużacza na podstawie liczby modułów, a nawet identyfikacja pojedynczych jednostek przedłużacza na podstawie analizy wybranych domen, łatwo się to sprawdza. Jednak w przypadku iteracyjnie działających enzymów przewidywanie zsyntetyzowanych związków często nie jest możliwe, zwłaszcza jeśli szczep ma więcej niż 40 klastrów genów. Po piąte, natura jest bardzo złożona i pełna nieznanych jeszcze związków. Często biosynteza jest mieszaniną różnych szlaków. Jeśli nowy związek nie został jeszcze zidentyfikowany lub nie jest spokrewniony z innym związkiem, może być trudno zidentyfikować klaster, zaproponować model biosyntezy i go udowodnić.
Po zidentyfikowaniu klastra technika pojedynczego skrzyżowania jest dobrą i szybką metodą weryfikacji hipotezy. PCR, klonowanie do wektora samobójczego, koniugacja, selekcja pozytywnych klonów i test produkcyjny to jedyne wymagane kroki. Jedną z wad tej techniki jest to, że integracja wektora z chromosomem nie jest stabilna z powodu dalszych zdarzeń rekombinacji. Dlatego, aby dalej analizować pojedyncze geny, wymagane są precyzyjne delecje genów. Również manipulowanie szczepami Streptomyces na poziomie genetycznym może być trudne.
Opisaną procedurę można przypisać do dowolnego innego związku wytwarzanego przez szczep Streptomyces lub inny mikroorganizm. Wiedza na temat biosyntetycznego klastra genów i jego syntetyzowanego związku daje nam kolejne możliwości modyfikacji już istniejących cząsteczek w celu ich udoskonalenia do walki z patogenami wielolekoopornymi.
Oświadczenia
Autorzy nie mają nic do ujawnienia.
Podziękowania
S. Zhang jest finansowany przez Chińską Radę Stypendialną. Autorzy są bardzo wdzięczni byłym osobom pracującym nad projektem poliketomycyny w tym laboratorium oraz prof. dr Hans-Peter Fiedler z Uniwersytetu w Tybindze za dostarczenie producenta poliketomycyny. Badania były wspierane przez DFG (RTG 1976).
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| agar | Carl Roth GmbH + Co. KG, Karlsruhe, Niemcy | 5210.4 | |
| agaroza | Carl Roth GmbH + Co. KG, Karlsruhe, Niemcy | 6352.4 | |
| D-mannitol | Carl Roth GmbH + Co. KG, Karlsruhe, Niemcy | 4175.1 | |
| glukoza | Carl Roth GmbH + Co. KG, Karlsruhe, Niemcy | 6780.1 | |
| LB | Carl Roth GmbH + Co. KG, Karlsruhe, Niemcy | X964.3 | |
| ekstrakt słodowy | Carl Roth GmbH + Co. KG, Karlsruhe, Niemcy | X976.2 | |
| MgCl2 | Carl Roth GmbH + Co. KG, Karlsruhe, Niemcy | 2189.1 | |
| Pepton | Carl Roth GmbH + Co. KG, Karlsruhe, Niemcy | ||
| mąka sojowa | W.Schoenemberger GmbH, Magstadt, Niemcy | Hensec-Vollsoja | |
| tryptyczny bulion sojowy | Carl Roth GmbH + Co. KG, Karlsruhe, Niemcy | X938.3 | Caso-Bouillon |
| Carl Roth GmbH + Co. KG, Karlsruhe, Niemcy | 2363.2 | ||
| Rozpuszczalniki | |||
| Kwas octowy | Carl Roth GmbH + Co. KG, Karlsruhe, Niemcy | 3738.5 | |
| Aceton | Carl Roth GmbH + Co. KG, Karlsruhe, Niemcy | 9372.2 | |
| Acetonitrile | Avantor Performance Materials B.V., Deventer, Holandia | JT-9012-03 | |
| Dichlorofrom | Fisher Scientific GmbH, Schwerte, Niemcy | 1530754 | |
| DMSO (sulcotlenek dimetylu) | Carl Roth GmbH + Co. KG, Karlsruhe, Niemcy | 4720.1 | |
| DMSO-d6 (dimetylosulfotlenek-d6) 99,9 atom% D | ARMAR Chemicals, Dö ttingen, Szwajcaria | 15200.204 | |
| Octan etylu | Carl Roth GmbH + Co. KG, Karlsruhe, Niemcy | 6784.4 | |
| Kwas solny | Carl Roth GmbH + Co. KG, Karlsruhe, Niemcy | 6331.4 | |
| Metanol | Carl Roth GmbH + Co. KG, Karlsruhe, Niemcy | 7342.1 | |
| Enzymes | |||
| enzymy restrykcyjne | New England Biolabs GmbH, Frankfurt nad Menem, Niemcy | ||
| polimeraza | New England Biolabs GmbH, Frankfurt nad Menem, Niemcy | ||
| Polimeraza DNA I Duży (Klenow) Fragment | Promega GmbH, Mannheim, Niemcy | ||
| Antybiotyki | |||
| apramycyna | AppliChem GmbH, Darmstadt, Niemcy | A7682.0005 | |
| fosfomycyna | Sigma-Aldrich Chemie GmbH, Taufkirchen, Niemcy | P5396-50G | |
| kanamycyna | Carl Roth GmbH + Co. KG, Karlsruhe, Niemcy | T832.2 | |
| Plasmid/Vectors | |||
| pKC1132 | Bierman et al. 1992 | ||
| Primer& nbsp; | |||
| pokPI_for | TGATGGTGCCGCTGGCCATGG | Podkład do amplifikacji fragmentu zawierającego gen | |
| pokPI_rev | AGCGTTCACTGTTCCGCCCGAC | ||
| szczepy bakteryjne | |||
| Bacillus subtilis COHN ATCC6051 | Szczep testowy Gram-dodatni | ||
| Escherichia coli ET12567 pUZ8002 | MacNeil et al. 1992 | szczep do koniugacji | |
| Escherichia coli XL1 Blue | Agilient Technologies, Santa Clara, USA | Szczep testowy Gram-ujemny + gospodarz klonujący | |
| Streptomyces diastatochromogenes Tü 6028 | Paululat et al., 1999 | poliketomycyny | |
| Usługi online | |||
| genów metabolitów wtórnych | |||
| BLAST (Basic Local Alignment Search Tool) | http://blast.ncbi.nlm.nih.gov/Blast.cgi | znajduje obszary podobieństwa między sekwencjami biologicznymi | |
| GenDB | https://www.uni-giessen.de/fbz/fb08/Inst/bioinformatik/software/gendb | Adnotacja ORFów | |
| MiBIG (Minimum Information about a Biosynthetic Gene cluster) | http://mibig.secondarymetabolites.org/ | Baza danych biosyntetycznych klastrów genów | |
| NaPDoS | http://napdos.ucsd.edu/ | Wykrywanie sekonarycznego klastra | |
| NCBI Prokariotyczne Genom Annotation Pipeline | http://www.ncbi.nlm.nih.gov/genome/annotation_prok/ | Adnotacja ORFs | |
| NRPSpredictor | http://nrps.informatik.uni-tuebingen.de/ | Wykrywanie domen | |
| Prokka (szybka adnotacja genomu prokariotycznego) | http://www.vicbioinformatics.com/software.prokka.shtml | Adnotacja ORFs | |
| RAST (szybka adnotacja przy użyciu technologii podsystemów) | http://rast.nmpdr.org/ | Adnotacja ORFów | |
| Inne programy | |||
| Chem Station Rev. A.09.03 | Agilent Technologies, Waldbronn, Niemcy | Program obsługi dla HPLC | |
| Clone Manager Suite 7 | Oprogramowanie naukowe i edukacyjne, Cary, USA | Projektowanie eksperymentu klonowania | |
| Newbler v2.8 | Roche Diagnostics | Wyrównanie odczytów | |
| Machines | |||
| Wirówka Avanti J-6000, Rotor JA-10 | Beckman Coulter GmbH, Krefeld, Niemcy | ||
| HPLC/MS | Agilent Technologies, Waldbronn, Niemcy | ||
| _Autosampler: G1313A | Agilent Technologies, Waldbronn, Niemcy | ||
| _Pre-kolumnowy: XBridge C18 (20 mm x 4,6 mm; Wielkość cząstek: 3,5 i mikro; m) | Agilent Technologies, Waldbronn, Niemcy | ||
| _Column:Xbridge C18 (100 mm i czas; 4,6 mm; Wielkość cząstek: 3,5 i mu; m) | Agilent Technologies, Waldbronn, Niemcy | ||
| _semi Kolumna wstępna: Zorbax B-C18 (9,4 x 150 mm; Wielkość cząstek: 5 i mikro; m) | Agilent Technologies, Waldbronn, Niemcy | ||
| _semi-prep Kolumna: Zorbax B-C18 (9,4 x 20 mm; Wielkość cząstek: 5 i mikro; m) | Agilent Technologies, Waldbronn, Niemcy | ||
| _Degasser: G1322A | Agilent Technologies, Waldbronn, Niemcy | ||
| _Quarternary pompa: G1311A | Agilent Technologies, Waldbronn, Niemcy | ||
| _Diode detektor matrycowy (DAD )G1315B (λ = 254 nm i 400 nm) | Agilent Technologies, Waldbronn, Niemcy | ||
| _Quadrupole detektor masowy (MSD) G1946D(2-3000 m/z) | Agilent Technologies, Waldbronn, Niemcy | ||
| Wyparka obrotowa | |||
| _heating wannowa Hei-VAP Value/G3 | Heidolph Instruments GmbH & Co.KG, Schwabach, Niemcy | ||
| _vacuum system pompowy SC 920 G | KNF Strategie globalne AG, Sursee, Szwajcaria | ||
| Inne materiały | |||
| Sephadex LH20 | GE Healthcare, | ||
| Chromafil PVDF-45/15MS (wielkość porów 0,45 &mikro; m; filtr & Oslash; 15 mm) | MACHEREY-NAGEL GmbH & Co. KG, Dü ren, Niemcy | ||
| Kolumna SPE Oasis HLB 20 35 cc (6g) | Waters GmbH, Eschborn, Niemcy | ||
| E. coli | Carl Roth GmbH + Co. KG, Karlsruhe, Niemcy | Medium: LB, Skład: LB, Ilość 1 L H2O: 20 g | |
| Bacillus | Carl Roth GmbH + Co. KG, Karlsruhe, Niemcy | Podłoże: LB, Skład: LB, Ilość 1 L H2O: 20 g | |
| Streptomyces sp. | Carl Roth GmbH + Co. KG, Karlsruhe, Niemcy | Podłoże: TSB, Skład: CASO Boullion, Ilość 1 L H2O: 30 g | |
| grzyba | Carl Roth GmbH + Co. KG, Karlsruhe, Niemcy | Podłoże: YPD, Skład: Ekstrakt drożdżowy, Ilość 1 L H2O: 10 g | |
| grzyba | Carl Roth GmbH + Co. KG, Karlsruhe, Niemcy | Podłoże: YPD, Skład: Pepton, Ilość 1 L H2O: 20 g | |
| grzyba | Carl Roth GmbH + Co. KG, Karlsruhe, Niemcy | Podłoże: YPD, Skład: Glukoza, Ilość 1 l H2O: 20 g | |
| na płytki agarowe dodaj 2% agaru |
Bibliografia
- Fleming, A. On the antibacterial action of cultures of a penicillin, with special reference to their use in isolation of B. influenzae. Br J Exp Pathol. 10 (3), 226-236 (1929).
- Lemke, A., Kiderlen, A. F., Kayser, O. Amphotericin B. Appl. Microbiol. Biotechnol. 68 (2), 151-162 (2005).
- Kirkpatrick, P., Raja, A., LaBonte, J., Lebbos, J. Daptomycin. Nat. Rev. Drug Discov. 2 (12), 943-944 (2003).
- Zakeri, B., Wright, G. D. Chemical biology of tetracycline antibiotics. Biochem. cell Biol. 86 (2), 124-136 (2008).
- Schatz, A., Bugle, E., Waksman, S. A. Streptomycin, a Substance Exhibiting Antibiotic Activity Against Gram-Positive and Gram-Negative Bacteria. Exp. Biol. Med. 55 (1), 66-69 (1944).
- Burg, R. W., et al. Avermectins, new family of potent anthelmintic agents: producing organism and fermentation. Antimicrob. Agents Chemother. 15 (3), 361-367 (1979).
- Egerton, J. R., Ostlind, D. A., et al. Avermectins, new family of potent anthelmintic agents: efficacy of the B1a component. Antimicrob. Agents Chemother. 15 (3), 372-378 (1979).
- Walsh, C. T., Fischbach, M. A. Natural products version 2.0: connecting genes to molecules. J. Am. Chem. Soc. 132 (8), 2469-2493 (2010).
- Momose, I., et al. Polyketomycin, a new antibiotic from Streptomyces sp. MK277-AF1. II. Structure determination. J. Antibiot. (Tokyo). 51 (1), 26-32 (1998).
- Paululat, T., Zeeck, A., Gutterer, J. M., Fiedler, H. P. Biosynthesis of polyketomycin produced by Streptomyces diastatochromogenes.Tü6028. J. Antibiot. (Tokyo). 52 (2), 96-101 (1999).
- Momose, I., et al. Polyketomycin, a new antibiotic from Streptomyces. sp. MK277-AF1. I. Taxonomy, production, isolation, physico-chemical properties and biological activities. J. Antibiot. (Tokyo). 51 (1), 21-25 (1998).
- Daum, M., et al. Organisation of the biosynthetic gene cluster and tailoring enzymes in the biosynthesis of the tetracyclic quinone glycoside antibiotic polyketomycin. Chembiochem. 10 (6), 1073-1083 (2009).
- Bode, H. B., Bethe, B., Höfs, R., Zeeck, A. Big effects from small changes: possible ways to explore nature's chemical diversity. Chembiochem. 3 (7), 619-627 (2002).
- Wolfender, J. -L. HPLC in Natural Product Analysis: The Detection Issue. Planta Med. 75 (07), 719-734 (2009).
- Stahl, E. Thin-layer chromatography. A laboratory handbook. , 2nd edition (1967).
- Snyder, L. R., Kirkland, J. J., Glajch, J. L. Preparative HPLC Separation. Pract. HPLC Method Dev. , 616-642 (2012).
- Granath, K. A., Kvist, B. E. Molecular weight distribution analysis by gel chromatography on sephadex. J. Chromatogr. A. 28, 69-81 (1967).
- Jackman, L. M., Sternhell, S. Application of Nuclear Magnetic Resonance Spectroscopy in Organic Chemistry. Int. Ser. Org. Chem. , (1969).
- Xian, F., Hendrickson, C. L., Marshall, A. G. High resolution mass spectrometry. Anal. Chem. 84 (2), 708-719 (2012).
- Metzker, M. L. Sequencing technologies - the next generation. Nat. Rev. Genet. 11 (1), 31-46 (2010).
- Tatusova, T., et al. Prokaryotic Genome Annotation Pipeline. NCBI Handb. 2nd Ed. , (2013).
- Angiuoli, S. V., et al. Toward an online repository of Standard Operating Procedures (SOPs) for (meta)genomic annotation. OMICS. 12 (2), 137-141 (2008).
- Aziz, R. K., et al. The RAST Server: rapid annotations using subsystems technology. BMC Genomics. 9, 75(2008).
- Overbeek, R., et al. The SEED and the Rapid Annotation of microbial genomes using Subsystems Technology (RAST). Nucleic Acids Res. 42, 206-214 (2014).
- Brettin, T., et al. RASTtk: a modular and extensible implementation of the RAST algorithm for building custom annotation pipelines and annotating batches of genomes. Sci. Rep. 5, 8365(2015).
- Seemann, T. Prokka: rapid prokaryotic genome annotation. Bioinformatics. 30 (14), 2068-2069 (2014).
- Meyer, F. GenDB--an open source genome annotation system for prokaryote genomes. Nucleic Acids Res. 31 (8), 2187-2195 (2003).
- Altschul, S. F., Gish, W., Miller, W., Myers, E. W., Lipman, D. J. Basic local alignment search tool. J. Mol. Biol. 215 (3), 403-410 (1990).
- Madden, T. The BLAST Sequence Analysis Tool. NCBI Handb. 2nd Ed. , Chapter 16 (2003).
- Marchler-Bauer, A., et al. CDD: NCBI's conserved domain database. Nucleic Acids Res. 43, (Database issue) 222-226 (2014).
- Medema, M. H., et al. antiSMASH: rapid identification, annotation and analysis of secondary metabolite biosynthesis gene clusters in bacterial and fungal genome sequences. Nucleic Acids Res. 39, (Web Server issue) 339-346 (2011).
- Blin, K., et al. antiSMASH 2.0--a versatile platform for genome mining of secondary metabolite producers. Nucleic Acids Res. 41, (Web Server issue) 204-212 (2013).
- Weber, T., et al. antiSMASH 3.0 - a comprehensive resource for the genome mining of biosynthetic gene clusters. Nucleic Acids Res. 43, (W1) 237-243 (2015).
- Ziemert, N., et al. The natural product domain seeker NaPDoS: a phylogeny based bioinformatic tool to classify secondary metabolite gene diversity. PLoS One. 7 (3), 34064(2012).
- Rausch, C., Weber, T., Kohlbacher, O., Wohlleben, W., Huson, D. H. Specificity prediction of adenylation domains in nonribosomal peptide synthetases (NRPS) using transductive support vector machines (TSVMs). Nucleic Acids Res. 33 (18), 5799-5808 (2005).
- Röttig, M., et al. NRPSSpredictor2--a web server for predicting NRPS adenylation domain specificity. Nucleic Acids Res. 39, (Web Server issue) 362-367 (2011).
- Medema, M. H., et al. Minimum Information about a Biosynthetic Gene cluster. Nat. Chem. Biol. 11 (9), 625-631 (2015).
- Mullis, K., et al. Specific enzymatic amplification of DNA in vitro: the polymerase chain reaction. Cold Spring Harb. Symp. Quant. Biol. 51, Pt 1 263-273 (1986).
- Bierman, M., et al. Plasmid cloning vectors for the conjugal transfer of DNA from Escherichia coli to Streptomyces spp. Gene. 116 (1), 43-49 (1992).
- Froger, A., Hall, J. E. Transformation of plasmid DNA into E. coli.using the heat shock method. J. Vis. Exp. (6), e253(2007).
- Bimboim, H. C., Doly, J. A rapid alkaline extraction procedure for screening recombinant plasmid DNA. Nucleic Acids Res. 7 (6), 1513-1523 (1979).
- MacNeil, D. J., et al. Analysis of Streptomyces avermitilis. genes required for avermectin biosynthesis utilizing a novel integration vector. Gene. 111 (1), 61-68 (1992).
- Pospiech, A., Neumann, B. A versatile quick-prep of genomic DNA from Gram-positive bacteria. Trends Genet. 11 (6), 217-218 (1995).
- Makitrynskyy, R., et al. Pleiotropic regulatory genes bldA, adpA and absB are implicated in production of phosphoglycolipid antibiotic moenomycin. Open Biol. 3 (10), 130121(2013).
- Kalan, L., et al. A cryptic polyene biosynthetic gene cluster in Streptomyces calvus is expressed upon complementation with a functional bldA gene. Chem. Biol. 20 (10), 1214-1224 (2013).
- Gessner, A., et al. Changing Biosynthetic Profiles by Expressing bldA in Streptomyces Strains. ChemBioChem. 16 (15), 2244-2252 (2015).
Przedruki i uprawnienia
