本文介绍了一种天然产物的详细研究方案:(A)具有抗生素活性的天然产物的鉴定,(B)该化合物的纯化,(C)其生物合成途径的初步模型构建,(D)基因组测序与挖掘,以及(E)生物合成基因簇的验证。
方法文章
从天然产物到其生物合成基因簇:以Streptomyces diastatochromogenes Tü6028中多酮霉素为例的演示
本文内容
摘要
摘要
Streptomyces 菌株以其能够产生大量具有多种生物活性的化合物而闻名。在不同条件下培养常可诱导产生新的化合物。因此,对菌株的生产培养物用乙酸乙酯进行提取,并通过高效液相色谱(HPLC)分析粗提物。此外,还通过多种生物活性检测方法对提取物进行生物活性测试。对于目标化合物的结构解析,则采用多种色谱方法组合对其进行纯化。
基因组测序结合基因组挖掘技术,可利用不同的计算机程序鉴定天然产物的生物合成基因簇。为确认已鉴定出正确的基因簇,必须进行基因失活实验。随后分析突变株是否产生特定的天然产物。一旦正确的基因簇被成功失活,该菌株应无法产生该化合物。
以Streptomyces diastatochromogenes Tü6028菌株产生的抗菌化合物聚酮霉素为例展示工作流程。大约十年前,当基因组测序仍十分昂贵时,基因簇的克隆与鉴定是一个非常耗时的过程。快速基因组测序结合基因组挖掘技术可加速基因簇的鉴定试验,为探索生物合成途径以及通过遗传学方法创制新型天然产物提供了新途径。本文所述方案可适用于任何来源于Streptomyces菌株或其他微生物的化合物。
引言
来自植物和微生物的天然产物一直是临床药物研发的重要来源。1928年,亚历山大·Fleming从一种真菌中发现了第一种抗生素——青霉素1。如今,已有更多天然产物被用于临床治疗。
一个以其能够产生多种具有不同生物活性的次级代谢产物而著称的属是Streptomyces。Streptomyces为革兰氏阳性菌,属于放线菌门(Actinobacteria)放线菌目(Actinomycetales)。临床上使用的所有抗生素中,近三分之二来源于放线菌目,主要来自Streptomyces,例如两性霉素2、达托霉素3和四环素4。在Streptomyces抗生素研究领域,已有两项诺贝尔奖被授予。第一项授予了Selman Waksman,以表彰其发现链霉素——首个对结核病有效的抗生素5。2015年,在诺贝尔生理学或医学奖中,也表彰了从S. avermitilis中发现阿维菌素的成果。阿维菌素用于治疗寄生虫病6,7。
在微生物(如Streptomyces)中发现天然产物的传统方法通常包括在不同培养条件下培养菌株,以及提取和分析次级代谢产物。通过生物活性检测(例如抗菌和抗癌活性检测)来确定化合物的活性。最后,分离目标化合物并解析其化学结构。
天然产物的结构通常由单个结构单元组成,这些结构单元形成复杂的分子。通向这些构建单元的主要生物合成途径数量有限,这些构建单元被用于天然产物的生物合成。主要的生物合成途径包括聚酮类途径、萜类和生物碱类的合成途径、利用氨基酸的途径,以及生成糖基结构单元的途径。每条途径都由一组特定的酶所表征8。根据化合物的结构,可以预测这些生物合成相关的酶。
如今,化合物的详细结构分析结合新一代测序和生物信息学分析,有助于鉴定出负责的生物合成基因簇。该基因簇信息为天然产物的进一步研究开辟了新途径,包括通过异源表达提高天然产物产量、通过基因敲除或修饰实现化合物的靶向改造,以及利用其他代谢通路的基因进行组合生物合成。
聚酮霉素分别从两个菌株的培养液中独立分离得到,分别为Streptomyces sp. MK277-AF19和Streptomyces diastatochromogenes Tü602810。其结构通过核磁共振(NMR)和X射线分析得以阐明。聚酮霉素由一个四环十酮结构和一个二甲基水杨酸组成,二者通过两个脱氧糖基团β-D-阿米采糖和α-L-阿克森糖连接。该化合物表现出细胞毒性和抗生素活性,即使对耐甲氧西林金黄色葡萄球菌(MRSA)等革兰氏阳性多重耐药菌株也具有活性11。
多年前已构建并筛选了S. diastatochromogenes Tü6028的基因组cosmid文库。通过特异性基因探针,经过数月的密集工作,鉴定出一个大小为52.2 kb、包含41个基因的聚酮霉素生物合成基因簇12。最近,获得了S. diastatochromogenes的草图基因组序列,从而实现了对该聚酮霉素生物合成基因簇的快速鉴定。本文综述将以聚酮霉素为例,介绍一种有助于鉴定天然产物并阐明其生物合成基因簇的方法。
在此,我们阐述从天然产物到其生物合成基因簇的各个步骤,以由 Streptomyces diastatochromogenes Tü6028。该方案包括具有抗生素特性的天然产物的鉴定与纯化。进一步的结构分析结合基因组挖掘结果的比对,可确定其生物合成基因簇。该方法可应用于来源于其他任何微生物的化合物研究。 链霉菌属 菌株或其他任何微生物。
方案
1. 具有抗生素特性的天然产物的鉴定
- 在不同条件下培养微生物(例如 时间、温度、pH、培养基)采用“OSMAC(一菌多化合物)策略”13选择一种能够观察到化合物生成的培养基。
- 培养 Streptomyces diastatochromogenes Tü6028 在以下条件下
- 培养 Streptomyces diastatochromogenes Tü6026 菌株在 MS 平板上(大豆粉 20 g,D-甘露醇 20 g,MgCl2 10 mM,琼脂 1.5%,自来水 1 L)。用接种环取少量该菌株的孢子,接种于装有 20 mL 液体 TSB 培养基(胰蛋白胨大豆肉汤 30 g,自来水 1 L,pH 7.2;预培养基)并带有螺旋结构的锥形瓶中。将锥形瓶置于旋转摇床中振荡培养(28 °C,180 rpm,2天)
- 在100 mL HA培养基(葡萄糖4 g,酵母提取物4 g,麦芽提取物10 g,自来水1 L,pH 7.2)中接种2 mL预培养液,用于主培养。将菌株在以下条件下培养: 28 °C 在180 rpm的旋转摇床上孵育6天。
- 粗提物的制备
- 通过离心收集细胞(10 min,3,000 x g)。
- 后续步骤需在通风橱内操作有机溶剂。
- 从菌丝中提取化合物时,将细胞重悬于两倍体积的丙酮中,在试管中以180 rpm振荡30分钟。用市售滤纸过滤液体,并使用旋转蒸发仪蒸发丙酮 40 °C 以及550 bar。将提取物溶解于20 mL水:乙酸乙酯(1:1)中,在分液漏斗中于180 rpm条件下振荡30分钟。
- 从培养基中提取化合物时,加入1 M HCl将培养液pH值调节至4.0。加入100 mL乙酸乙酯,在分液漏斗中以180 rpm振荡萃取30分钟。
- 收集乙酸乙酯相,并通过旋转蒸发在 40 °C 和 240 bar。
- 采用高效液相色谱法分析粗提物
- 将提取物溶于1 mL MeOH中,经滤膜过滤 0.45 µm 孔径滤膜过滤并进行高效液相色谱(HPLC)分析14.
- 对于多酮霉素,为高效液相色谱系统配备 C18 预柱(4.6 x 20 mm)2)和C18柱(4.6 × 100 mm)2). 使用乙腈 + 0.5% 乙酸在 H2O + 0.5% 乙酸(流速:0.5 mL min⁻¹)-1).
注意:Polyketomycin 的保留时间为 25.9 min(参见 图1A)。紫外/可见光谱在 242 nm、282 nm 和 446 nm 处有最大吸收峰,在 262 nm 和 359 nm 处有最小吸收峰(见 图1B)。在负离子模式下,质荷比为863.2 [M-H]⁻- 可检测到(参见 图1C).
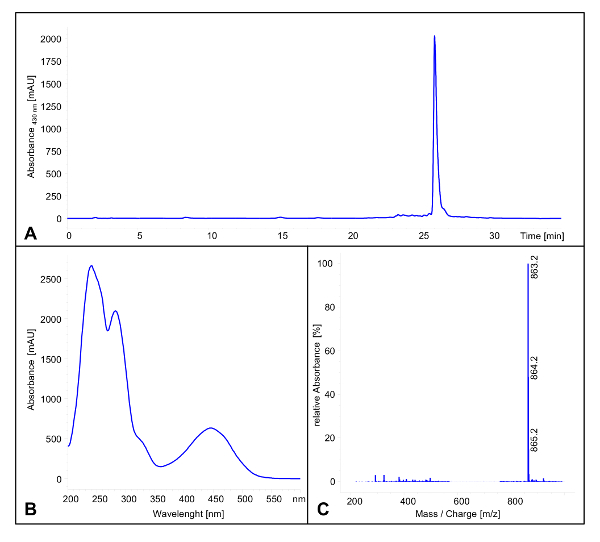
图 1:多酮霉素的液相色谱-质谱分析。(A)Streptomyces diastatochromogenes Tü6028 培养 6 天后粗提物的高效液相色谱图(λ = 430 nm)。多酮霉素的保留时间为 25.9 分钟。(B)多酮霉素的紫外-可见吸收光谱。(C)多酮霉素在负离子模式下的质谱图。主峰为 m/z 863.2 [M-H]-。请点击此处查看该图的放大版本。
- 采用纸片扩散法鉴定抗生素活性
- 接种革兰氏阳性菌等测试菌株 枯草芽孢杆菌 (在LB培养基中;LB 20 g,自来水1 L,pH 7.4)及其他 Streptomyces 菌株(在TSB培养基中;胰蛋白胨大豆肉汤 30 g,蒸馏水 1 L,pH 7.2), 革兰氏阴性菌 大肠杆菌 (在LB培养基中)和真菌菌株(在YPD等培养基中;酵母提取物10 g,蛋白胨20 g,葡萄糖20 g,自来水1 L,pH 7.4)。取 100 µL 将测试菌株的预培养物接种并涂布于相应的琼脂平板上。
- 将粗提物或纯化后的化合物溶解于 500 µL 甲醇(或水或DMSO)并用移液器转移20-50 µL 置于无菌纸片上。将纸片在工作台下干燥30分钟,然后放置于含测试菌株的平板上。设置阴性对照(溶剂)和阳性对照(抗生素)。 例如 阿普拉霉素 [1 mg]
- 在适宜条件下培养平板,直至试验菌株明显生长,并观察是否存在抑菌圈。培养 E. coli 和 芽孢杆菌属 37°C 培养 16 小时, 链霉菌属 sp. 于 28 °C 培养 2-4 天,真菌菌株(主要取决于具体测试菌株)于 30 °C 培养 2 天)。
2. 化合物的大规模提取、纯化与结构解析
- 在5 L HA培养基(葡萄糖4 g、酵母提取物4 g、麦芽提取物10 g、自来水1 L,pH 7.2)中培养 S. diastatochromogenes。将2 mL预培养液接种至30个500 mL三角瓶中,每瓶含150 mL HA培养基。于28 °C、180 rpm条件下在摇床中培养6天。
- 通过离心(10 min,15,000 × g,室温)收集菌体,并用乙酸乙酯提取化合物(见第1.3节)。
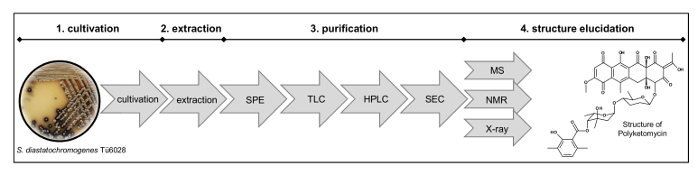
图 2:结构解析工作流程。该流程包括:(1)菌株培养,(2)提取,(3)通过固相萃取(SPE)、薄层色谱(TLC)、制备型高效液相色谱(HPLC)和尺寸排阻色谱(SEC)进行纯化,以及(4)通过质谱分析(MS)、核磁共振(NMR)和X射线测定进行结构解析。请点击此处查看本图的放大版本。
- 聚酮霉素的纯化
注意:纯化与结构解析的过程如图所示 图2.- 使用C18固相萃取(SPE)柱,通过甲醇-水体系中30%至100%的10%梯度甲醇进行逐步洗脱,对粗提物进行分级分离2O,每种条件下各 100 mL
- 通过制备型薄层色谱法(TLC)进一步纯化含化合物的组分15 使用 CH2Cl2以甲醇(7:1)作为洗脱体系。
- 通过制备型高效液相色谱法纯化该化合物16. 为高效液相色谱系统配备C18预柱(5 µm;9.4 × 20 mm)和一根主柱(5 µm;9.4 × 150 mm)。使用乙腈 + 0.5% 乙酸在 H₂O 中的梯度洗脱,比例从 20% 升至 95%2O + 0.5% 乙酸(流速:2.0 mL/min)。
- 为了去除溶剂及其他小分子杂质,使用甲醇中的凝胶过滤色谱柱进行最后一次纯化步骤17. 收集最终的纯化产物,通过旋转蒸发在减压下蒸去甲醇 40 °C 和 240 bar。
- 结构解析
- 将纯化合物(2 mg 以上)溶解于 600-700 µL (取决于仪器)的DMSO-d6, 记录一维核磁共振(1D NMR)1H, 13C)和二维核磁共振(HSQC、HMBC,1H-1H COSY) 谱图在核磁共振波谱仪上18以化学位移表示 δ 使用 DMSO 测定值(ppm)d6.
- 记录高分辨质谱(HRESI-MS)19 使用高分辨率质谱仪对聚酮霉素进行分析。
- 通过解析核磁共振(NMR)和质谱(MS)数据分析阐明结构10.
3. 提出新分离化合物的生物合成模型
- 分析分离得到的化合物结构,并预测可能参与其生物合成的酶。将这些酶归类到聚酮(I型、II型或III型)、非核糖体肽合成、兰肽、萜类或糖代谢途径8。
- 以聚酮霉素为例
- 将结构划分为明显的单个结构单元:四环结构单元、两个单糖单元以及二甲基水杨酸单元。
- 分析这些结构单元可能的来源:四环结构单元可能来源于II型聚酮合酶,二甲基水杨酸单元可能由I型迭代聚酮合酶合成。两个6-脱氧糖结构单元可能在生物合成过程中由葡萄糖经TDP-葡萄糖-4,6-脱水酶催化生成,并可能由两种糖基转移酶连接至母核结构(见图3)8。
- 预测该基因簇中可能存在的候选基因。考虑参与各结构单元合成、连接各单元以及对分子进行修饰和改造的酶类。聚酮霉素的生物合成基因簇很可能包含编码II型聚酮合酶(至少包括用于连接延伸单元的ACP、KSα和KSβ)、I型迭代聚酮合酶(至少包括ACP、AT、KS)、TDP-葡萄糖-4,6-脱水酶(实现葡萄糖→脱氧葡萄糖转化所必需)以及两种糖基转移酶(将两个单糖连接至苷元)的基因8。
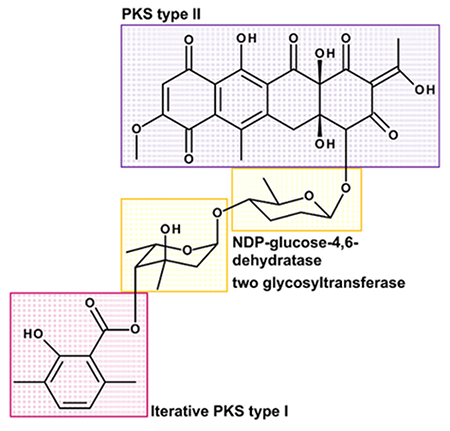
图3:聚酮霉素结构的单个结构单元划分。聚酮霉素由一个四环十酮(PKS II型)和一个二甲基水杨酸(迭代PKS I型)组成,两者通过两个脱氧糖单元β-D-阿米采糖和α-L-阿克森糖连接(需要NDP-葡萄糖-4,6-脱水酶及两种糖基转移酶)。请点击此处查看该图的放大版本。
4. 基因组测序/挖掘
- 下一代测序
- 使用Illumina、454焦磷酸测序或SOLiD20等下一代测序技术对基因组DNA进行测序。将单条读长比对至参考序列,或进行从头组装(de novo)。
注意:S. diastatochromogenes Tü6028的基因组在比勒费尔德大学生物技术中心(CeBiTec)完成测序。所有读长被组装成一个7.9 Mb的草图基因组。
- 使用Illumina、454焦磷酸测序或SOLiD20等下一代测序技术对基因组DNA进行测序。将单条读长比对至参考序列,或进行从头组装(de novo)。
- 基因组挖掘
- 利用NCBI原核基因组注释流程(Prokaryotic Genome Annotation Pipeline)21,22、RAST(基于子系统技术的快速注释)23,24,25、Prokka(快速原核基因组注释)26或GenDB27等程序搜索开放阅读框(ORFs),这些程序同时会预测其功能。S. diastatochromogenes Tü6028草图基因组序列的分析结果显示存在超过7,000个ORFs。
- 运行特异性的BLAST(基本局部比对搜索工具)分析,以获取更多信息,例如与其他相似基因的比对结果及催化结构域信息28,29,30。
- 为鉴定次级代谢产物基因簇,可运行antiSMASH31,32,33、NaPDoS34和NRPSpredictor35,36等程序。在Streptomyces diastatochromogenes的草图基因组中,antiSMASH31,32,33共鉴定出22个基因簇。
- 分析推测的基因簇所涉及的酶促代谢通路(聚酮合酶(I型、II型或III型)、非核糖体肽合酶、羊毛硫肽、萜类、糖代谢等)。搜索可能参与目标化合物合成的基因簇(见第3节)。在S. diastatochromogenes中,注释的第2号基因簇包含II型聚酮合酶基因、三个I型聚酮合酶基因、一个TDP-葡萄糖-4,6-脱水酶基因以及两个糖基转移酶基因(见图4)。
- 重点关注基因簇内的单个基因。对于I型PKS和NRPS,可通过预测酰基转移酶和腺苷酸化结构域的特异性,推断单个延伸单元的引入方式。同时将预测的延伸单元引入顺序与目标分子结构进行比对。antiSMASH31,32,33还可显示已知化合物的相似基因簇,并提供链接至MIBiG数据库37。
- 将目标化合物的结构与这些已知化合物进行比较,检查是否存在结构相似性。
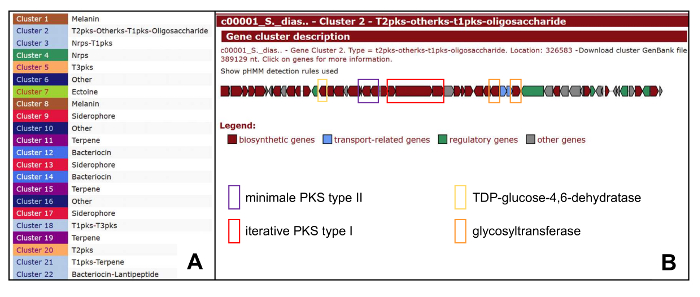
图4:Polyketomycin 生物合成基因簇的 antiSMASH 输出结果及其他基因簇概览 S. diastatochromogenes Tü6028. (A) 基因组中预测的生物合成基因簇概述 S. diastatochromogenes Tü6028; (B2号聚酮霉素生物合成基因簇及其靶向基因 请点击此处以查看此图的放大版本。
5. 生物合成基因簇的验证
- 寻找一个在化合物生物合成中具有明显且重要(必需)功能的基因。为验证聚酮霉素基因簇,该基因 pokPI,编码II型PKS酮合酶α的基因被选中,并通过以下方法使其失活 超出范围-缺失(参见 图 5B)。或者,通过克隆一个内部片段来中断该基因(参见 图 5C).
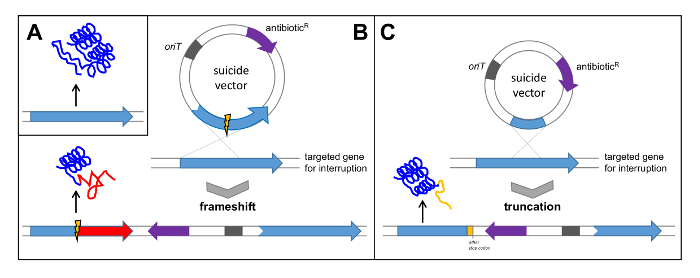
图 5:通过单交换验证基因簇。(A)天然基因可翻译成功能性蛋白;(B)将带有内部缺失的基因克隆至自杀型载体,导致单交换事件,使靶基因发生移码突变,进而翻译出非功能性蛋白;(C)将基因的内部片段克隆至自杀型载体,导致基因截短,进而翻译出非功能性蛋白。oriT:转移起始位点;antibioticR:抗生素抗性。请点击此处查看该图的放大版本。
- 单交换载体的克隆
- 扩增含有目标片段的DNA区域 pokPI 通过PCR38 使用引物 pokPI_for 和 pokPI_rev。
- 将PCR产物克隆至自杀载体pKC1132中39 (阿帕拉霉素R [50 mg/mL])。该自杀载体无法在 链霉菌属 菌株,因此必须通过同源重组整合到靶基因中以提供阿普拉霉素抗性。将载体转入 E. coli 通过热激转化法进行克隆宿主菌的转化40.
- 通过碱裂解法分离载体41.
- 用一种在片段内部具有切割位点的单切酶限制性内切酶消化载体DNA。 pokPI 基因经消化处理使用 酶 Kpn一、
- 用大肠杆菌DNA聚合酶I大片段(Klenow片段)处理已消化的载体DNA,该酶具有5'→3'聚合酶活性和3'→5'外切核酸酶活性。通过平端化黏性末端并进行后续的重新连接,可导致四个碱基的缺失。通过以下转化步骤检测这些碱基的缺失情况 E. coli XL1 Blue,挑取单菌落,分离质粒DNA41 并通过限制性酶切和测序进行进一步分析。
- 将单交换构建体接合到 链霉菌属
- 转移含有自杀基因的载体 pokPI 基因(pKC1132_pokPI缺失(del)至缺失 E. coli ET12567 pUZ800242 卡那霉素R通过热激转化40. 在含有100 mL LB培养基(卡那霉素)的条件下培养细胞 50 µg mL-1,阿普拉霉素 50 µg mL-1)在4°C下孵育过夜 37 °C. 通过离心收集细胞(3,000 x g,10 min, 4 °C)并用50 mL LB培养基重悬细胞,洗涤两次。最后,将细胞重悬于2 x 500 µL LB培养基
- 混合 500 µL E. coli pUZ8002 pKC1132_pokPI用 500 µL 处理 Streptomyces diastatochromogenes 培养物(也可使用孢子)。将混合物涂布于MS培养基平板(大豆粉20 g,D-甘露醇20 g,MgCl₂·6H₂O 0.25 g,KH₂PO₄ 150 mg,NaCl 100 mg,Ca(NO₃)₂·4H₂O 400 mg,KNO₃ 1 g,NH₄NO₃ 1.5 g,FeSO₄·7H₂O 27.8 mg,Na₂EDTA 37.3 mg,H₃BO₃ 6.2 mg,MnSO₄·H₂O 1.6 mg,ZnSO₄·7H₂O 0.8 mg,KI 0.8 mg,CuSO₄·5H₂O 0.025 mg,Na₂MoO₄·2H₂O 0.025 mg,CoCl₂·6H₂O 0.025 mg,蔗糖30 g,琼脂8 g,蒸馏水1 L,pH 5.8)上2 10 mM,琼脂 1.5%,自来水 1 L)。将平板在 20 h 内于 28 °C.
- 在每个平板上覆盖溶解于1 mL水中的阿帕拉霉素(1.25 mg)和磷霉素(5 mg),待其干燥。将平板置于 28 °C 直到接合子可见。
- 检测单交换突变体
- 将单个接合子接种于20 mL TSB培养基中(含50 mg/mL阿普拉霉素)-1)并在 28 °C 三天,180 rpm。
- 分离基因组DNA43 并检查是否出现中断 pokPI 通过 PCR 扩增基因。
- 接种经验证基因中断的单克隆菌株 链霉菌属 野生型菌株在100 mL HA培养基中培养,并于30°C下孵育6天 28 °C 以及180 rpm。提取粗提物(见第1.3节)。通过HPLC-MS分析检测化合物的产生(见第1.4节)。在HPLC色谱图中对应的峰及该化合物的质荷比应不再可检测到(见 图6).
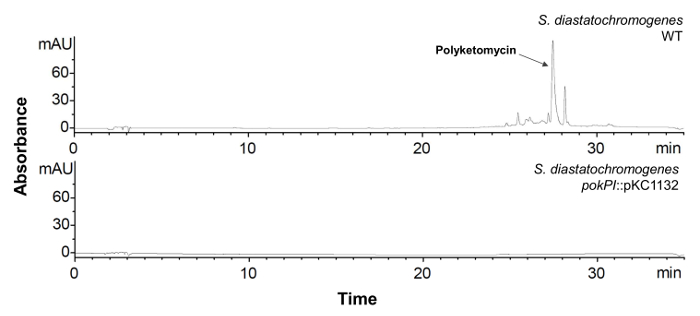
图6:pokPI 基因失活的 S. diastatochromogenes 的HPLC分析。 HPLC色谱图(λ = 430 nm)显示了S. diastatochromogenes野生型(上图)和pokPI-Gen基因中断突变株(下图)的粗提物。突变株不再产生聚酮霉素。请点击此处查看该图的高清版本。
结果
在本综述中,我们描述了从鉴定一种抗生素到发现其生物合成基因簇的各个步骤。许多年前,我们构建了一个黏粒文库,将其包装成噬菌体,转导至E. coli宿主细胞,并筛选了数千个菌落,以鉴定含有聚酮霉素基因簇重叠区域的克隆。黏粒的测序也曾是一个困难且昂贵的过程12。
为了对菌株进行进一步研究,我们对Streptomyces diastatochromogenes Tü6028的全基因组进行了测序。通过该基因组草图,我们能够快速鉴定出多烯酮霉素的生物合成基因簇以及其他编码具有潜力化合物的基因簇。图7在粗略的时间尺度上比较了通过克隆cosmid文库并进行繁琐筛选来鉴定生物合成基因簇的“传统”方法与通过全基因组测序结合后续基因组挖掘的“新”方法。新的测序技术与先进的基因组挖掘软件显著加快了整个研究进程。
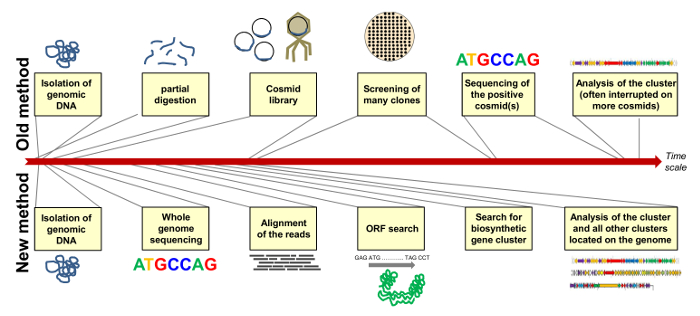
图7:传统与新型生物合成基因簇鉴定方法的比较。 传统方法包括构建cosmid文库,筛选阳性克隆,并对相应cosmid进行测序(上方);新型方法则包括全基因组测序及挖掘,以鉴定菌株基因组中全部的次级代谢产物基因簇(下方)。各步骤所需时间以粗略的时间尺度显示。 请点击此处查看该图的放大版本。
讨论
多年前,在本实验中构建并筛选了Streptomyces diastatochromogenes的基因组柯斯质粒文库,通过一个极为耗时的过程鉴定了聚酮霉素生物合成基因簇。利用靶向基因缺失及对相应突变体的分析,可对单个基因进行功能表征12。最近,获得了S. diastatochromogenes的草图基因组序列,使得聚酮霉素生物合成基因簇能够被快速鉴定。尽管该草图基因组仍包含大量重叠群(contigs),我们仍能轻松识别出这些生物合成基因。上述过程可在数月内完成。然而,该实验流程包含多个步骤,其中任一步骤可能多次失败,从而阻碍后续步骤的进行:
属 链霉菌属 以其产生生物活性化合物的能力而闻名。尽管它们通常含有超过20个生物合成基因簇,但在实验室条件下通常仅产生一到两种化合物。采用OSMAC方法(在不同条件下培养同一菌株)以激活沉默基因簇有时仍不足以实现目的。对调控基因(如多效调节基因)进行遗传操作 adpA44 和 bldA45,46也是一种有效激活其他次级代谢产物合成的方法。
为了阐明该化合物的结构, 例如 通过核磁共振(NMR)分析,通常需要超过2 mg的纯化化合物。因此,常常需要发酵超过10 L的培养物。若没有能够维持氧气、pH和温度条件的发酵设备,小型实验室在处理如此大量的培养物及其后续提取时可能会面临困难。在纯化过程中,化合物可能因氧化、光照或温度变化而发生改变。此外,纯化步骤越多,降解的可能性越高。
在分析天然产物的结构及其基因组中的基因簇时,有时很难确定相应的基因簇。首先,如果仅有草图基因组序列,则基因簇的某些部分可能缺失。其次,并非所有参与生物合成的基因都位于该基因簇内。第三,有时一个基因簇被分割为两部分,彼此相隔数千碱基。第四,可能难以判断哪一个才是正确的基因簇。对于I型聚酮合酶(PKS)或非核糖体肽合酶(NRPS)系统而言,若可根据模块数量推算出延伸单元的数目,甚至可通过分析选择性结构域来鉴定单个延伸单元,则较容易确定。然而,对于重复作用的酶类,往往难以预测其合成的化合物,特别是当菌株含有超过40个基因簇时。第五,自然界高度复杂,包含大量尚未被发现的化合物。生物合成过程常常是多种不同代谢途径的混合。如果新化合物尚未被鉴定,或与已知化合物无明显关联,则可能难以确定其对应的基因簇,难以提出合理的生物合成模型并加以验证。
一旦确定了基因簇,单交换技术是验证假设的一种良好且快速的方法。该方法仅需以下步骤:PCR、克隆至自杀载体、接合转移、阳性克隆筛选以及产物检测。该技术的一个缺点是,由于可能发生进一步的重组事件,载体整合到染色体中的结果并不稳定。因此,为了对单个基因进行深入分析,需要进行精确的基因敲除。此外,在遗传水平上操作链霉菌(Streptomyces)菌株可能较为困难。
所述步骤可适用于由其他化合物产生的任何产物 链霉菌属 菌株或另一种微生物。了解生物合成基因簇及其合成的化合物,为我们提供了进一步改造已有分子的机会,旨在优化这些分子以对抗多重耐药病原体。
披露
作者无任何利益冲突披露。
致谢
S. Zhang 由国家留学基金管理委员会资助。作者非常感谢此前在本实验室参与多酮霉素项目的研究人员,以及图宾根大学的 Hans-Peter Fiedler 教授,感谢其提供了多酮霉素的产生菌株。本研究得到了德国研究基金会(DFG,RTG 1976)的资助。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| 琼脂 | 卡尔罗斯特有限责任公司,德国卡尔斯鲁厄 | 5210.4 | |
| 琼脂糖 | 卡尔罗斯特有限责任公司,德国卡尔斯鲁厄 | 6352.4 | |
| D-甘露醇 | 卡尔罗特有限公司,德国卡尔斯鲁厄 | 4175.1 | |
| 葡萄糖 | 卡尔罗特有限公司,德国卡尔斯鲁厄 | 6780.1 | |
| LB | 卡尔罗特有限公司,德国卡尔斯鲁厄 | X964.3 | |
| 麦芽提取物 | 卡尔罗斯特有限责任公司,德国卡尔斯鲁厄 | X976.2 | |
| MgCl₂2 | 卡尔罗斯特有限公司,德国卡尔斯鲁厄 | 2189.1 | |
| 蛋白胨 | 卡尔罗斯特有限公司,德国卡尔斯鲁厄 | ||
| 大豆粉 | W.Schoenemberger GmbH,德国马格施塔特 | Hensec-Vollsoja | |
| 胰蛋白胨大豆肉汤 | 卡尔罗斯特有限公司,德国卡尔斯鲁厄 | X938.3 | 卡索-布依永 |
| 酵母提取物 | 卡尔罗斯特有限责任公司,德国卡尔斯鲁厄 | 2363.2 | |
| <强>溶剂 | |||
| 乙酸 | 卡尔罗斯特有限责任公司,德国卡尔斯鲁厄 | 3738.5 | |
| 丙酮 | 卡尔·罗斯有限公司,德国卡尔斯鲁厄 | 9372.2 | |
| 乙腈 | Avantor Performance Materials B.V.,荷兰代芬特尔 | JT-9012-03 | |
| 二氯甲烷 | Fisher Scientific GmbH,施韦尔特,德国 | 1530754 | |
| DMSO(二甲基亚砜) | 卡尔罗斯特有限责任公司,德国卡尔斯鲁厄 | 4720.1 | |
| DMSO-d6 (二甲基亚砜-d6) 99.9 原子百分比 D | ARMAR Chemicals, Dö瑞士,廷根 | 15200.204 | |
| 乙酸乙酯 | 卡尔·罗斯特有限责任公司,德国卡尔斯鲁厄 | 6784.4 | |
| 盐酸 | 卡尔罗斯特有限公司,德国卡尔斯鲁厄 | 6331.4 | |
| 甲醇 | 卡尔罗斯特有限公司,德国卡尔斯鲁厄 | 7342.1 | |
| <强>酶 | |||
| 限制性内切酶 | 德国法兰克福,新英格兰生物实验室有限公司 | ||
| 聚合酶 | 德国法兰克福,新英格兰生物实验室有限公司 | ||
| DNA聚合酶I大片段(Klenow片段) | Promega GmbH,曼海姆,德国 | ||
| <强>抗生素 | |||
| 阿普拉霉素 | AppliChem GmbH,德国达姆施塔特 | A7682.0005 | |
| 磷霉素 | Sigma-Aldrich Chemie GmbH,德国陶夫基兴 | P5396-50G | |
| 卡那霉素 | 卡尔罗斯特有限责任公司,德国卡尔斯鲁厄 | T832.2 | |
| <强>质粒/载体 | |||
| pKC1132 | Bierman 等 1992 | ||
| <强>引物 | |||
| pokPI_for | TGATGGTGCCGCTGGCCATGG | 扩增含 pokPI 基因片段的引物 | |
| pokPI_rev | AGCGTTCACTGTTCCGCCCGAC | ||
| <强>细菌菌株 | |||
| 枯草芽孢杆菌 COHN ATCC6051 | 革兰氏阳性测试菌株 | ||
| 大肠杆菌 ET12567 pUZ8002 | MacNeil 等 1992 | 用于接合的菌株 | |
| 大肠杆菌 XL1 Blue | Agilient Technologies,美国圣克拉拉 | 革兰氏阴性测试菌株 + 克隆宿主 | |
| Streptomyces diastatochromogenes Tü6028 | 保卢拉特 等, 1999 | 聚酮霉素生产者 | |
| <强>在线服务 | |||
| antismash(抗生素和次级代谢产物分析工具包) | http://antismash.secondarymetabolites.org/ | 次级代谢产物基因簇的检测 | |
| BLAST(基本局部比对搜索工具) | http://blast.ncbi.nlm.nih.gov/Blast.cgi | 发现生物序列之间的相似性区域 | |
| GenDB | https://www.uni-giessen.de/fbz/fb08/Inst/bioinformatik/software/gendb | 开放阅读框的注释 | |
| MiBIG(生物合成基因簇最小信息标准) | http://mibig.secondarymetabolites.org/ | 生物合成基因簇数据库 | |
| NaPDoS | http://napdos.ucsd.edu/ | 次级代谢产物基因簇的检测 | |
| NCBI 原核生物基因组注释流程 | http://www.ncbi.nlm.nih.gov/genome/annotation_prok/ | 开放阅读框的注释 | |
| NRPSpredictor | http://nrps.informatik.uni-tuebingen.de/ | NRPS结构域的检测 | |
| Prokka(快速原核生物基因组注释) | http://www.vicbioinformatics.com/software.prokka.shtml | 开放阅读框的注释 | |
| RAST(利用子系统技术的快速注释) | http://rast.nmpdr.org/ | 开放阅读框的注释 | |
| <强>其他程序 | |||
| 化学工作站版本 A.09.03 | 安捷伦科技公司,德国瓦尔德布隆 | 高效液相色谱仪操作规程 | |
| Clone Manager Suite 7 | 科学与教育软件,Cary,美国 | 设计克隆实验 | |
| Newbler v2.8 | 罗氏诊断 | 测序读段的比对 | |
| <强>机器 | |||
| Centrifuge Avanti J-6000,转子 JA-10 | Beckman Coulter GmbH,克雷菲尔德,德国 | ||
| HPLC/MS | 安捷伦科技公司,德国瓦尔德布隆 | ||
| 自动进样器:G1313A | 安捷伦科技公司,德国瓦尔德布隆 | ||
| 预柱:XBridge C18(20 mm × 4.6 mm;粒径:3.5 µm) | 安捷伦科技公司,德国瓦尔德布隆 | ||
| 色谱柱:Xbridge C18(100 mm) × 4.6 mm;粒径:3.5 μm) | 安捷伦科技公司,德国瓦尔德布隆 | ||
| _semi-prep 预柱:Zorbax B-C18(9.4 × 150 mm;粒径:5 µm) | 安捷伦科技公司,德国瓦尔德布隆 | ||
| 半制备柱:Zorbax B-C18(9.4 × 20 mm;粒径:5 µm) | 安捷伦科技公司,德国瓦尔德布隆 | ||
| 脱气装置:G1322A | 安捷伦科技公司,德国瓦尔德布隆 | ||
| 四元泵:G1311A | 安捷伦科技,德国瓦尔德布隆 | ||
| 二极管阵列检测器(DAD)G1315B(λ = 254 nm 和 400 nm | 安捷伦科技公司,德国瓦尔德布隆 | ||
| 四极杆质谱检测器(MSD)G1946D(2-3000 m/z) | 安捷伦科技公司,德国瓦尔德布隆 | ||
| 旋转蒸发仪 | |||
| 加热浴 Hei-VAP Value/G3 | Heidolph Instruments GmbH & Co.KG,德国施瓦巴赫 | ||
| 真空泵系统 SC 920 G | KNF 全球策略 AG,苏尔塞,瑞士 | ||
| <强>其他材料 | |||
| Sephadex LH20 | GE Healthcare | ||
| Chromafil PVDF-45/15MS(孔径 0.45 µ米;滤光片 Ø15 mm | MACHEREY-NAGEL GmbH & Co. KG,Dü德国 | ||
| SPE 柱 Oasis HLB 20 35 cc (6g) | Waters GmbH,埃施博恩,德国 | ||
| E. coli | 卡尔罗斯有限责任公司,德国卡尔斯鲁厄 | 培养基:LB,成分:LB,加水至1 L2O:20 g | |
| 芽孢杆菌属 | 卡尔罗斯特有限责任公司,德国卡尔斯鲁厄 | 培养基:LB,成分:LB,加水定容至1 L2O:20 g | |
| 链霉菌属 种 | 卡尔罗斯特有限责任公司,德国卡尔斯鲁厄 | 培养基:TSB,成分:CASO 肉汤,加至 1 L 水2O:30 g | |
| 真菌 | 卡尔罗斯特有限责任公司,德国卡尔斯鲁厄 | 培养基:YPD,成分:酵母提取物,加水定容至1 L2O:10 g | |
| 真菌 | 卡尔罗特有限公司,德国卡尔斯鲁厄 | 培养基:YPD,成分:蛋白胨,加水定容至1 L2O: 20 g | |
| 真菌 | 卡尔罗斯特有限责任公司,德国卡尔斯鲁厄 | 培养基:YPD,成分:葡萄糖,加水定容至1 L2O:20 g | |
| 对于琼脂平板,加入 2% 琼脂 |
参考文献
- Fleming, A. On the antibacterial action of cultures of a penicillin, with special reference to their use in isolation of B. influenzae. Br J Exp Pathol. 10 (3), 226-236 (1929).
- Lemke, A., Kiderlen, A. F., Kayser, O. Amphotericin B. Appl. Microbiol. Biotechnol. 68 (2), 151-162 (2005).
- Kirkpatrick, P., Raja, A., LaBonte, J., Lebbos, J. Daptomycin. Nat. Rev. Drug Discov. 2 (12), 943-944 (2003).
- Zakeri, B., Wright, G. D. Chemical biology of tetracycline antibiotics. Biochem. cell Biol. 86 (2), 124-136 (2008).
- Schatz, A., Bugle, E., Waksman, S. A. Streptomycin, a Substance Exhibiting Antibiotic Activity Against Gram-Positive and Gram-Negative Bacteria. Exp. Biol. Med. 55 (1), 66-69 (1944).
- Burg, R. W., et al. Avermectins, new family of potent anthelmintic agents: producing organism and fermentation. Antimicrob. Agents Chemother. 15 (3), 361-367 (1979).
- Egerton, J. R., Ostlind, D. A., et al. Avermectins, new family of potent anthelmintic agents: efficacy of the B1a component. Antimicrob. Agents Chemother. 15 (3), 372-378 (1979).
- Walsh, C. T., Fischbach, M. A. Natural products version 2.0: connecting genes to molecules. J. Am. Chem. Soc. 132 (8), 2469-2493 (2010).
- Momose, I., et al. Polyketomycin, a new antibiotic from Streptomyces sp. MK277-AF1. II. Structure determination. J. Antibiot. (Tokyo). 51 (1), 26-32 (1998).
- Paululat, T., Zeeck, A., Gutterer, J. M., Fiedler, H. P. Biosynthesis of polyketomycin produced by Streptomyces diastatochromogenes.Tü6028. J. Antibiot. (Tokyo). 52 (2), 96-101 (1999).
- Momose, I., et al. Polyketomycin, a new antibiotic from Streptomyces. sp. MK277-AF1. I. Taxonomy, production, isolation, physico-chemical properties and biological activities. J. Antibiot. (Tokyo). 51 (1), 21-25 (1998).
- Daum, M., et al. Organisation of the biosynthetic gene cluster and tailoring enzymes in the biosynthesis of the tetracyclic quinone glycoside antibiotic polyketomycin. Chembiochem. 10 (6), 1073-1083 (2009).
- Bode, H. B., Bethe, B., Höfs, R., Zeeck, A. Big effects from small changes: possible ways to explore nature's chemical diversity. Chembiochem. 3 (7), 619-627 (2002).
- Wolfender, J. -L. HPLC in Natural Product Analysis: The Detection Issue. Planta Med. 75 (07), 719-734 (2009).
- Stahl, E. Thin-layer chromatography. A laboratory handbook. , 2nd edition (1967).
- Snyder, L. R., Kirkland, J. J., Glajch, J. L. Preparative HPLC Separation. Pract. HPLC Method Dev. , 616-642 (2012).
- Granath, K. A., Kvist, B. E. Molecular weight distribution analysis by gel chromatography on sephadex. J. Chromatogr. A. 28, 69-81 (1967).
- Jackman, L. M., Sternhell, S. Application of Nuclear Magnetic Resonance Spectroscopy in Organic Chemistry. Int. Ser. Org. Chem. , (1969).
- Xian, F., Hendrickson, C. L., Marshall, A. G. High resolution mass spectrometry. Anal. Chem. 84 (2), 708-719 (2012).
- Metzker, M. L. Sequencing technologies - the next generation. Nat. Rev. Genet. 11 (1), 31-46 (2010).
- Tatusova, T., et al. Prokaryotic Genome Annotation Pipeline. NCBI Handb. 2nd Ed. , (2013).
- Angiuoli, S. V., et al. Toward an online repository of Standard Operating Procedures (SOPs) for (meta)genomic annotation. OMICS. 12 (2), 137-141 (2008).
- Aziz, R. K., et al. The RAST Server: rapid annotations using subsystems technology. BMC Genomics. 9, 75(2008).
- Overbeek, R., et al. The SEED and the Rapid Annotation of microbial genomes using Subsystems Technology (RAST). Nucleic Acids Res. 42, 206-214 (2014).
- Brettin, T., et al. RASTtk: a modular and extensible implementation of the RAST algorithm for building custom annotation pipelines and annotating batches of genomes. Sci. Rep. 5, 8365(2015).
- Seemann, T. Prokka: rapid prokaryotic genome annotation. Bioinformatics. 30 (14), 2068-2069 (2014).
- Meyer, F. GenDB--an open source genome annotation system for prokaryote genomes. Nucleic Acids Res. 31 (8), 2187-2195 (2003).
- Altschul, S. F., Gish, W., Miller, W., Myers, E. W., Lipman, D. J. Basic local alignment search tool. J. Mol. Biol. 215 (3), 403-410 (1990).
- Madden, T. The BLAST Sequence Analysis Tool. NCBI Handb. 2nd Ed. , Chapter 16 (2003).
- Marchler-Bauer, A., et al. CDD: NCBI's conserved domain database. Nucleic Acids Res. 43, (Database issue) 222-226 (2014).
- Medema, M. H., et al. antiSMASH: rapid identification, annotation and analysis of secondary metabolite biosynthesis gene clusters in bacterial and fungal genome sequences. Nucleic Acids Res. 39, (Web Server issue) 339-346 (2011).
- Blin, K., et al. antiSMASH 2.0--a versatile platform for genome mining of secondary metabolite producers. Nucleic Acids Res. 41, (Web Server issue) 204-212 (2013).
- Weber, T., et al. antiSMASH 3.0 - a comprehensive resource for the genome mining of biosynthetic gene clusters. Nucleic Acids Res. 43, (W1) 237-243 (2015).
- Ziemert, N., et al. The natural product domain seeker NaPDoS: a phylogeny based bioinformatic tool to classify secondary metabolite gene diversity. PLoS One. 7 (3), 34064(2012).
- Rausch, C., Weber, T., Kohlbacher, O., Wohlleben, W., Huson, D. H. Specificity prediction of adenylation domains in nonribosomal peptide synthetases (NRPS) using transductive support vector machines (TSVMs). Nucleic Acids Res. 33 (18), 5799-5808 (2005).
- Röttig, M., et al. NRPSSpredictor2--a web server for predicting NRPS adenylation domain specificity. Nucleic Acids Res. 39, (Web Server issue) 362-367 (2011).
- Medema, M. H., et al. Minimum Information about a Biosynthetic Gene cluster. Nat. Chem. Biol. 11 (9), 625-631 (2015).
- Mullis, K., et al. Specific enzymatic amplification of DNA in vitro: the polymerase chain reaction. Cold Spring Harb. Symp. Quant. Biol. 51, Pt 1 263-273 (1986).
- Bierman, M., et al. Plasmid cloning vectors for the conjugal transfer of DNA from Escherichia coli to Streptomyces spp. Gene. 116 (1), 43-49 (1992).
- Froger, A., Hall, J. E. Transformation of plasmid DNA into E. coli.using the heat shock method. J. Vis. Exp. (6), e253(2007).
- Bimboim, H. C., Doly, J. A rapid alkaline extraction procedure for screening recombinant plasmid DNA. Nucleic Acids Res. 7 (6), 1513-1523 (1979).
- MacNeil, D. J., et al. Analysis of Streptomyces avermitilis. genes required for avermectin biosynthesis utilizing a novel integration vector. Gene. 111 (1), 61-68 (1992).
- Pospiech, A., Neumann, B. A versatile quick-prep of genomic DNA from Gram-positive bacteria. Trends Genet. 11 (6), 217-218 (1995).
- Makitrynskyy, R., et al. Pleiotropic regulatory genes bldA, adpA and absB are implicated in production of phosphoglycolipid antibiotic moenomycin. Open Biol. 3 (10), 130121(2013).
- Kalan, L., et al. A cryptic polyene biosynthetic gene cluster in Streptomyces calvus is expressed upon complementation with a functional bldA gene. Chem. Biol. 20 (10), 1214-1224 (2013).
- Gessner, A., et al. Changing Biosynthetic Profiles by Expressing bldA in Streptomyces Strains. ChemBioChem. 16 (15), 2244-2252 (2015).
重印与许可
